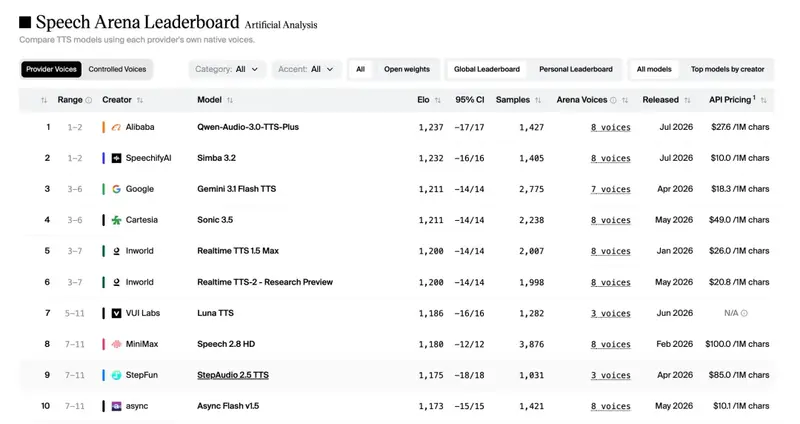
由前 MiniMax 技术合伙人杨斌创立的 BreezeBlue 正式开源了 Breeze-TTS-2。这是一个专为实时语音交互设计的开放权重文本转语音(TTS)模型,在 Artificial Analysis TTS 排行榜的开放权重类别中位居榜首,并在多项指标上超越了前沿的专有系统。它不仅支持中英双语,更将声音克隆、自然语言声音设计、情感引导与超低延迟流式生成整合于单一模型中。
- GitHub:https://github.com/breezeblue-ai/breeze-tts
- 模型:https://huggingface.co/BreezeBlue/Breeze-TTS-2
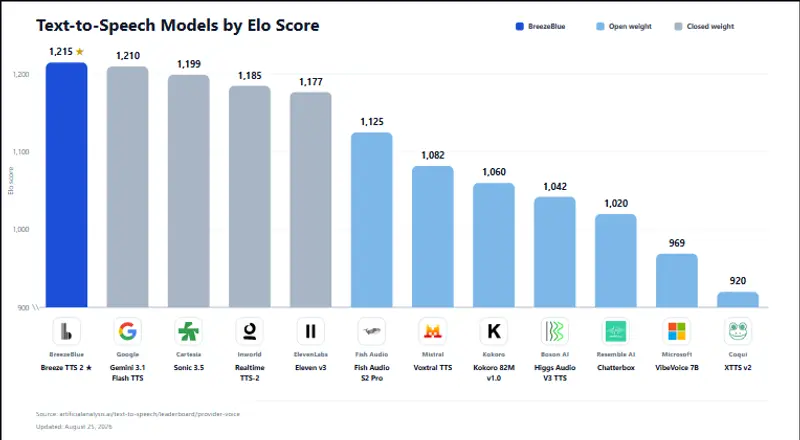
核心亮点
- 声音克隆 (Voice Cloning):仅需一段清晰的真人录音及其对应转录文本,即可精准复刻音色、节奏、情感与风格。
- 声音设计 (Voice Design):无需参考音频,直接通过自然语言描述(如“一个声音温暖、语气平静的年轻女生”)生成全新的独特声音。在 TTS 声音设计基准测试中,角色契合度评分高达 78.02,声音多样性达 708,均位列第一。
- 声音引导 (Voice Steering):在克隆声音的基础上,通过自然语言指令或内联标签实时调整语调、情感、语速和表达方式,同时保持声音的可辨识性(SIM 评分 0.67)。
- 内联声音事件:支持在文本中直接插入表达性动作。英文使用圆括号
(laugh)、(sigh);中文使用方括号[笑]、[叹气],模型会真实演绎这些非语言声音。 - 极致低延迟与流式传输:
- 在 NVIDIA H100 上,首帧音频时间 (TTFA) 低于 40ms。
- 实时因子 (RTF) 达 0.32,生成速度约为实时的 3.1 倍。
- 支持 WebSocket 实时流式 API,文本追加即开始回传 PCM 音频流。
- GPU 高效:Eager 推理仅需约 7.7 GiB 显存,最低推荐配置为 12GB GPU。
- 多语言支持:单模型原生支持中英文,并扩展至 50 种语言,具备口音控制能力。
为什么 Breeze-TTS-2 与众不同?
传统 TTS 评估多聚焦于“自然度”,而 Breeze-TTS-2 针对实时交互体验重新定义了标准:
| 维度 | 传统 TTS | Breeze-TTS-2 |
|---|---|---|
| 声音来源 | 依赖预设库或单一克隆 | 自然语言设计 + 克隆 + 引导三位一体 |
| 表演控制 | 有限的情感标签 | 自然语言指令 + 内联事件,细粒度控制 |
| 延迟 | 秒级响应 | <40ms TTFA,RTF 0.32,对话级流畅 |
| 应用场景 | 内容创作、有声书 | 游戏 NPC、语音伴侣、实时代理、互动故事 |
BreezeBlue 还同步开源了声音设计、声音引导和延迟三大基准测试,填补了行业在交互式语音评估方面的空白,推动社区从“听起来自然”向“用起来生动”演进。
© 版权声明
文章版权归作者所有,未经允许请勿转载。