小红书旗下FireRedTeam发布通用音频语言模型 FireRedAudio。它以90亿参数的LLM作为共享主干,创新性采用解耦连续表示架构,把音频识别理解、语音生成编辑能力放进同一个模型当中,解决了长期以来音频理解与语音生成对特征截然不同的需求矛盾。
- 项目主页:https://fireredteam.github.io/demos/fireredaudio
- GitHub:https://github.com/FireRedTeam/FireRedAudio
- Hugging Face:https://huggingface.co/FireRedTeam/FireRedAudio
- 魔搭:https://www.modelscope.cn/models/FireRedTeam/FireRedAudio
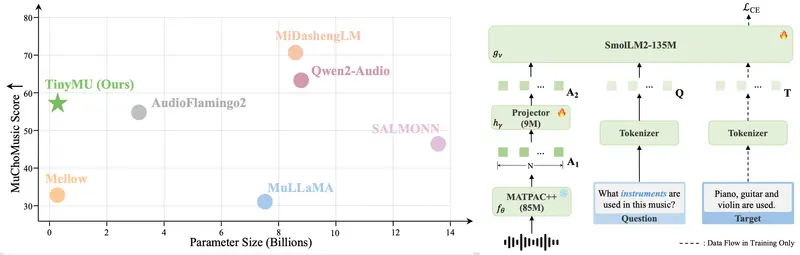
音频理解任务,例如语音转文字、音频内容分析,偏向需要高度压缩、适合长上下文的特征;而语音生成任务则必须保留丰富细腻的声学细节。以往很多方案需要两套独立模型分别处理,FireRedAudio则在同一个自回归大模型内部开辟两条互不干扰的输入通道:一条音频编码器路径负责音频理解;另一条RedAE‑Patch路径专门面向语音生成,两条表征互不融合,但是共用同一套语言推理主干。
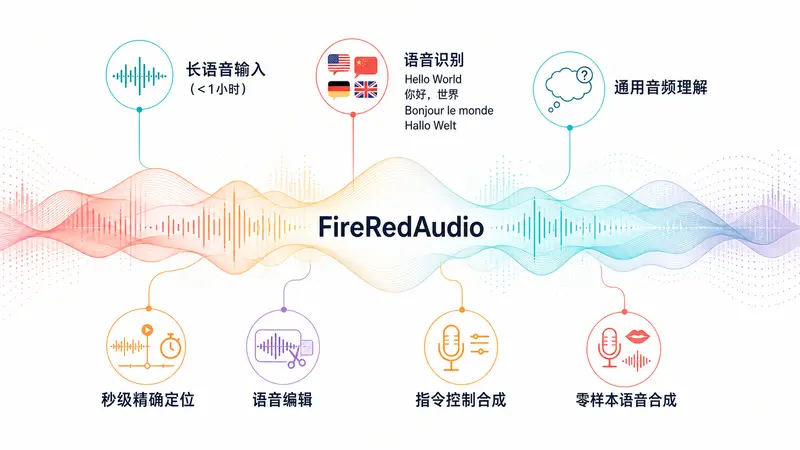
模型具备的全套音频能力
- 长音频理解与语音识别
支持自动语音识别ASR,音频内容分析,最长可处理一小时时长录音。音频内容会被拆解成带有时间戳的结构化条目,做到秒级精度对齐。无论是5‑50分钟的访谈录音、播客素材,都可以生成带时间标记的摘要,快速检索指定时间段的内容。 - 多模式语音生成
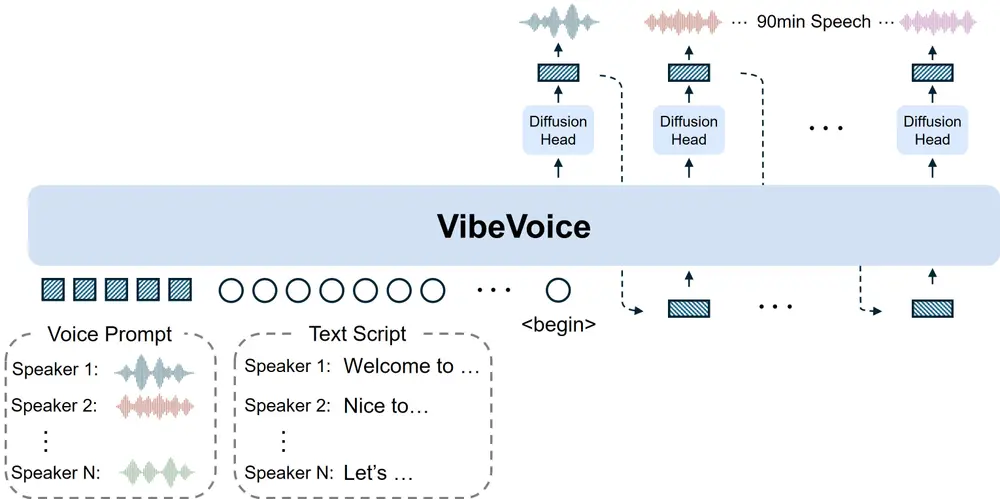
具备零样本语音克隆TTS,以及指令驱动语音合成。你可以用自然语言直接控制音色、情绪、语速、音量,模型遵循文字指令生成对应的语音。 - 语义+声学双维度语音编辑
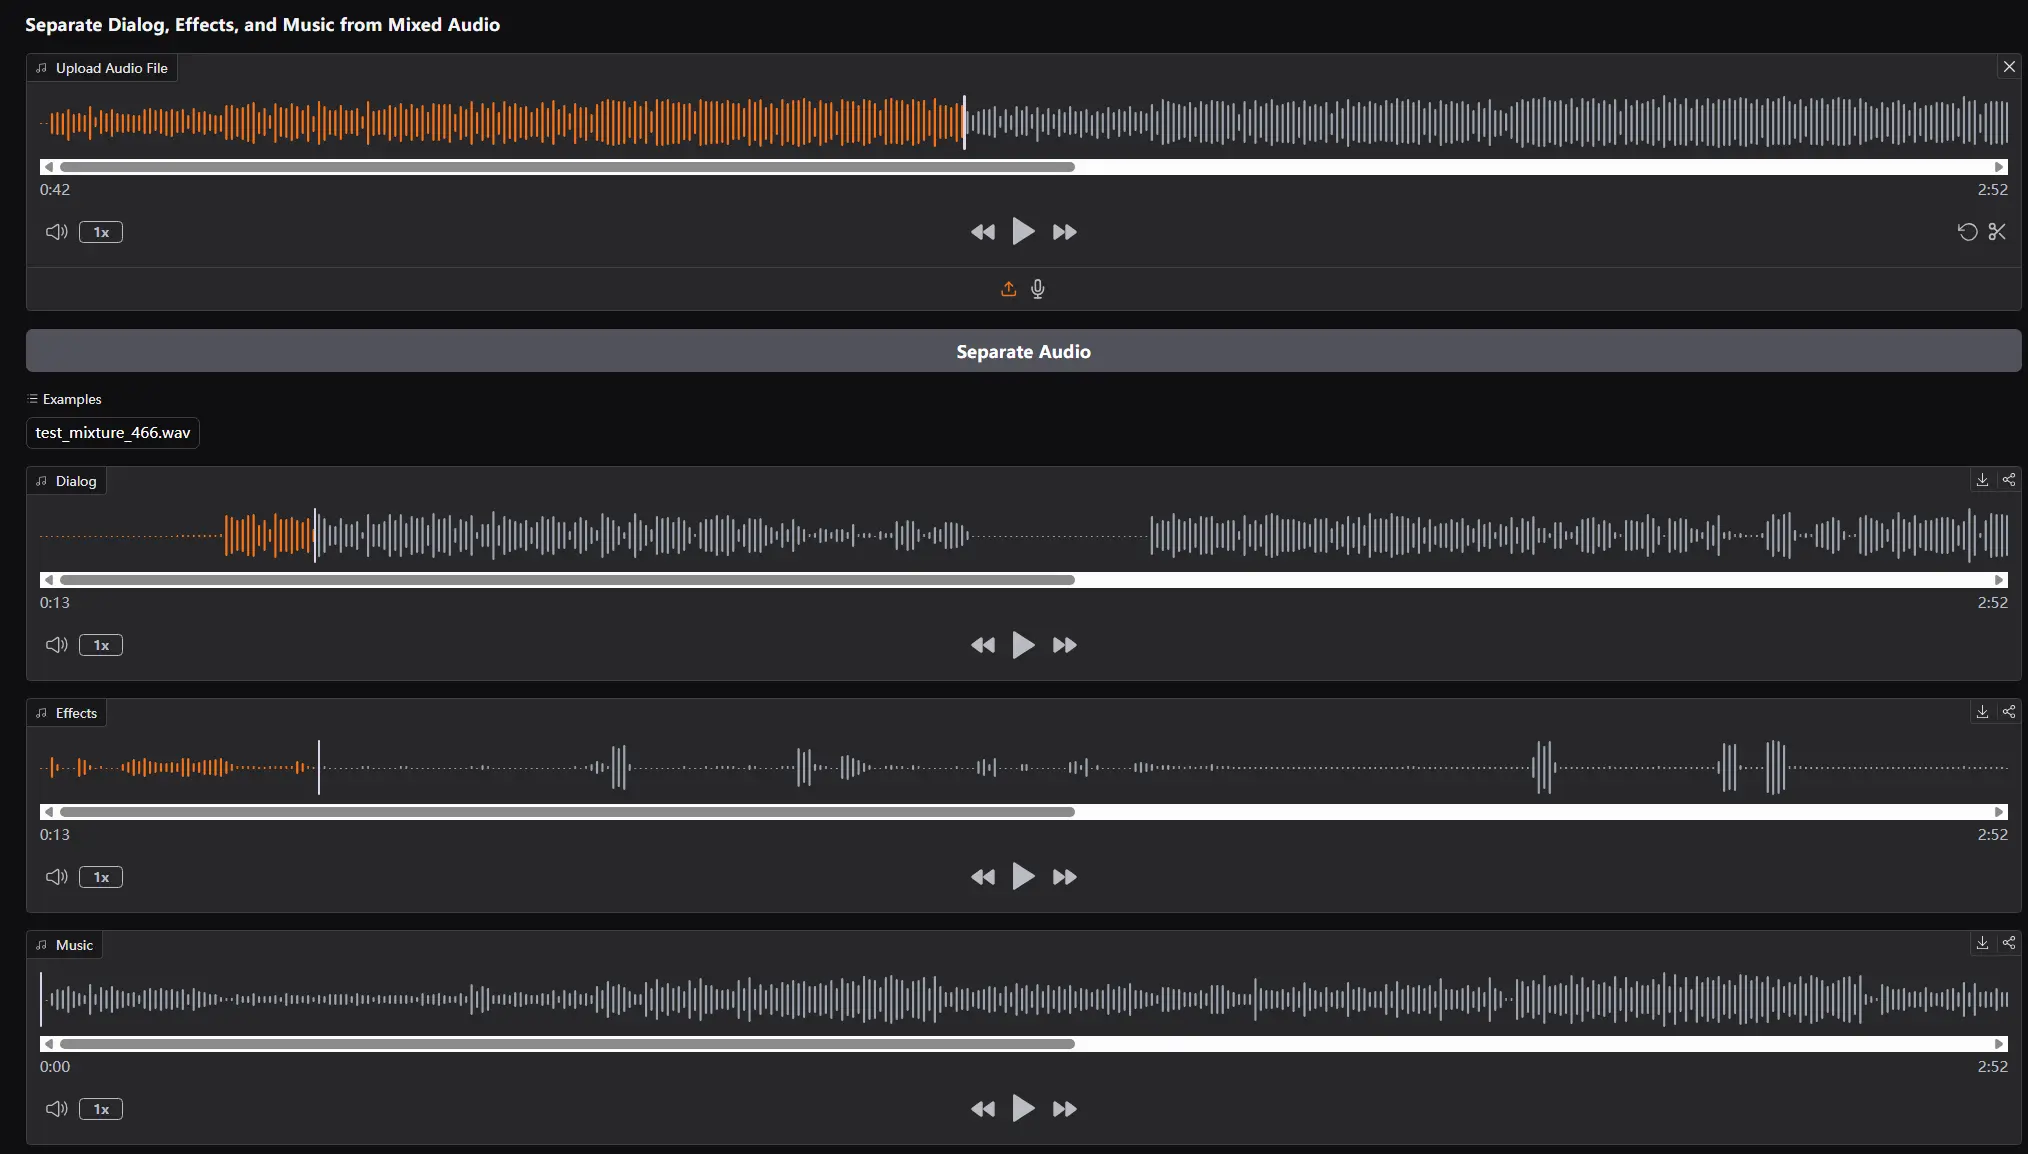
依托流匹配DiT生成连续声学潜空间,既可以修改语音文字内容,也能调整音色、情感等声学特征。对比Ming‑UniAudio‑Edit基线模型,语音编辑效果获得明显提升。
四大核心创新贡献
解耦的双路径连续音频表征
在统一LLM内部为理解、生成分别设置独立编码器通道,两条路径表征分开,共享推理主干,该架构属于业内首次公开披露。
一站式覆盖完整音频任务栈
单一模型完成ASR、音频理解、零样本TTS、指令TTS、自由语音编辑。在MMAU、MMSU、Seed‑TTS‑Eval等多项公开评测基准上取得领先或第一梯队成绩。
自然语言可控的语音生成与编辑
不再需要复杂参数调节,直接用文字描述修改语音效果,降低语音后期编辑门槛。
小时级长音频秒级时间对齐
一小时录音素材实现结构化切片,时间戳误差控制在1秒以内,对于播客、会议纪要、访谈录音场景实用性很强。
对于创作者、播客运营、会议记录、有声内容生产而言,FireRedAudio代表着一条新路线:未来只用一个音频模型,就能够完成录音转写‑内容分析‑语音生成‑音频后期编辑的整条工作流。
© 版权声明
文章版权归作者所有,未经允许请勿转载。