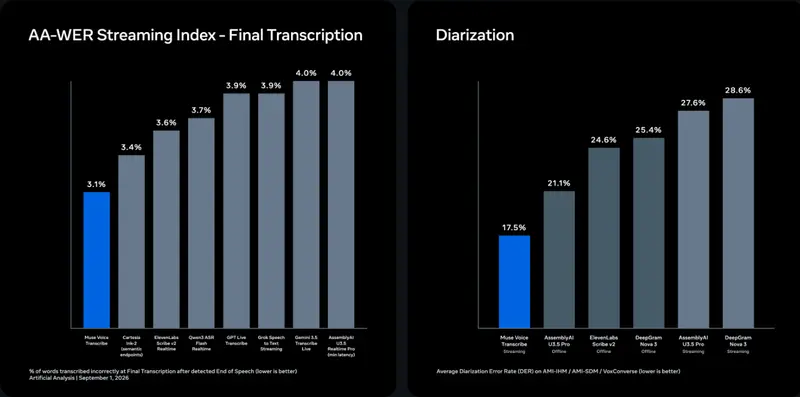
Meta超智能实验室(MSL)正式推出旗下第一款面向实时音频感知的大模型——Muse Voice Transcribe。作为Muse Spark家族一员,这款模型把流式语音识别、多人说话人区分、语音端点检测三大能力融为一体,支持70余种语言训练,双语自由切换,长音频下可同时识别20位以上发言人,多项基准榜单登顶第一,标志着Meta实时语音模型赛道迈出关键性一步。
- 官方介绍:https://research.meta.ai/blog/introducing-muse-voice-transcribe
全新自回归流式架构,自适应延迟平衡速度与准确率
市面上多数流式语音转写方案,往往采用固定分块、缓存等待的方式处理音频,延迟与精度很难两全。
Muse Voice Transcribe采用一套创新的令牌交互机制。音频被切割成80毫秒的数据块,每一块转化为一枚软令牌送入模型。模型拥有自主决定权:既可以输出<|next_audio|>令牌,选择继续收下一段音频素材,扩充上下文;也可以直接输出文字结果。当音频数据流结束,系统下发<|empty_audio|>结束标记,模型便把剩余所有文字一次性输出。
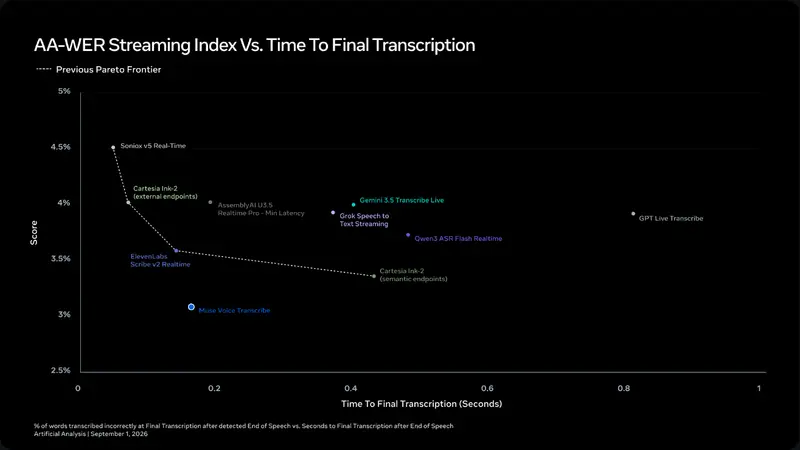
最核心的亮点就是自适应延迟机制。借助强化学习训练,模型会根据当前语音内容难度,动态决定等待多久再输出文字。简单短句立刻给出结果,语义复杂、发音模糊的片段就多收集一点音频上下文。词错误率与延迟两项指标做加权平衡,最终在速度‑精度的取舍上达到帕累托最优,相比传统固定延迟方案拥有明显优势。
一套主干模型,同时搞定转写、话者分离、端点检测
该模型没有采用多个独立子模型拼接的思路,而是在流式语音识别主干之上,通过新增特殊令牌实现附加音频任务,三项能力联合训练,无需分开推理。
在说话人切换识别上,<|start_of_turn|>标记一轮对话的开始,再搭配speaker_A‑Z标签区分不同发言人。即便是同一个人被短暂停顿切分成多段,标签也能够保持一致,不会错误判定成新参与者。模型原生支持最多20人以上的长对话场景,一小时以上会议录音也无需额外后处理。
端点检测则依靠<|speech_onset|>、<|speech_endpoint|>标记,精准捕捉人声开始、话音结束的时间节点,非常适合语音助手、实时通话等场景。
核心能力一览
超广语言覆盖
训练语种总数超过70种,其中25门语言经过深度验证优化。正式使用优先推荐这25种语言,剩余语种也具备识别能力。
原生支持语码切换
对于双语使用者,模型无需提前告知切换时机,可以流畅识别句内、句间的语言跳转。同时支持关键词、上下文偏置,通过提供参考词库进一步降低专业术语、专有名词的识别错误。
超长音频上下文
单次会话可承载一小时以上音频,全程保留对话历史,多人身份不会混淆丢失。
落地场景与开放渠道
目前Meta AI、Muse Code的语音听写功能已经切换为这款模型提供底层能力。在Mac端,用户按住Fn快捷键,即可唤起语音听写,跨窗口完成语音指令任务。
开发者与企业使用者现在可以经由 Meta Model API、Meta AI for Mac、Muse Code三个渠道接入Muse Voice Transcribe。从线上实时会议字幕、直播语音转写、多语种通话录音、远程客服会话,到本地PC端语音助手,都可以依托这套实时音频模型搭建应用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。