继推出Marble空间引擎之后,李飞飞创立的World Labs正式发布下一代多模态世界模型 Atlas。不同于普通文生视频工具,Atlas从底层架构就面向空间智能打造,原生打通文本、图像、视频、三维几何数据,既能精准生成带可控相机轨迹的长视频,也可以仅凭少量照片重建出完整的3D实景,为影视创作、机器人仿真、虚拟场景搭建打开了全新的技术路径。
- 官方介绍:https://www.worldlabs.ai/blog/atlas
- 申请地址:https://form.typeform.com/to/zHFR4r3A
什么是世界模型,Atlas又有何不同
世界模型的核心目标,是让AI理解现实世界的运行规律,看清物体、空间、运动之间的因果关系,最终实现场景生成、实景重建以及环境仿真模拟。
市面上绝大多数图像、视频生成模型,输出画面时并不理解镜头背后真实的三维几何。而 Atlas 采用多模态自回归扩散Transformer架构,创新性引入「空间上下文」。所有输入图像都会绑定它在三维空间当中对应的相机位置。模型不再只是生成一张张孤立的图片,而是在大脑内部构建出一个连贯、统一的虚拟世界,后续所有新视角、新帧的生成都以此空间底座作为基准。
Atlas性能具备可扩展性,能力将随着训练算力、数据集规模的提升持续增长。未来这款模型也将作为底座,驱动World Labs旗下Marble以及其他产品线迭代升级。
四大核心能力,覆盖生成‑重建‑仿真全链路
1、像素级精确相机控制,生成最长一分钟1440p可控视频
相机控制生成是Atlas最亮眼的能力。普通视频生成工具只能依靠文字模糊描述镜头运动,经常出现镜头漂移、场景崩坏。
Atlas可以直接接收精确的相机几何参数作为输入,用户提前规划好完整相机路径,模型就沿着这条轨迹平稳运动,输出连贯画面。
仅仅一张参考图,AI就能够推理出画面之外看不见的场景内容,自动补全物体背面、远处环境等信息。你还可以把多张毫不相干的图片放置在三维空间上下文当中,Atlas会自动生成走廊、通道等过渡场景,把独立画面无缝拼接成同一个世界。
视频能力上限可达 1分钟时长、1440P分辨率。创作者不再靠碰运气抽帧生成视频,而是像导演一样,主动布置场景、规划镜头路线。
2、稀疏图像即可完成实景3D重建,效果超越专用重建模型
从少量照片还原三维场景一直是计算机视觉领域长期存在的难题。过去想要高精度重建环境,往往需要几十上百张密集采样图像,外加深度相机、激光雷达等硬件设备。
Atlas跳出专用重建算法的思路,仅凭1‑3张地面拍摄照片,就可以还原整片场景,并且生成鸟瞰视角等从未被镜头捕捉过的画面。输入图像越多,模型脑补的内容就越少,重建精度越高;最多也能够接纳上百张视图,复刻大型真实环境。
重建完成后模型可输出显式三维数据,包含深度图、点云以及3D高斯泼溅场景文件。输出成果可以直接导入游戏引擎、可视化工具实时渲染,和Marble产品生态完全打通。
以斯坦福主方庭重建案例为例,少量地面实拍照片,就能生成高空俯瞰的飞行镜头。
3、时空模拟:视频重构图与机器人Real‑to‑Sim仿真
Atlas同时掌握空间与时间演化规律,这项能力衍生出两大落地方向。
第一是影视视觉特效。只用3‑5台普通手机相机拍摄素材,模型就可以冻结时间,生成子弹时间效果,切换到现实拍摄无法抵达的镜头角度。低成本实现多机位、多角度镜头重构。
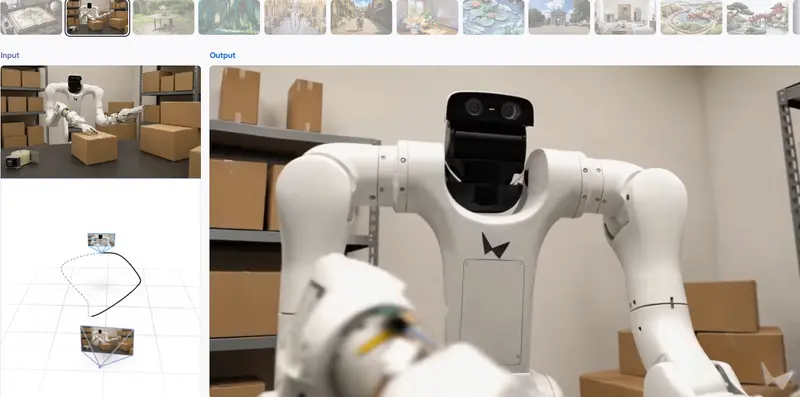
第二是机器人仿真训练。使用手机录制几段环境视频,Atlas便可重建完整三维空间。随后模拟机器人在环境当中移动,实时渲染机器人机载摄像头看到的RGB图像与深度画面。还能够修改物体摆放位置、光照条件,批量生成多样化仿真训练数据集,大幅降低机器人现实训练成本。
4、图像与全景图生成
图像生成并不是Atlas的主攻方向,但模型同样具备不俗实力,支持复杂提示词生成图片、精准渲染画面内文字,还能够一键产出360°全景场景素材,服务虚拟空间创作。
底层技术架构解析:专为空间智能重构Transformer
Atlas选择了一条区别于大语言模型、普通视频生成模型的全新路线,完整架构为多模态自回归扩散Transformer。
- 多模态:原生接收文本、图像、相机姿态、深度图,视频被解析成带空间标记的图像序列;
- 自回归:序列式逐一生成内容,前面生成的帧作为后续生成的上下文;
- 整流流扩散:通过逐步去噪产出高维视觉画面,可以灵活调整推理步数平衡速度与画质;
- Transformer主干:适配大规模算力加速,兼容KV缓存等LLM成熟优化方案。
空间上下文是整套架构最核心的创新点,每一张图像附带相机姿态,所有视觉元素被锚定在三维坐标系中,从根源减少镜头移动过程当中场景漂移、物体变形崩坏等问题。
定量基准结果:双赛道超越专用模型
团队选取两大高难度任务完成量化测评。
在相机轨迹跟随测试当中,Atlas接收单张图像与预设相机路径。第三方人工评审结果显示,它跟随镜头路线的效果优于当下主流视频生成模型,相机轨迹越复杂,领先优势越明显。
稀疏视图3D重建任务下,即便Atlas属于全能型世界模型,重建精度依旧超过市面上最优的开源专用重建模型。
现阶段进展与落地通道
目前Atlas并未全面对外开放,项目正处于精选合作伙伴早期访问阶段,开发者、企业团队可以提交申请获取接入资格。
长远来看,可控长视频创作、影视虚拟制片、实景三维重建、机器人仿真训练、游戏关卡快速生成都将是这款世界模型重要的应用场景。随着后续模型规模进一步扩张,空间世界模型所能模拟的环境复杂度还将迎来新一轮跃升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。