Reso-1:基于 Eleven Labs 声音蒸馏的开源情感 TTS 模型Decibel Labs 正式开源了 Reso-1,这是一款具有高度表现力、支持流式传输且可在本地运行的文本转语音(TTS)模型。作为其首个语音模型,Reso-1 通过对 Eleven Labs 的 ...语音模型# Eleven Labs# Reso-14个月前1590
Zyphra 发布 ZONOS2:首个开源 MoE 架构实时 TTS 模型,支持 600 万小时多语言数据训练与高保真语音克隆,Apache 2.0 协议免费商用Zyphra 正式发布了其最新的文本转语音(TTS)模型 ZONOS2。作为首个采用 混合专家(MoE) 架构的开源实时 TTS 模型,ZONOS2 在超过 600 万小时 的多语言语音数据上训练,不...语音模型# ZONOS2# Zyphra5个月前3020
谷歌发布 Gemini 3.5 Live Translate:支持 70+ 语言流式语音互译,保留原声语调与节奏,集成于 Meet、翻译 App 及实时 API,打造低延迟跨语言沟通体验谷歌正式推出了 Gemini 3.5 Live Translate,一款专为实时语音到语音翻译设计的先进音频模型。它不再局限于传统的文本中转或回合制交互,而是通过连续流式处理技术,在说话者发声的同时即...早报语音模型# Gemini 3.5 Live Translate# 实时翻译# 谷歌5个月前2060
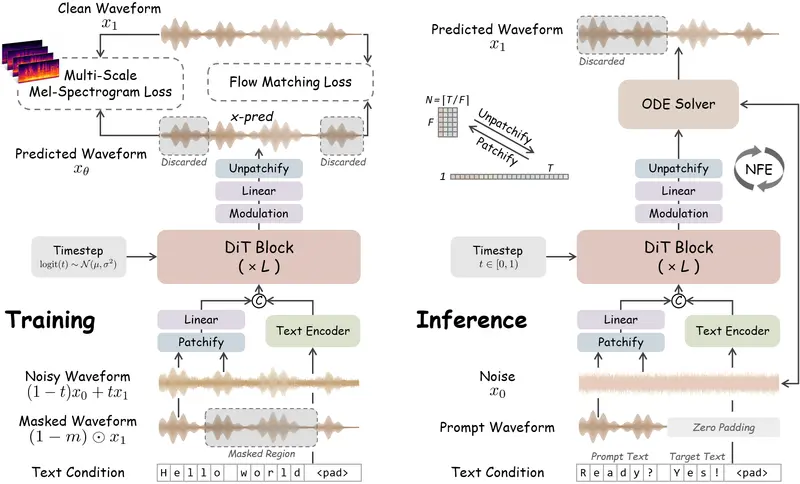
WavTTS:首个高性能零样本原生波形 TTS,基于流匹配与 DiT 直接生成原始音频,摒弃梅尔频谱与声码器,中英双语性能比肩 SOTA上海交大、上海创新研究院与字节跳动 Seed 团队联合发布了 WavTTS,这是首个在性能上显著缩小与主流隐空间/梅尔谱模型差距的端到端零样本原始波形 TTS 框架。WavTTS 基于流匹配(Flow...语音模型# TTS# WavTTS5个月前2140
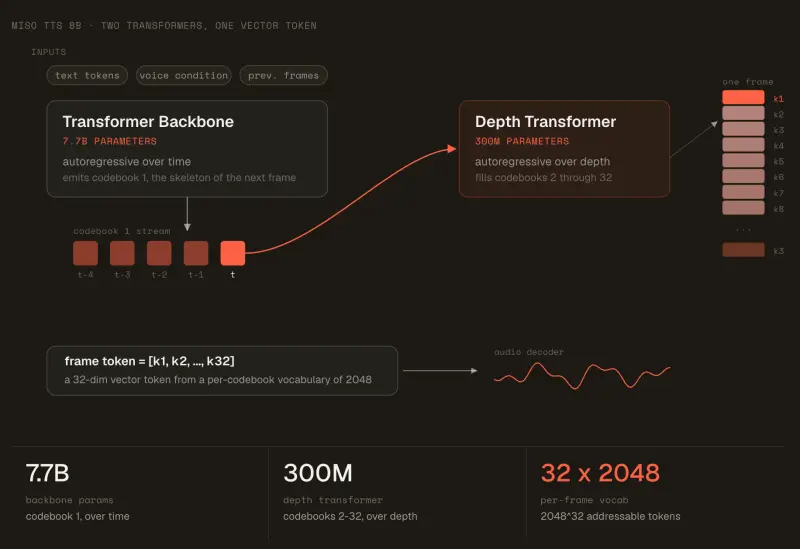
Miso Labs 开源 MisoTTS:80亿参数情感文本转语音模型,采用残差向量量化(RVQ)实现 10¹⁰⁵ 可寻址音色,延迟低至 110msMiso Labs 正式发布了 MisoTTS,一款拥有 80 亿参数的开源文本转语音(TTS)模型。作为首款采用残差向量量化(RVQ)技术的开放权重 TTS 模型,MisoTTS 不仅实现了低至 1...语音模型# Miso Labs# MisoTTS5个月前2040
ElevenLabs 发布 Dubbing v2:首次实现跨语言情感与表演保留,直接基于原始音频建模而非文本转录,支持 90+ 语言自然配音ElevenLabs 正式发布了其革命性的全新 AI 配音模型 —— Dubbing v2。这是业界首次实现将原说话人的情感、语调、节奏及表演意图完整传递到每一种目标语言中。通过直接基于原始表演进行条...早报语音模型# Dubbing v2# ElevenLabs5个月前2080
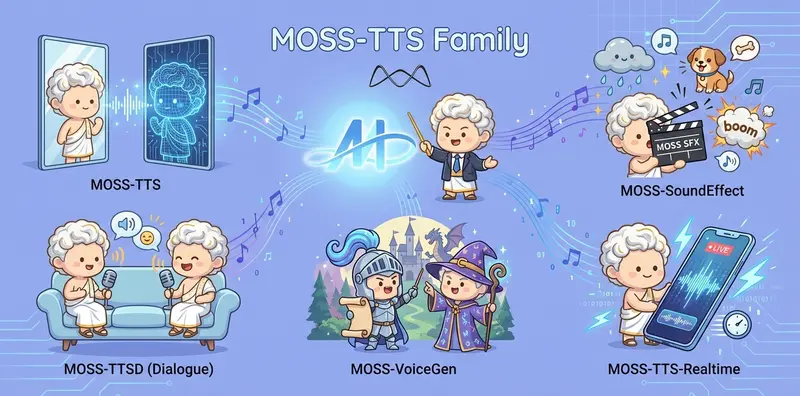
MOSS-SoundEffect v2.0 发布:基于 DiT + 流匹配架构,支持中英双语提示生成 30 秒高保真 48kHz 音效MOSI.AI 与 OpenMOSS 团队正式发布了 MOSS-SoundEffect v2.0,这是一款全新的文本到音频(Text-to-Audio, TTA)模型。作为 MOSS-TTS 系列中专...语音模型# MOSS-SoundEffect v2.05个月前2460
MOSS-TTS v1.5 发布:支持 31 种语言与显式停顿控制,零样本克隆更稳定,首字节延迟低至 180ms在 AI 语音合成领域,单一模型往往难以同时满足高保真度、长文本稳定性、多角色对话及实时交互等复杂需求。MOSS-TTS 系列由 MOSI.AI 与 OpenMOSS 团队 联合开发,通过将工作流拆分...语音模型# MOSI.AI# MOSS-TTS v1.5# OpenMOSS5个月前4180
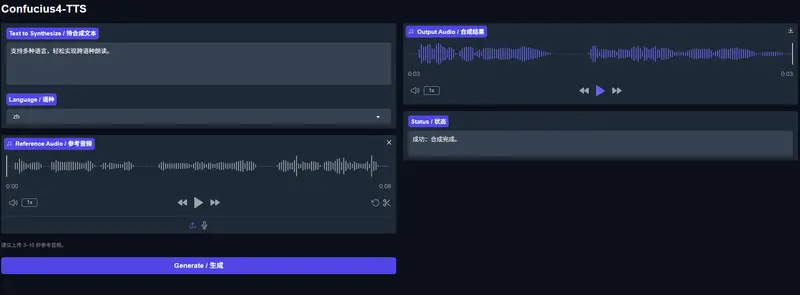
网易有道发布 Confucius4-TTS:支持 14 种语言零样本跨语种克隆,音色与情感无缝迁移网易有道正式推出 Confucius4-TTS,这是一款基于大语言模型(LLM)架构的先进文本转语音系统。它专为多语种和跨语种语音合成设计,实现了“一种音色,任意语言”的愿景。 项目主页:https...语音模型# Confucius4-TTS# 网易有道1个月前2100
Stability AI 开源 Stable Audio 3:支持 6 分钟可变长度生成与音频修复,M4 Mac 即可流畅运行Stability AI 正式推出 Stable Audio 3,这是新一代超快文本生成音频/音乐模型家族。该系列包含 small、medium 和 large 三个版本,基于创新的语义-声学自编码器...语音模型# Stability AI# Stable Audio 35个月前2770
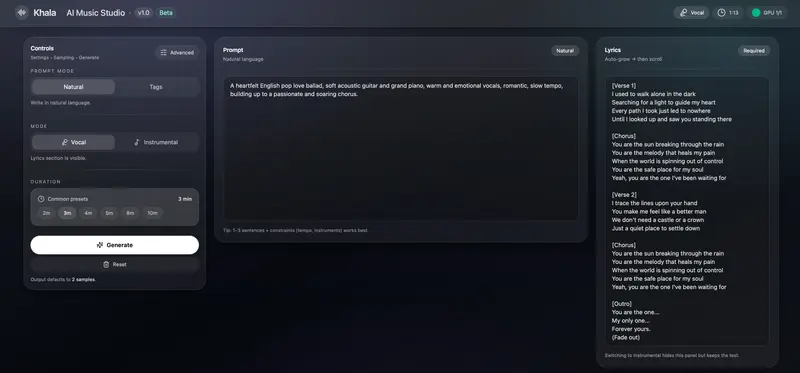
中央音乐学院与清华大学联合推出Khala:基于统一声学词元的高保真歌曲生成系统,开源且支持完整人声伴奏对齐在 AI 音乐生成领域,长期存在“结构混乱”、“音质失真”及“歌词不同步”三大痛点。传统方案往往将旋律生成与音质渲染割裂,导致最终作品缺乏连贯性与真实感。Khala 是由中央音乐学院与清华大学研究人员...语音模型# Khala# 音乐模型5个月前3660
Scenema Audio:基于 LTX 2.3 的零样本表现力语音克隆,分离身份与情感,实现“表演级”音频生成传统文本转语音(TTS)系统往往局限于将文字转换为单调的声音,缺乏真实人类交流中的情感起伏与意图表达。Scenema Audio是一款从 LTX 2.3 视听模型中提取的音频扩散模型,旨在实现真正的...语音模型# LTX-2.3# Scenema Audio6个月前2640