OpenAI 发布三大实时语音模型:GPT-Realtime-2 具备 GPT-5 级推理能力,支持实时翻译与流式转录语音交互正在从简单的指令识别迈向复杂的自然对话与任务执行。OpenAI 今日在 API 中正式推出三款全新的音频模型——GPT-Realtime-2、GPT-Realtime-Translate 和 ...早报语音模型# GPT-Realtime-2# GPT-Realtime-Translate# GPT-Realtime-Whisper6个月前2030
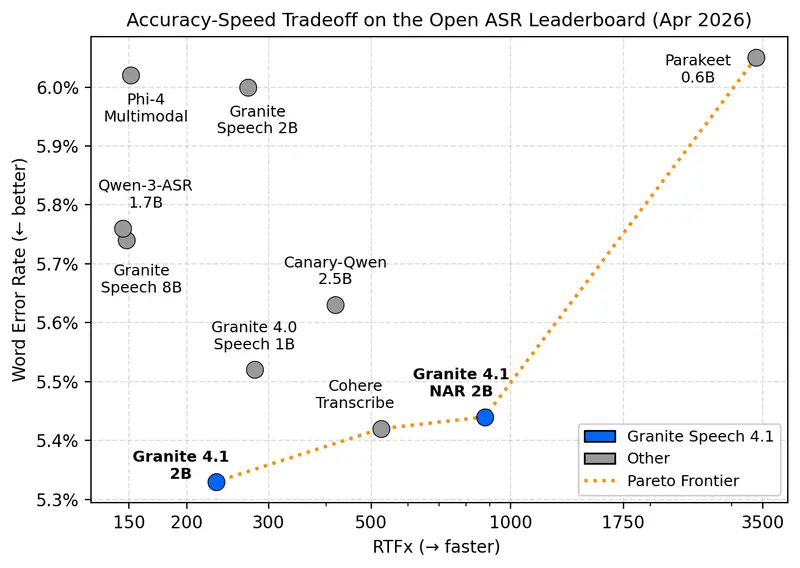
IBM 发布 Granite Speech 4.1 2B:开源、高效、多语言的新一代语音识别模型,支持多语言 ASR 与语音翻译在企业级自动语音识别(ASR)领域,开发者常面临两难选择:要么使用计算量巨大的高精度模型,要么为了控制预算而牺牲准确性。 IBM 发布的 Granite Speech 4.1 2B 系列模型,这套包含...语音模型# Granite Speech 4.1 2B# IBM6个月前1780
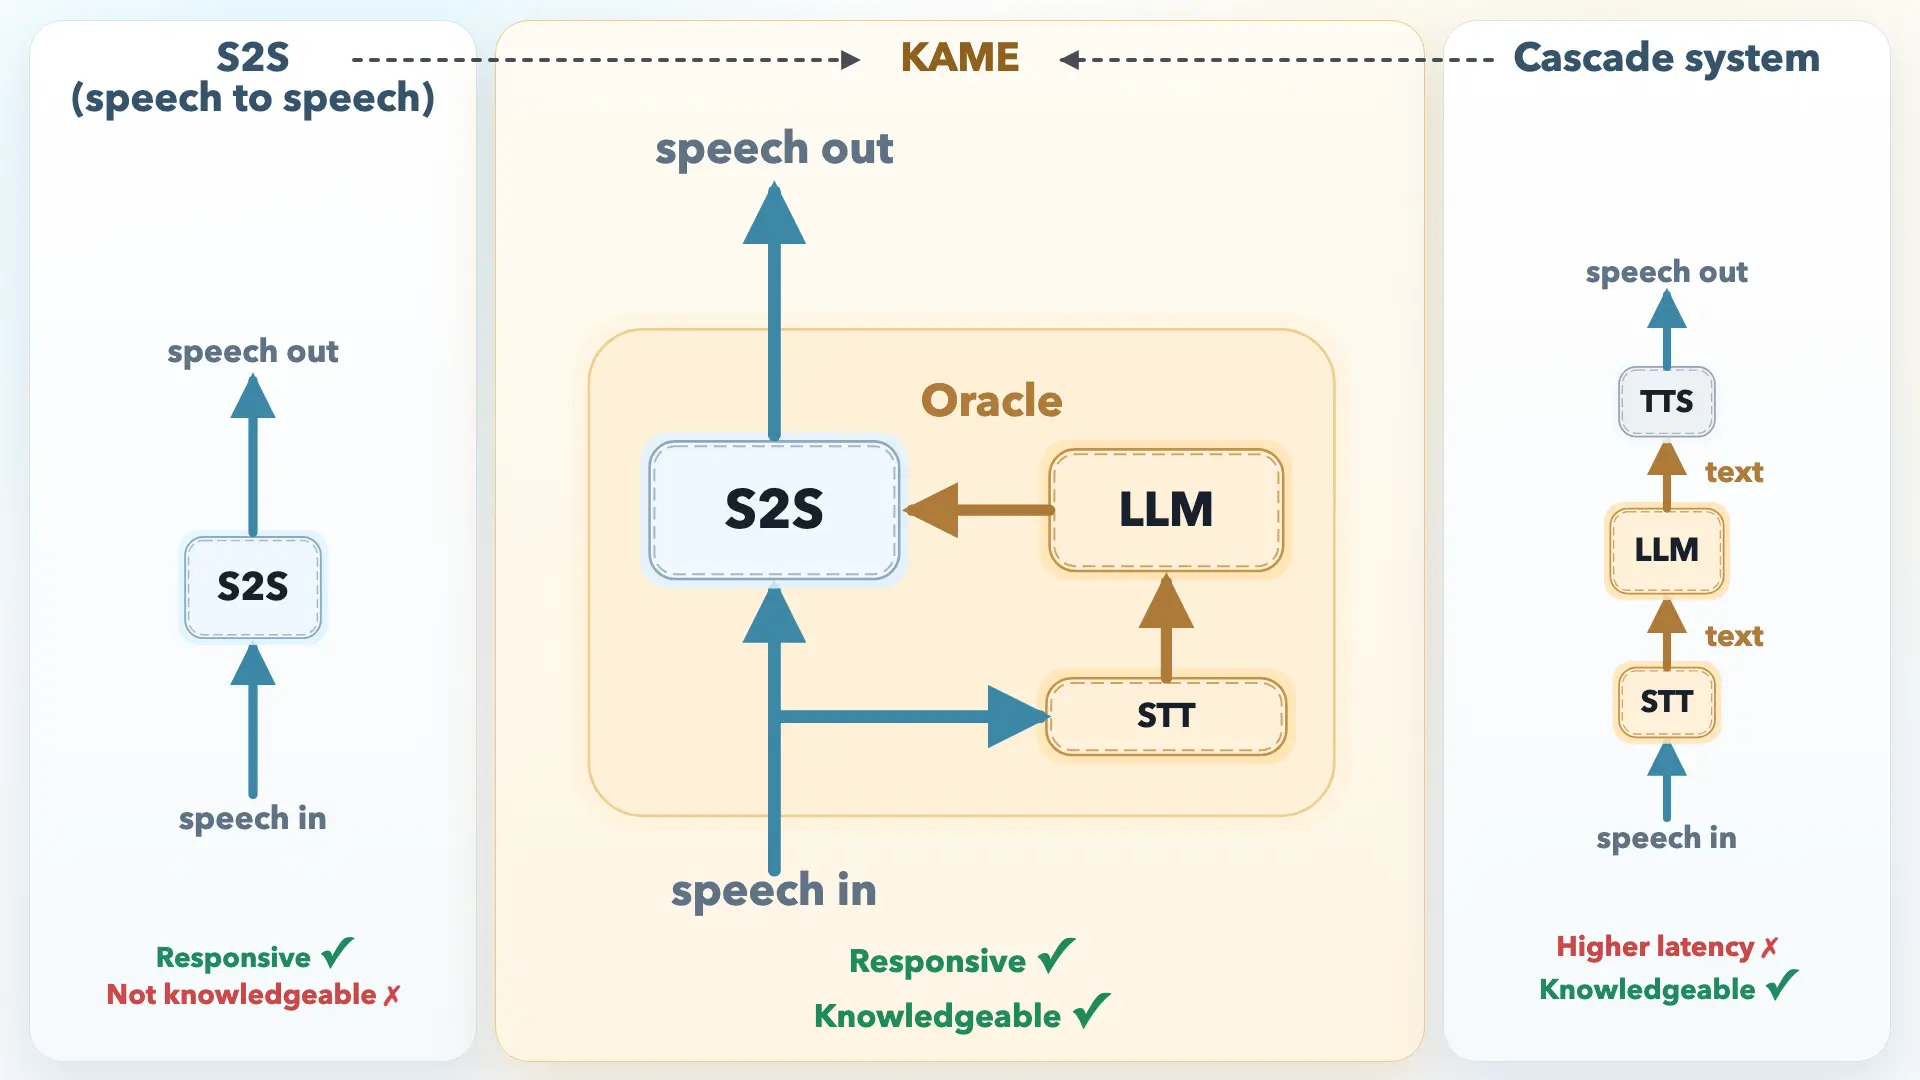
Sakana AI 发布 KAME:打破“快与智”悖论,实现零延迟且高智商的实时语音对话架构在对话式 AI 领域,开发者长期面临一个残酷的二元选择:要么选择极速响应但知识浅薄的直接语音到语音(S2S)模型,要么选择知识渊博但延迟高达 2 秒以上的级联系统(ASR → LLM → TTS)。 ...语音模型# KAME# Sakana AI6个月前1670
Inworld AI 发布 Realtime TTS-2:首个“闭环”语音模型,能听懂语气、情绪与非语言声音传统的文本转语音(TTS)模型大多是为单向输出(如有声读物)设计的,它们只能看到文字,却听不到声音背后的情绪、讽刺或无奈。 官方介绍:https://inworld.ai/blog/realtime...早报语音模型# Inworld AI# Realtime TTS-26个月前2400
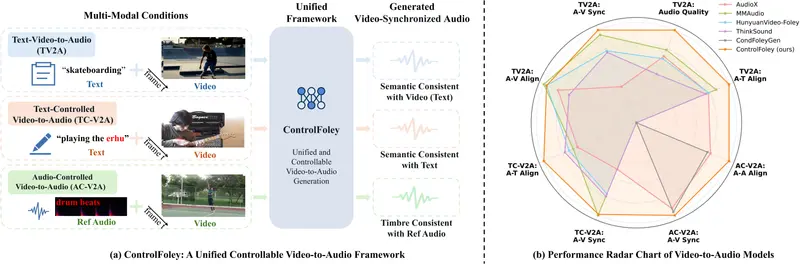
小米发布ControlFoley :视频配声不再“瞎猜”,实现文字强控与音色分离的精准同步在视频创作中,后期配音和音效制作往往是最耗时且最考验专业技能的环节。现有的 AI 视频生成音频(V2A)工具虽然能自动配声,但常面临两大难题: “不听指挥”:当文字描述与画面内容冲突时,AI 往往忽略...语音模型# ControlFoley# 视频配音6个月前2640
xAI 发布 Grok Voice Think Fast 1.0:重新定义企业级语音代理xAI 正式推出其旗舰级语音模型 grok-voice-think-fast-1.0,标志着 AI 语音代理能力的一次阶跃式变革。该模型专为处理现实世界中复杂、模糊且高风险的多步骤工作流而设计,已在 ...语音模型# Grok Voice Think Fast 1.0# xAI6个月前2140
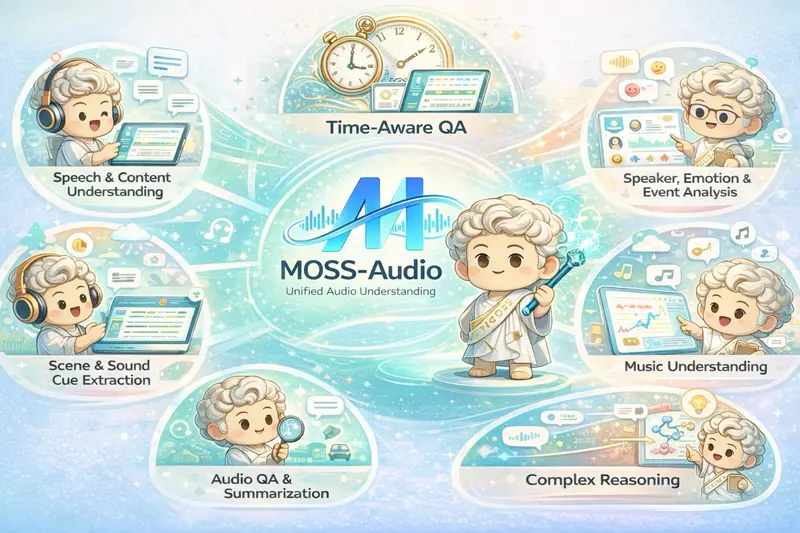
OpenMOSS推出MOSS-Audio:支持语音、环境音与音乐理解的开源统一音频理解模型由 MOSI.AI、OpenMOSS 团队和上海人工智能实验室联合打造的 MOSS-Audio 正式开源。这是一款专为复杂现实世界音频设计的统一理解模型,不仅支持语音转录,更能深度解析环境声、音乐、情...语音模型# MOSS-Audio# OpenMOSS6个月前3300
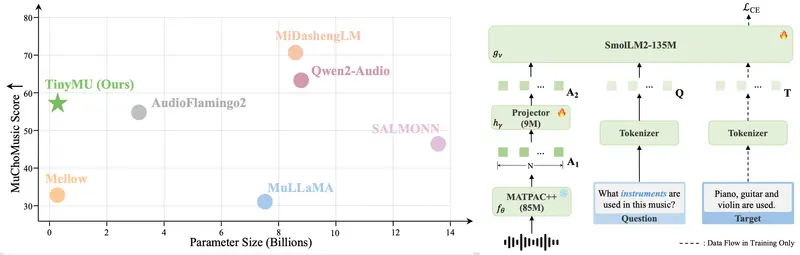
TinyMU:手机端可运行的超轻量音乐理解大模型由巴黎综合理工学院和上海交通大学联合研究团队推出的 TinyMU,是一款革命性的轻量化音乐理解大模型。它旨在解决当前音乐 AI 模型参数量巨大、运行成本高、难以部署在边缘设备上的痛点,让“听懂音乐”的...语音模型# TinyMU# 音乐理解大模型6个月前1880
谷歌发布 Gemini 3.1 Flash TTS:赋予 AI 语音“导演级”控制力谷歌正式推出 Gemini 3.1 Flash TTS(文本转语音)预览版模型。这不仅是语音质量的提升,更是一次从“黑盒生成”向“细粒度指令控制”的范式转变。该模型在 Artificial Analy...早报语音模型# Gemini 3.1 Flash TTS# 谷歌6个月前2400
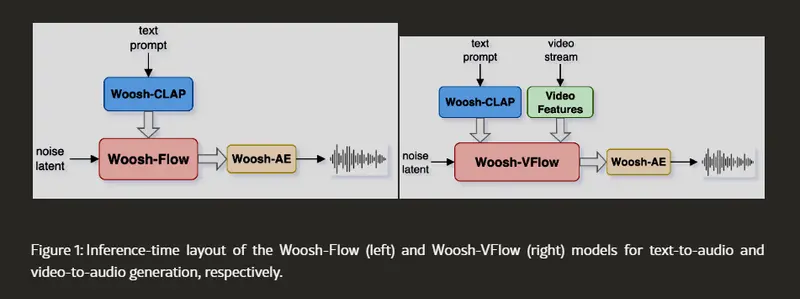
索尼AI发布开源音效大模型Woosh,48kHz 高保真 AI 音频模型索尼AI 正式开源了 Woosh,一款专为高质量音效生成打造的基础大模型。与市面上许多“黑盒”或低采样率的 AI 音频工具不同,Woosh 不仅完全公开了代码和权重,更在音质、速度和多模态能力上实现了...语音模型# Woosh# 索尼AI7个月前4210
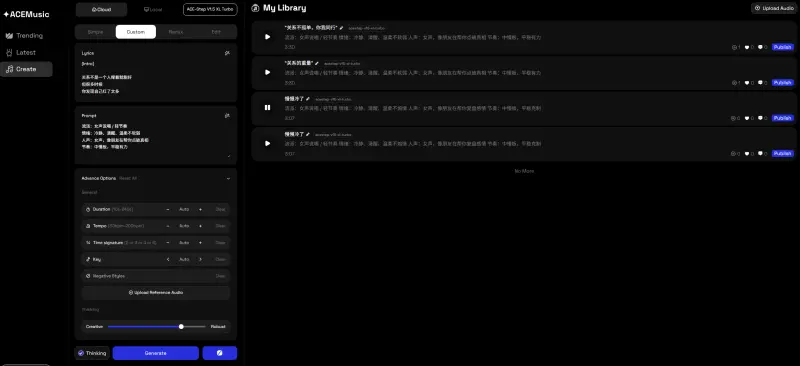
ACE-Step 1.5 XL 发布:4B 参数 DiT 解码器,定义开源音乐生成新高度ACE Studio 联合 阶跃星辰 (StepFun) 正式推出 ACE-Step 1.5 XL 系列模型。这是 ACE-Step 家族的重大升级,引入了拥有 40 亿 (4B) 参数 的 DiT ...语音模型# ACE-Step 1.5 XL7个月前7390
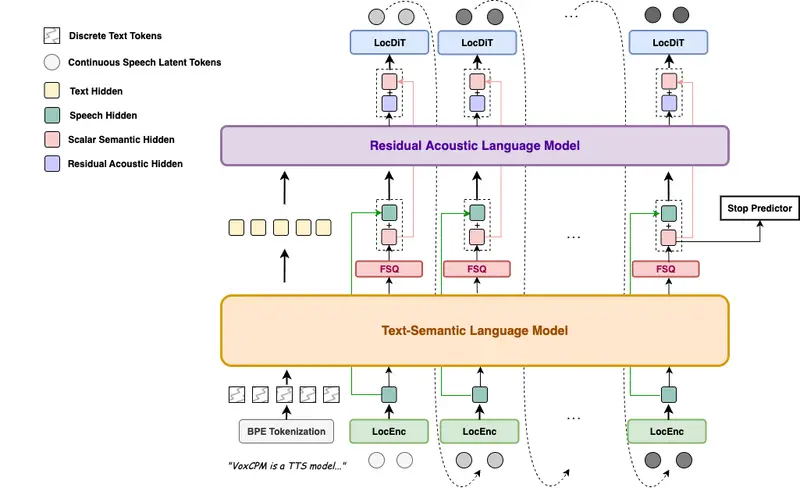
面壁智能发布 VoxCPM2:20亿参数、无离散 Tokenizer 的开源语音合成新标杆面壁智能 (ModelBest) 正式发布了 VoxCPM2,一款基于连续表征(Continuous Representation)的多语言语音合成模型。作为 VoxCPM 系列的最新迭代,VoxCP...语音模型# TTS# VoxCPM2# 面壁智能7个月前5100