微软研究院正式开源了 VibeVoice-ASR-Streaming,这是一款端到端的流式语音识别模型。它打破了传统“先转录后分离”或“双模块拼接”的局限,能够在音频输入的同时,实时输出带有准确说话人归属(Speaker Attribution)的文字。该模型支持中英日法等 10+ 种语言,提供 1.5B 和 7B 两种参数量级,并完全开放权重与推理代码,为开发者提供了一套可本地部署、隐私安全的实时多人语音识别基线。
- GitHub:https://github.com/microsoft/VibeVoice
- 模型:https://huggingface.co/collections/microsoft/vibevoice
- Demo:https://fighter-maintaining-wagner-alex.trycloudflare.com
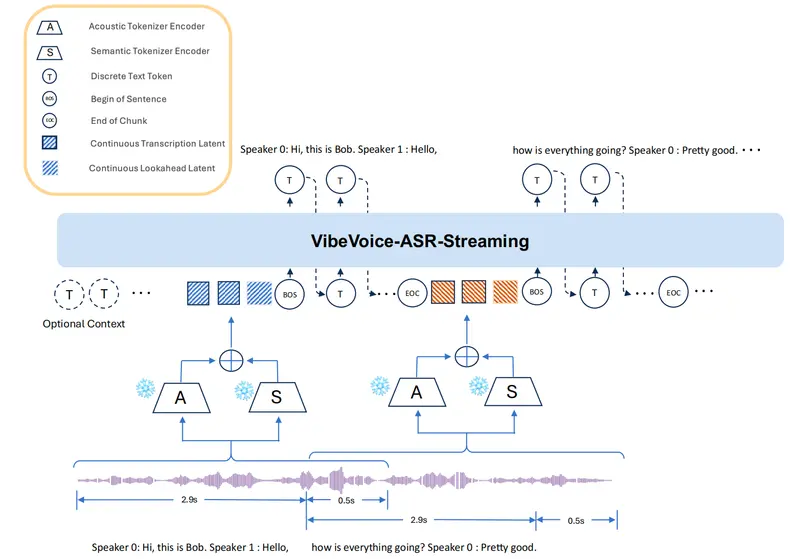
核心痛点与解决方案
在多人会议、直播或访谈场景中,传统的语音转写面临两大难题:
- 高延迟与标签抖动:云端服务往往需要等待数秒甚至十几秒才能确定说话人,且会反复修改已输出的标签,导致实时字幕“跳变”,阅读体验极差。
- 张冠李戴:独立的 ASR(语音识别)和 SD(说话人分离)模块拼接容易出错,导致文字识别正确但归属错误。
VibeVoice-ASR-Streaming 的突破:
- 端到端单模型:将语音识别与说话人区分整合在一个模型内部,音频流入即同步输出“谁说了什么”。
- 极低延迟与高稳定性:稳态预期延迟仅约 2 秒,且一旦输出说话人标签,绝不回头修改历史文稿,确保实时阅读的流畅性。
- 长上下文记忆:模型内部保留完整的历史音频与文本上下文,即使参会者间隔几分钟再次发言,也能准确识别其身份,无需外部声纹数据库。
技术架构与工作原理
- 流式交替推理:
- 音频被切割为固定时长的小块(如 2.0s 或 2.9s)。
- 模型采用“接收音频块 + 少量前瞻音频 → 生成带说话人标记的文本 → 接收下一块”的循环模式。
- 前瞻音频有助于判断对话边界,显著提升说话人区分的准确率。
- 分阶段训练策略:
- 阶段一:使用离线完整录音训练基础识别与分离能力。
- 阶段二:切换为流式音频块输入,让模型适应实时工作模式。
- 阶段三:使用高质量真实会议与合成数据精细调优,强化热词识别与格式一致性。
- 自定义热词支持:
- 支持在会话开始前预设人名、术语或缩写,模型会在整个转写过程中参考这些提示,大幅降低专有名词的错误率。
性能表现
| 指标 | VibeVoice-ASR-Streaming (7B) | 主流商用云服务 |
|---|---|---|
| 稳态延迟 | ~2 秒 | 8–9 秒 |
| 标签稳定性 | 输出后不再修改 | 频繁回改历史标签 |
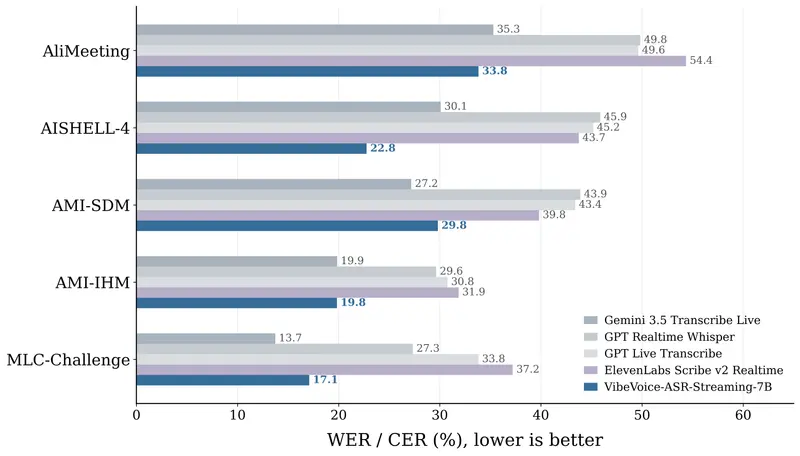
| 文字识别准确率 | SOTA (流式系统中排名第一) | 略低 |
| 说话人归属准确率 | 12/13 项评测最优或并列最优 | 较低 |
| 部署方式 | 本地/内网 (开源) | 云端 API |
注意:流式处理相比离线完整版会有轻微的性能损耗,且在长时间大量语音重叠场景下效果会下降。单次会话最长支持 8 分钟。
应用场景
- 企业会议实时纪要:
- 线上会议:接入 Zoom/腾讯会议等,实时生成带发言人名字的字幕。
- 线下保密会议:在内网服务器本地部署,音频不上传云端,满足政企涉密需求。
- 直播与播客字幕:
- 为多人圆桌直播、访谈节目提供实时、稳定的双语字幕,分清主持人与嘉宾发言。
- 医疗与庭审记录:
- 在合规前提下,本地化记录医患沟通或多方调解过程,快速生成原始对话底稿。
- 智能硬件交互:
- 多人大空间智能助手,实时分清不同用户的指令,避免混淆。
开源与部署
- 模型规格:
- 1.5B 轻量版:适合资源受限的边缘设备或低延迟要求极高的场景。
- 7B 完整版:提供最佳的识别准确率与说话人区分能力。
- 语言支持:中文、英文、日语、韩语、法语、德语、西班牙语等 10+ 种语言。
- 获取方式:模型权重、推理代码及训练流程已在 GitHub 和 Hugging Face 公开,开发者可基于此进行二次开发或私有化部署。
© 版权声明
文章版权归作者所有,未经允许请勿转载。