SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    图像模型

    共 289 篇文章
    用于文生图、图生图、图像编辑的模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
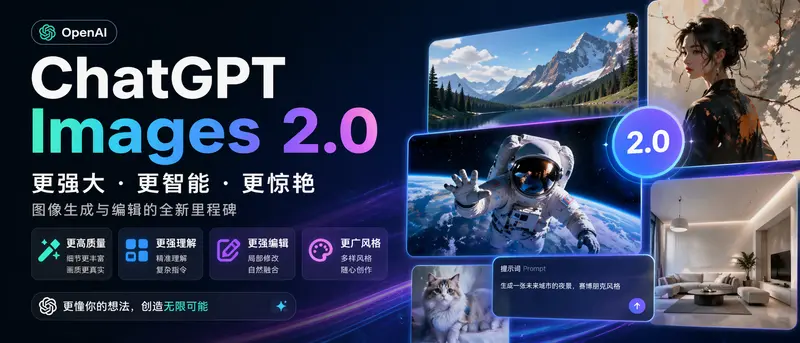
    OpenAI正式发布ChatGPT Images 2.0:内置推理能力,支持多语言文本和批量图像生成

    OpenAI正式发布ChatGPT Images 2.0:内置推理能力,支持多语言文本和批量图像生成

    OpenAI 正式推出 ChatGPT Images 2.0(API 模型名为 gpt-image-2),标志着 AI 图像生成从单纯的“像素绘制”向“视觉推理”的范式转变。基于全新的底层架构,该模型...
    图像模型早报# ChatGPT Images 2.0# OpenAI
    6个月前
    6580
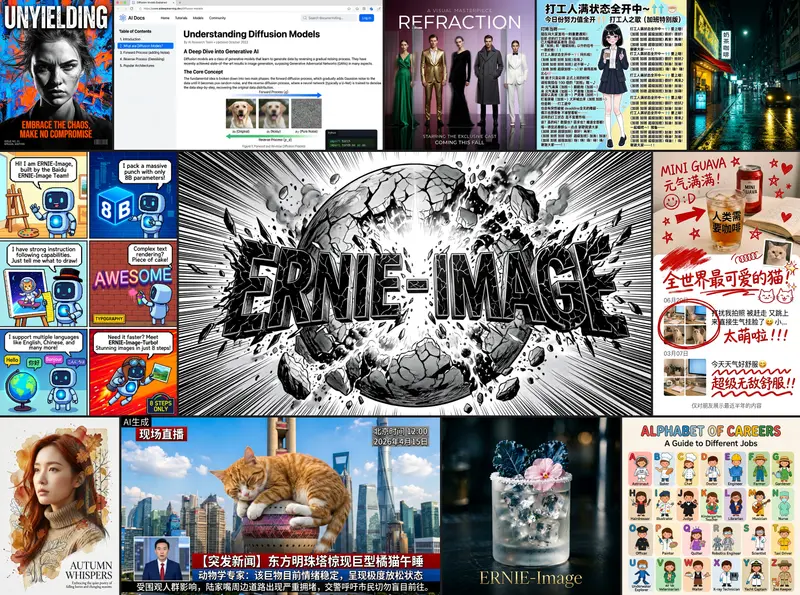
    百度开源 ERNIE-Image:8B 参数打造开源文生图新标杆,精准文本渲染与结构化生成能力卓越

    百度开源 ERNIE-Image:8B 参数打造开源文生图新标杆,精准文本渲染与结构化生成能力卓越

    百度 ERNIE-Image 团队正式开源了其最新文生图模型 ERNIE-Image。该模型基于单流扩散变换器(DiT)架构,拥有 80 亿(8B)参数,并配备一个轻量级的 3B 提示增强器(Prom...
    图像模型# ERNIE-Image# 文生图模型# 百度
    6个月前
    3030
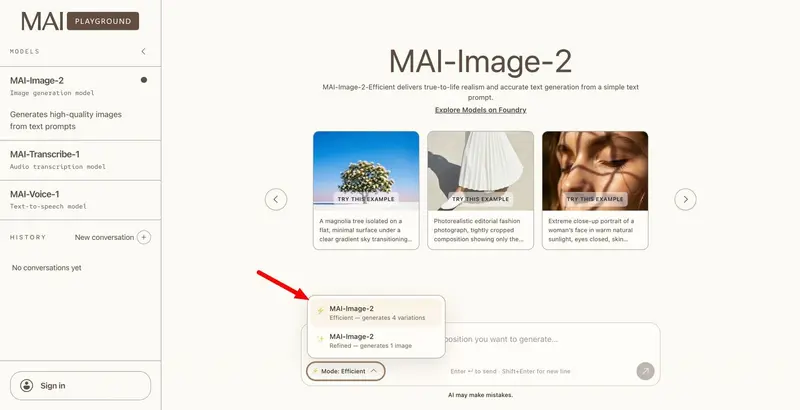
    微软发布 MAI-Image-2-Efficient:速度提升 22%,成本降低 41% 的企业级图像生成模型

    微软发布 MAI-Image-2-Efficient:速度提升 22%,成本降低 41% 的企业级图像生成模型

    微软正式推出 MAI-Image-2-Efficient,这是其旗舰图像生成模型 MAI-Image-2 的轻量化、高效率版本。该模型专为需要大规模生成视觉内容的企业团队设计,在保持高质量输出的同时...
    图像模型早报# MAI-Image-2-Efficient# 微软
    7个月前
    2630
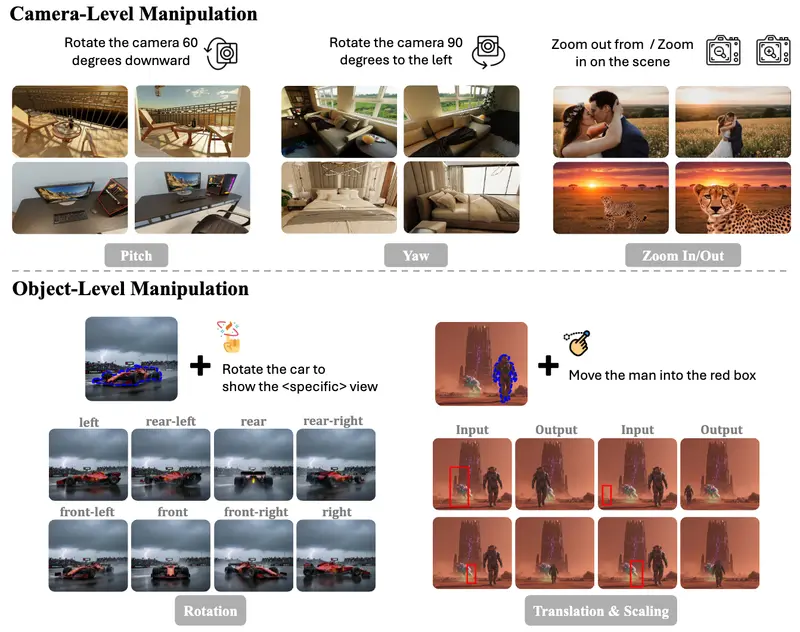
    AI 修图终于“指哪打哪”:SpatialEdit 实现精准空间操控,告别画面扭曲

    AI 修图终于“指哪打哪”:SpatialEdit 实现精准空间操控,告别画面扭曲

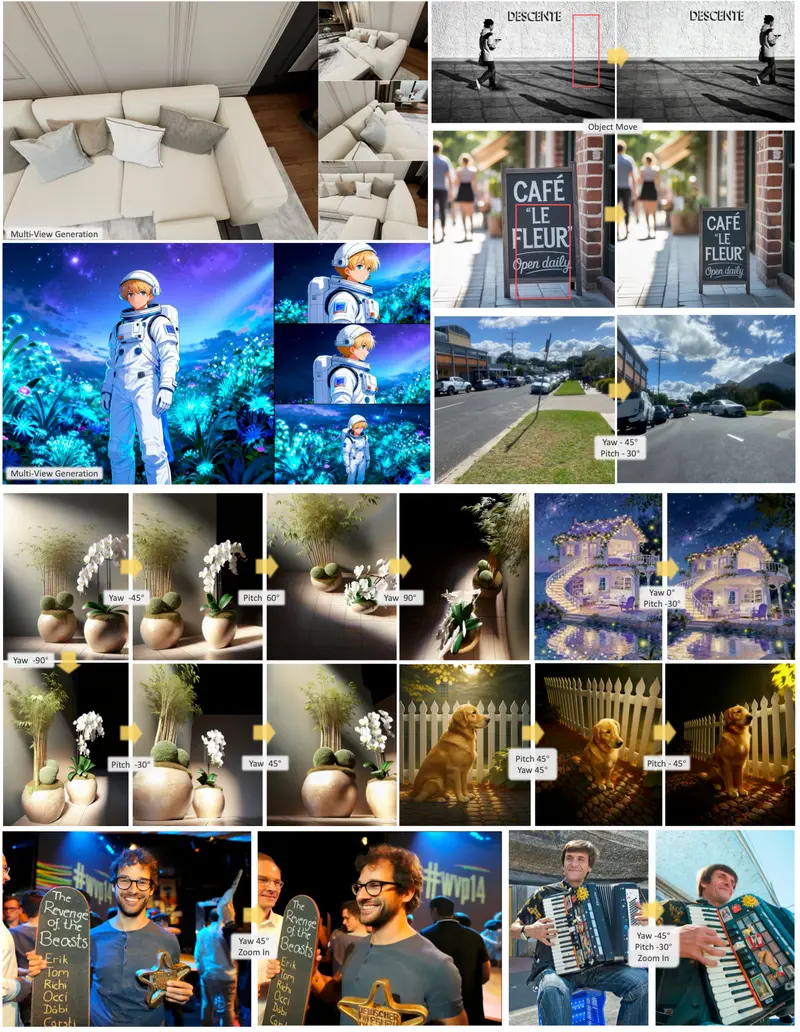
    现在的 AI 画图工具,大多有个“通病”:你让它“把车往左挪一点”,它可能给你换了一辆车;你让它“旋转 30 度”,它可能直接把车轮画歪了。 它们懂语义,但不懂空间。 最近,由香港大学、京东探索研究院...
    图像模型# SpatialEdit# 图像编辑
    7个月前
    3000
    京东发布 JoyAI-Image:集图像理解、文生图及指令引导编辑于一体的统一多模态基础模型

    京东发布 JoyAI-Image:集图像理解、文生图及指令引导编辑于一体的统一多模态基础模型

    京东今日正式发布 JoyAI-Image,这是一款集图像理解、文生图(T2I)及指令引导编辑于一体的统一多模态基础模型。不同于传统模型将理解与生成割裂处理,JoyAI-Image 的核心理念是构建“理...
    图像模型# JoyAI-Image# 京东
    7个月前
    4470
    阿里巴巴发布 Wan2.7-Image:集图像生成与编辑于一体的统一模型,人更真、字更稳、色更准

    阿里巴巴发布 Wan2.7-Image:集图像生成与编辑于一体的统一模型,人更真、字更稳、色更准

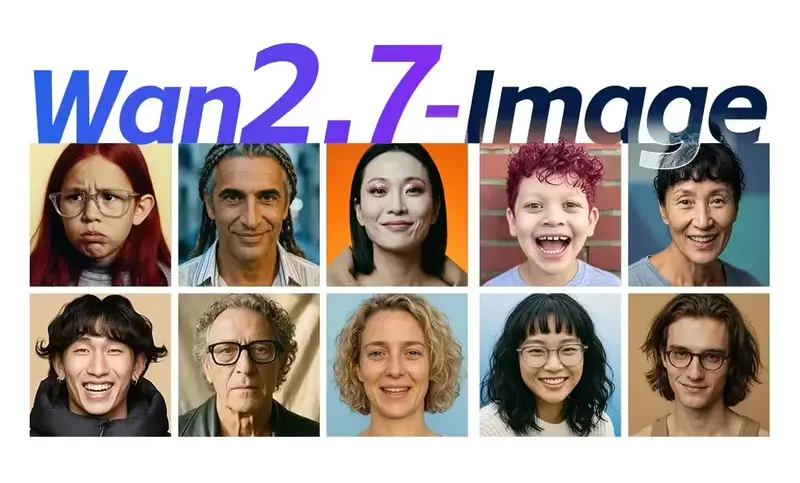
    阿里巴巴今日正式发布 Wan2.7-Image,一款集图像生成与编辑于一体的统一模型。专为对内容品质有极致要求的创作者打造,Wan2.7-Image 直击当前 AI 生图领域的三大痛点:人物同质化(A...
    图像模型# Wan2.7-Image# 阿里巴巴
    7个月前
    4410
    Mugen:基于 Flux 2 VAE 的 SDXL 动漫模型新生,低成本实现高质量角色生成

    Mugen:基于 Flux 2 VAE 的 SDXL 动漫模型新生,低成本实现高质量角色生成

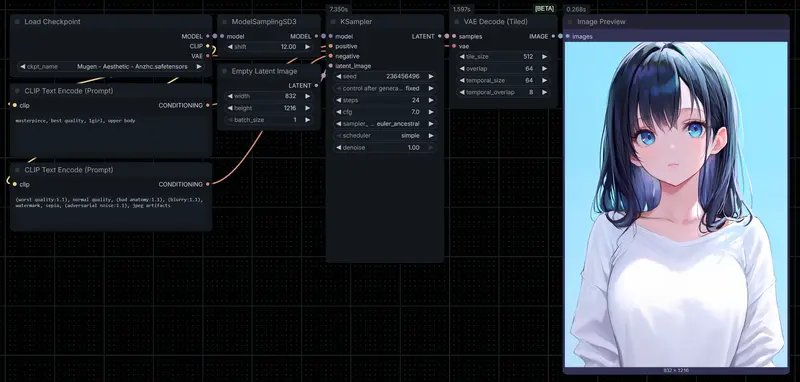
    Mugen 是开发者 Cabal Research 推出的最新动漫生成模型系列。作为从 SDXL 到 Flux 2 VAE 潜空间转换技术的延续,Mugen 不仅重命名以区别于原始的 NoobAI 模...
    图像模型# Mugen# SDXL# 动漫模型
    7个月前
    4170
    See-through:一张静态动漫图,自动“透视”拆分为可动 2.5D 角色

    See-through:一张静态动漫图,自动“透视”拆分为可动 2.5D 角色

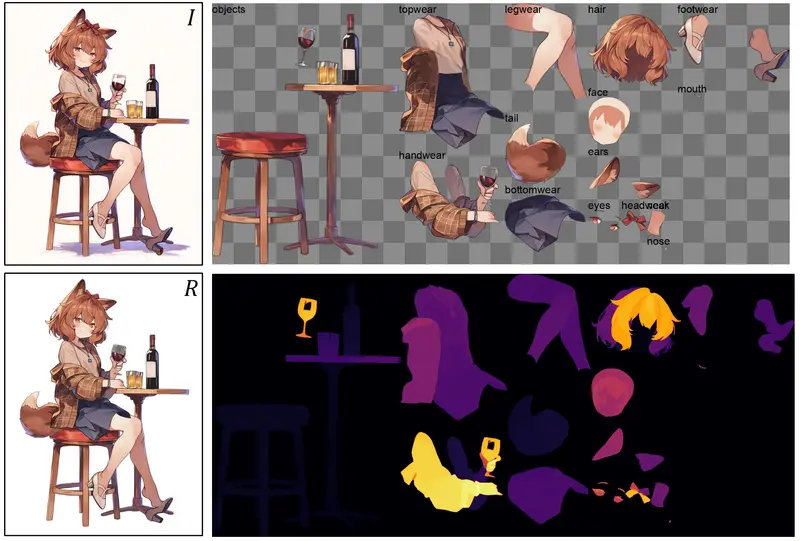
    在虚拟主播(VTuber)、游戏开发和视觉小说制作中,将静态插画转化为可互动的 Live2D 模型 是标准流程。然而,传统制作极其耗时:画师需要手动将图片切割成数十个图层,凭想象“脑补”被头发遮挡的脸...
    图像模型# Live2D 模型# See-through
    7个月前
    7090
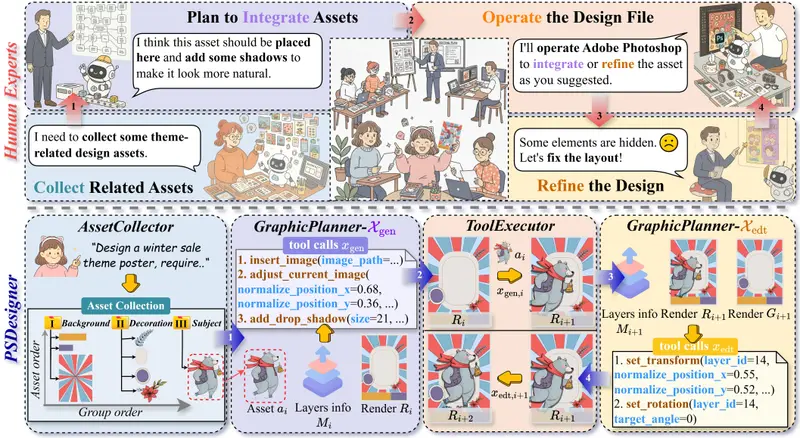
    PSDesigner:首个模拟人类设计师工作流的自动化图形设计系统,直接生成可编辑 PSD 文件

    PSDesigner:首个模拟人类设计师工作流的自动化图形设计系统,直接生成可编辑 PSD 文件

    在 AI 绘画领域,Midjourney 等模型已经能生成令人惊叹的图像,但它们有一个致命弱点:输出的是“死”的位图。图层被合并、文字无法修改、元素无法移动。对于需要反复迭代、精细调整的电商海报、广告...
    图像模型# PSDesigner# 图形设计
    7个月前
    3570
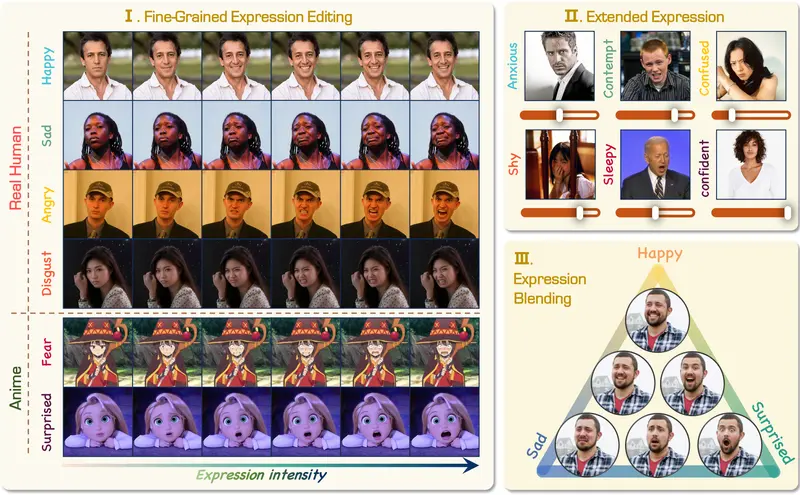
    PixelSmile:复旦与StepFun联手打造,AI表情编辑迎来“微操”时代

    PixelSmile:复旦与StepFun联手打造,AI表情编辑迎来“微操”时代

    “笑得太假”、“愤怒变成了厌恶”、“改完表情不像本人了”——这些曾是AI人脸编辑难以逾越的鸿沟。如今,复旦大学与StepFun的研究团队共同推出了 PixelSmile,一款基于扩散模型的细粒度面部表...
    图像模型# PixelSmile# 面部表情编辑
    7个月前
    3790
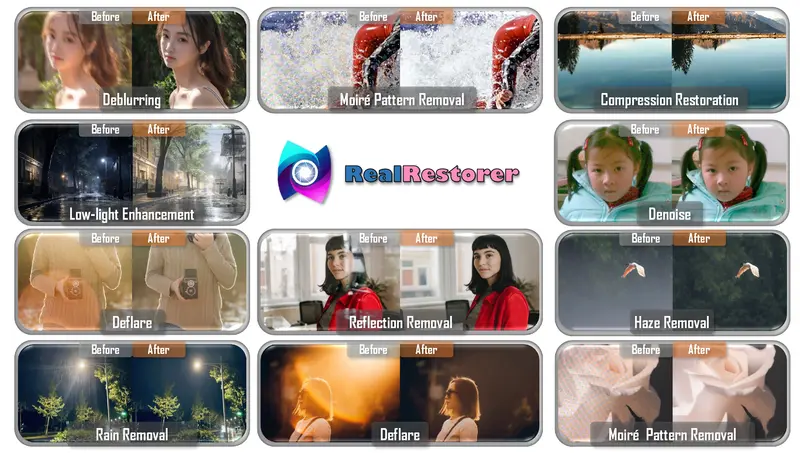
    RealRestorer:开源图像修复新标杆,九合一全能模型直逼闭源顶尖水平

    RealRestorer:开源图像修复新标杆,九合一全能模型直逼闭源顶尖水平

    在自动驾驶、安防监控、遥感分析乃至日常摄影中,图像质量往往决定了下游任务的成败。然而,真实世界中的图像退化(如模糊、噪点、雾霾、反光等)复杂多变,传统修复模型往往“水土不服”,而效果卓越的闭源大模型...
    图像模型# RealRestorer# 图像修复
    7个月前
    3810
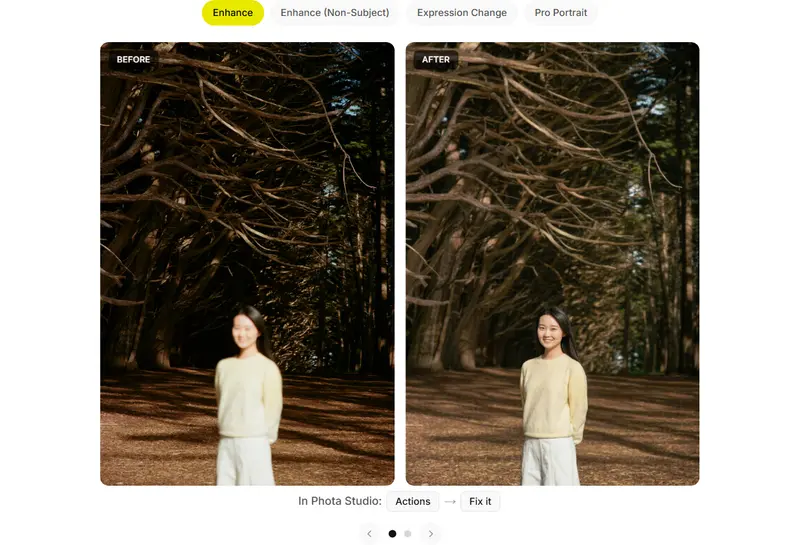
    Phota Labs 发布全新 AI 摄影工具:保留真实人像,实现个性化照片创作与编辑

    Phota Labs 发布全新 AI 摄影工具:保留真实人像,实现个性化照片创作与编辑

    在生成式 AI 席卷图像领域的今天,我们常常面临一个尴尬的困境:AI 生成的图片虽然精美,但里面的人“像我却不是我”。眼神不对、微笑的弧度陌生、甚至五官细节都发生了微妙的偏移。对于摄影而言,真实性与身...
    图像模型早报# Phota Labs
    7个月前
    3040
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    VideoFX

    VideoFX

    VideoFX是谷歌AI实验室的一个实验性AI视频生成产品,由 Veo 2.0模型提供支持,目前还处于抢先体验阶段,Veo 2 是一款极其高质量的视频生成模型,能够在广泛的题材和风格中创建逼真的视频内容。
    Adobe Firefly Video

    Adobe Firefly Video

    由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
    知乎直答

    知乎直答

    知乎于2024年6月推出了其全新的AI产品——“知乎直答”。这标志着知乎在AI搜索领域的功能正式产品化,并拥有了自己的独立域名和服务入口。“知乎直答”利用知乎平台丰富的真实问答数据,通过AI技术为用户提供两种答案生成方式:“简略”和“深入”,以满足不同用户的需求。此外,该产品还支持“找内容”和“找人”功能,旨在进一步缩短用户与优质回答之间的距离,提升社区创作者及其内容的可见度和流通效果。
    朱雀大模型检测

    朱雀大模型检测

    腾讯朱雀 AI 检测是于 2025 年 1 月 17 日推出的一款 AI 生成内容检测工具,主要用于帮助用户识别 AI 生成的文本和图像内容。每位用户每天最多可检测20次文本和20次图片。
    Tavus

    Tavus

    Tavus推出了其CVI平台的最新版本——一个集成了情感智能的完整操作系统。这一创新让开发者能够创建出能够“看到、听取、理解并参与”实时面对面互动的AI代理,为用户带来前所未有的沉浸体验。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      VideoFX

      VideoFX

      VideoFX是谷歌AI实验室的一个实验性AI视频生成产品,由 Veo 2.0模型提供支持,目前还处于抢先体验阶段,Veo 2 是一款极其高质量的视频生成模型,能够在广泛的题材和风格中创建逼真的视频内容。
      Adobe Firefly Video

      Adobe Firefly Video

      由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
      知乎直答

      知乎直答

      知乎于2024年6月推出了其全新的AI产品——“知乎直答”。这标志着知乎在AI搜索领域的功能正式产品化,并拥有了自己的独立域名和服务入口。“知乎直答”利用知乎平台丰富的真实问答数据,通过AI技术为用户提供两种答案生成方式:“简略”和“深入”,以满足不同用户的需求。此外,该产品还支持“找内容”和“找人”功能,旨在进一步缩短用户与优质回答之间的距离,提升社区创作者及其内容的可见度和流通效果。
      朱雀大模型检测

      朱雀大模型检测

      腾讯朱雀 AI 检测是于 2025 年 1 月 17 日推出的一款 AI 生成内容检测工具,主要用于帮助用户识别 AI 生成的文本和图像内容。每位用户每天最多可检测20次文本和20次图片。
      Tavus

      Tavus

      Tavus推出了其CVI平台的最新版本——一个集成了情感智能的完整操作系统。这一创新让开发者能够创建出能够“看到、听取、理解并参与”实时面对面互动的AI代理,为用户带来前所未有的沉浸体验。
      查看完整榜单