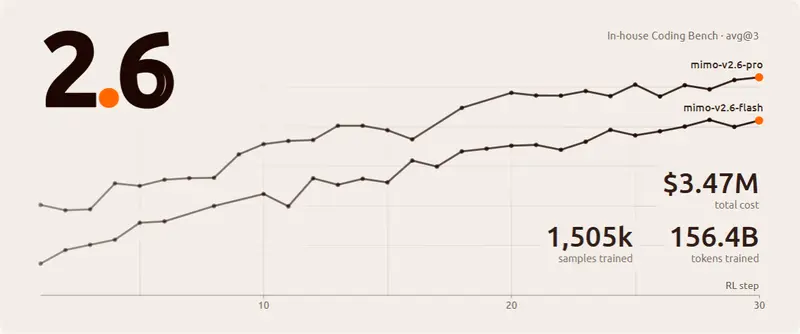
小米开源 MiMo-V2.6 系列:全模态 RL 扩展模型,Pro 版登顶开源智能榜首小米正式发布并开源 MiMo-V2.6 系列原生全模态模型,包含 MiMo-V2.6-Pro、MiMo-V2.6-Flash,同时推出 MiMo-V2.6-Pro-UltraSpeed 极速版本,在同...多模态模型早报# MiMo-V2.6# 小米1个月前2810
仅 1 亿参数!SupraLabs 推出轻量文生图模型Supra2-IMG,单张 H100 训练 9 小时SupraLabs 推出 Supra2-IMG,一个仅含 1.05 亿参数的微型文本到图像扩散 Transformer(DiT),在高质量合成数据集 LucasFang/FLUX-Reason-6M ...图像模型# Supra2-IMG# SupraLabs1个月前800
SpaceXAI 发布 Grok 4.7:面向长程编程与专业工作的强化学习模型,标准版 $2/$6 per M tokensSpaceXAI今天推出 Grok 4.7,定位为用于编程和知识工作的旗舰模型。该模型基于比 Grok 4.6 更大的基础架构,通过更长的强化学习周期在复杂任务组合上训练,权重显著偏向需数小时完成的长...大语言模型早报# Grok 4.7# SpaceXAI1个月前690
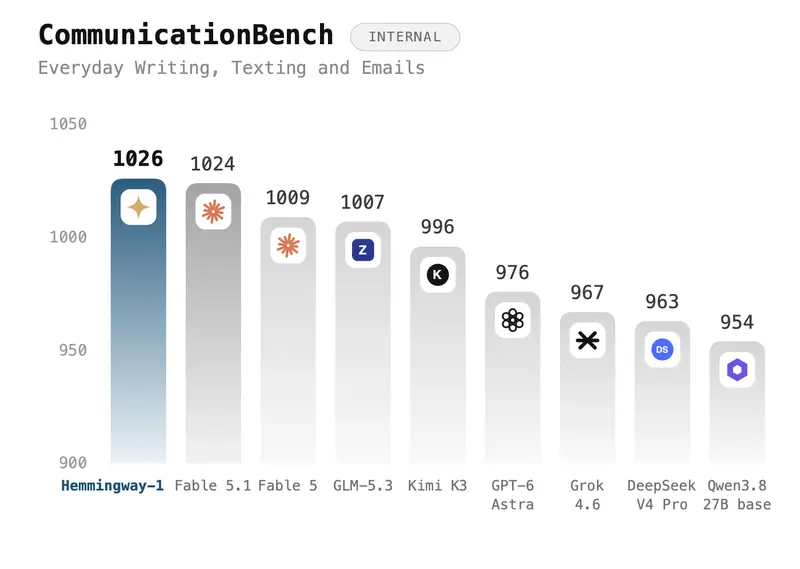
主打真人感写作!开源模型 Hemmingway-1,27B 参数拿下日常写作盲测第一Hemmingway-1 是一款基于 Qwen3.8-27B 微调的开放权重语言模型,采用 Apache-2.0 许可证发布,专为生成自然、简洁、符合人类日常沟通习惯的文本而设计。其核心定位并非通用对...大语言模型# Hemmingway-1# Qwen3.8-27B1个月前770
阿里千问开源 Qwen-Image-2.1:7B 小模型,原生支持透明图生成与图层编辑阿里千问项目组正式开源 Qwen-Image-2.1,一款将文生图与图像编辑能力整合于单一模型的轻量级图像生成系统。其视觉生成模块仅含 7B 参数(32 层 Single-Stream DiT),在保...图像模型# Qwen-Image-2.1# 阿里千问1个月前1420
Linkup Research 开源 SPARSEUP:149M 稀疏嵌入模型,150M 参数内 BEIR-13 榜单最优Linkup Research发布 SPARSEUP,一款基于 ModernBERT 主干的 149M 参数学习型稀疏嵌入模型,采用 Apache 2.0 许可在 Hugging Face 开放权重...大语言模型# Linkup Research# SPARSEUP# 嵌入模型1个月前750
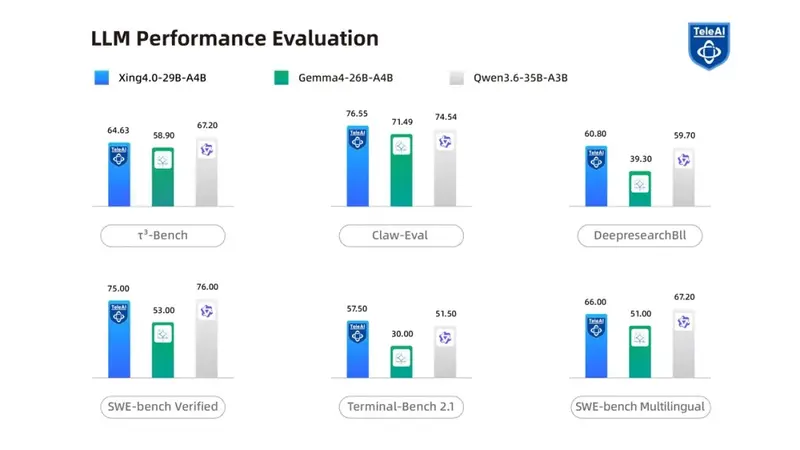
中国电信发布星辰大模型 Xing4.0-29B-A4B:全栈国产算力训练,24G 消费显卡可本地运行9 月 17 日,中国电信人工智能科技有限公司正式发布新一代星辰语义大模型 Xing4.0-29B-A4B。该模型总参数量 29B,激活参数仅 4B,原生支持 256K 上下文(可扩展至 512K...大语言模型# Xing4.0-29B-A4B# 中国电信# 辰大模型1个月前1150
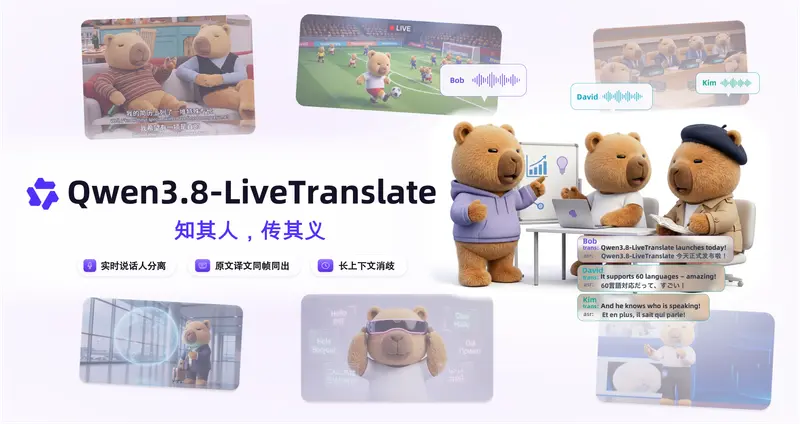
阿里千问发布同声传译大模型 Qwen3.8-LiveTranslate:Interleave 架构重构同传,字均延迟低至 2.3 秒阿里千问今日正式发布同声传译大模型 Qwen3.8-LiveTranslate。该模型采用 Interleave 架构对实时同传流程进行重构,在忠实度、流畅度与简洁度三项核心指标上实现全面提升,字均延...早报语音模型# Qwen3.8-LiveTranslate# 同声传译大模型# 阿里千问1个月前1020
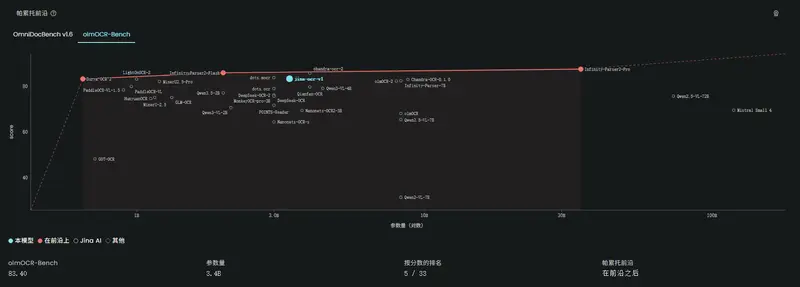
Jina AI 发布 jina-ocr-v1:3.4B MoE 文档解析器,适配低预算 GPU,自带投机解码Jina AI(Elastic 旗下)正式开源 jina-ocr-v1,一款端到端视觉文档解析模型。该模型总参数量为 3.4B,每个 token 仅激活约 570M 解码器参数,专为 NVIDIA L...多模态模型# Jina AI# jina-ocr-v11个月前650
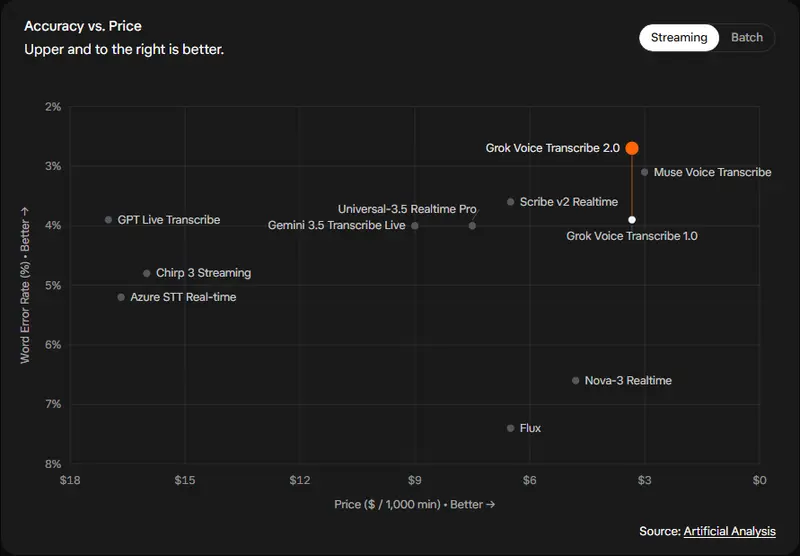
SpaceXAI 推出 Grok Voice Transcribe 2.0:准确率翻倍,批处理转录 0.1 美元 / 小时SpaceXAI 正式推出语音转文本模型 Grok Voice Transcribe 2.0,模型 ID 为 grok-voice-transcribe-2.0。该版本基于 Grok Voice 音频...早报语音模型# Grok Voice Transcribe 2.0# SpaceXAI1个月前630
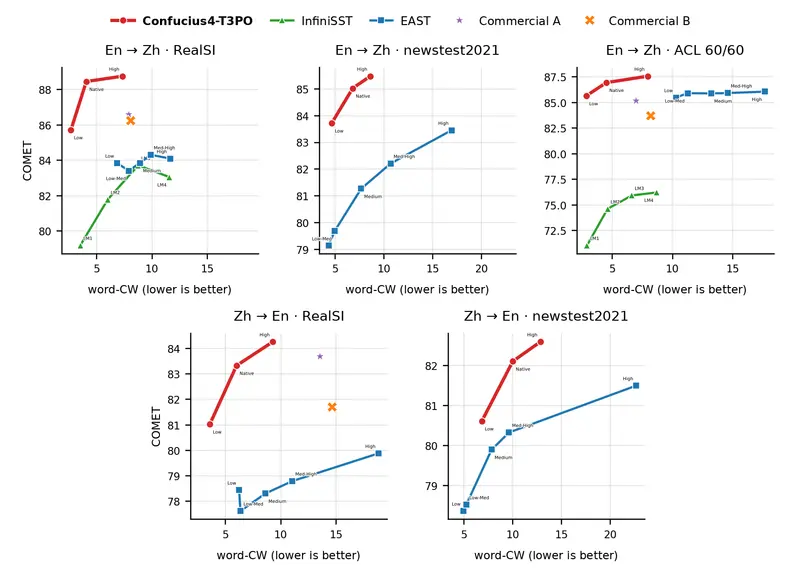
兼顾翻译质量与延迟!网易有道发布Confucius4-T3PO:基于帕累托前沿策略优化的文本同声翻译模型网易有道 AI 团队正式发布了 Confucius4-T3PO,一款拥有 140 亿参数的文本到文本(Text-to-Text, T2T)同声机器翻译(SiMT)模型。该模型通过创新的帕累托前沿策略优...语音模型# Confucius4-T3PO# 网易有道1个月前720
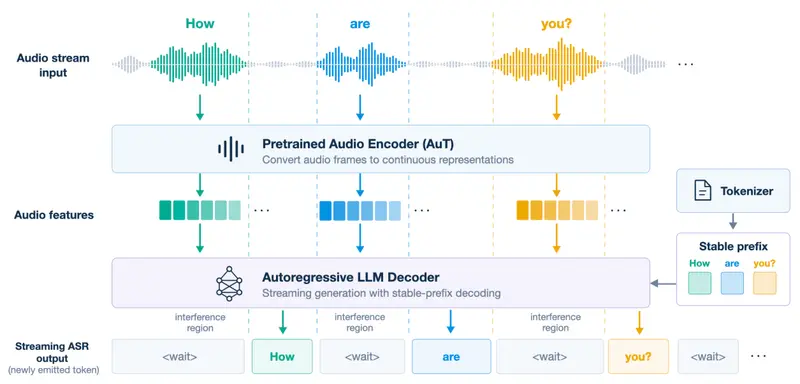
网易有道发布 Confucius4-R2T2:低延迟高准确率实时语音识别模型,适配实时字幕与 AI 智能体网易有道正式发布了 Confucius4-R2T2,一款基于 Qwen3-ASR 架构的低延迟、高准确率真流式(True Streaming)自动语音识别模型。该模型的核心突破在于解决了传统流式 AS...语音模型# Confucius4-R2T2# 实时语音识别模型# 网易有道1个月前1170