音频视频原生输入!Cloudflare推出Clef-omni多模态决策模型,Clef家族同步降价提速继上周发布Clef与Clef-flash开放权重决策模型后,Cloudflare进一步扩充Clef产品家族,正式推出Clef-omni,这是一款原生支持文本、图像、音频、视频四模态输入的决策模型。同时...决策模型# Clef-omni# Cloudflare3周前330
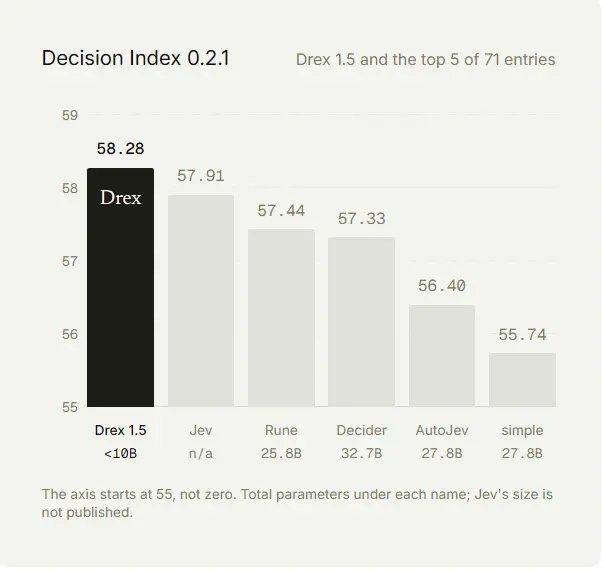
对标闭源Jev!Nace AI开源Drex 1.5:擅长长文档决策推理,单卡即可本地部署Nace.AI正式开源Drex 1.5,一款面向AI智能体与后端工作流的9B决策模型。Drex 1.5的核心设计区别于常规大语言模型:不输出文本内容,接收状态信息与带类型的问题,直接为预设的候选选项输...决策模型# Drex 1.5# Jev# Nace AI3周前340
微软在Foundry上线决策模型Decision-1:不生成自由文本,输出结构化概率,作为AI代理控制层微软推出 Microsoft-Decision-1,一款面向快速决策评分的专用模型,输出可供程序直接执行的结构化选择,现已上架Microsoft Foundry平台和OpenRouter。开发者可用它...决策模型早报# Microsoft-Decision-1# 微软3周前440
阿里千问推出Qwen-Image-2.1-Turbo:8步去噪文生图,沿用7B架构,2K图生成提速阿里千问项目组此前在9月20日开源Qwen-Image-2.1,这是一款融合文生图与图像编辑能力的轻量图像生成模型。视觉生成模块仅7B参数,采用32层Single-Stream DiT架构,在保证出图...图像模型# Qwen-Image-2.1-Turbo# 阿里千问3周前790
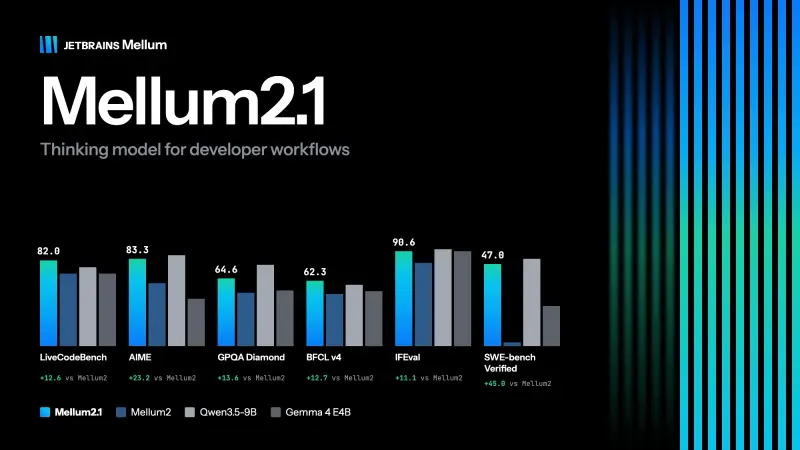
JetBrains 发布 Mellum2.1:面向编码代理的12B MoE开源模型,真实仓库强化学习大幅提升代码能力JetBrains 正式推出 Mellum2.1,一款专为编码代理、轻量子代理打造的开源MoE思考模型。它延续Mellum2原有架构,总参数量12B,每token激活2.5B参数,采用Apache 2...大语言模型# JetBrains# Mellum2.13周前550
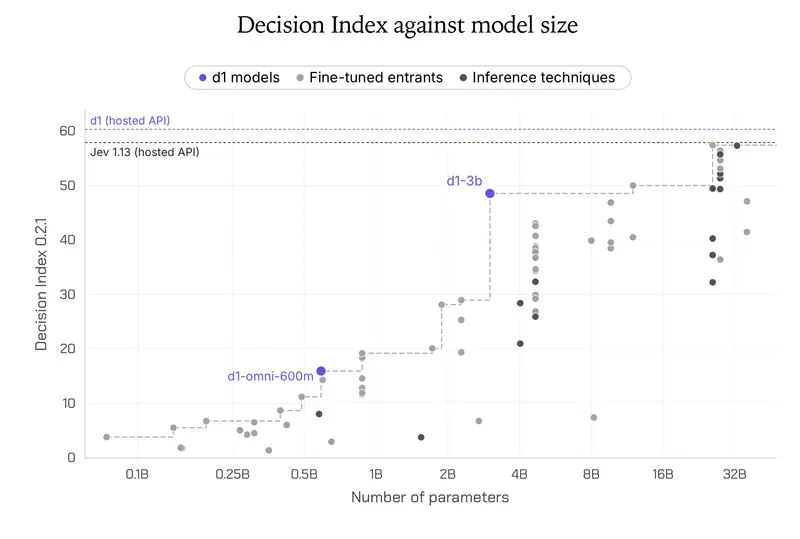
Liquid AI 开源 Open d1 决策模型:零输出Token,d1-3B与d1-omni-600M面向实时多模态判定Liquid AI 推出开放权重多模态决策模型家族 Open d1,包含两款模型:d1-3B,支持文本+图像输入;d1-omni-600M,支持文本搭配图像或者文本搭配音频。这两个模型和常规生成式大模...决策模型# d1-3B# d1-omni-600M# Liquid AI3周前480
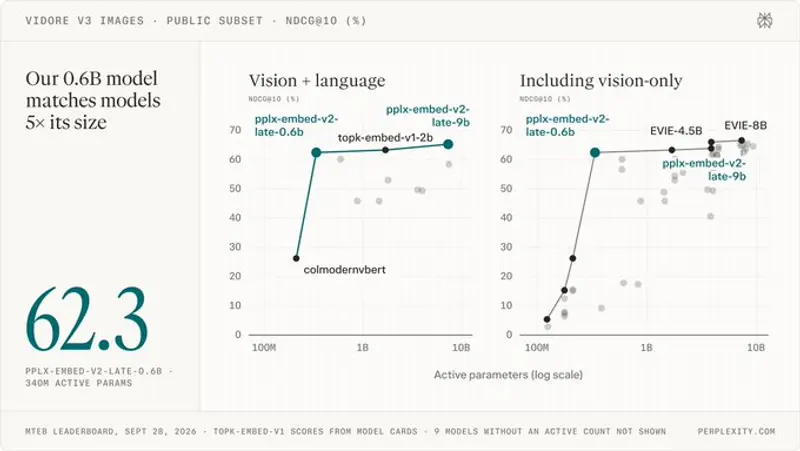
Perplexity 发布 pplx-embed-v2-late:双尺寸ColBERT风格多模态嵌入模型,MIT许可开源Perplexity 正式推出 pplx-embed-v2-late,一对ColBERT架构风格的多模态嵌入模型,分为0.6B轻量边缘版本与9B高质量版本,二者共享同一嵌入空间,支持文本、图片、渲染P...多模态模型# Perplexity# pplx-embed-v2-late3周前420
微软开放MAI-Code-1.1-Flash本地部署:保留256K上下文,推荐128GB内存才能流畅跑微软正式开放编程模型MAI-Code-1.1-Flash,支持开发者本地离线部署,脱离云端服务器运行AI编程代理。模型采用3位量化技术压缩显存占用,同时完整保留256K上下文窗口,在SWE-Bench...大语言模型早报# MAI-Code-1.1-Flash# 微软# 编程模型3周前630
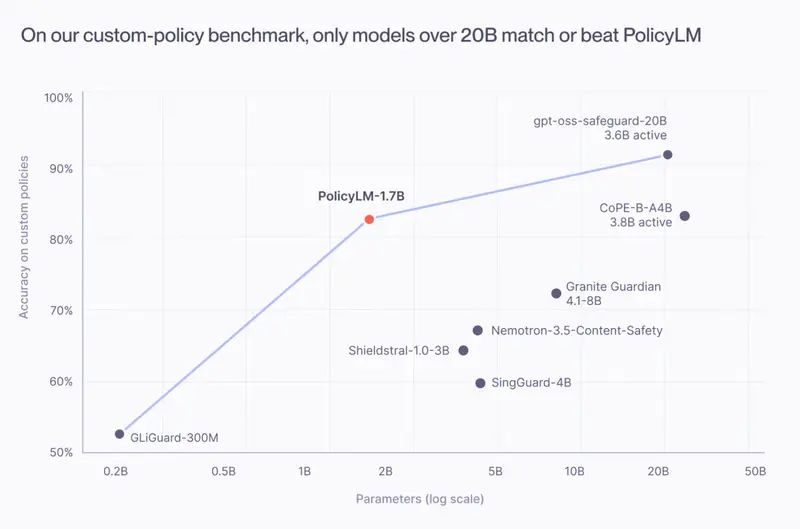
Musubi 发布开放权重决策模型PolicyLM-1.7B:面向实时内容审核,政策修改无需重训随着决策模型在AI领域快速兴起,Musubi推出专为实时内容审核打造的轻量级决策模型PolicyLM-1.7B,采用开放权重Apache 2.0协议发布。它可以直接读取自然语言撰写的平台内容规范,单条...决策模型# Musubi# PolicyLM-1.7B3周前450
谷歌发布 EmbeddingGemma 2:Apache2.0开源轻量多模态嵌入模型,设备端统一处理图文音视频谷歌推出 EmbeddingGemma 2,一款Apache 2.0协议开放、面向设备端的轻量多模态嵌入模型,能够把文本、代码、图像、音频、视频映射至同一个嵌入向量空间,在消费级本地硬件上完成跨模态语...多模态模型# EmbeddingGemma 2# 多模态嵌入模型# 谷歌3周前600
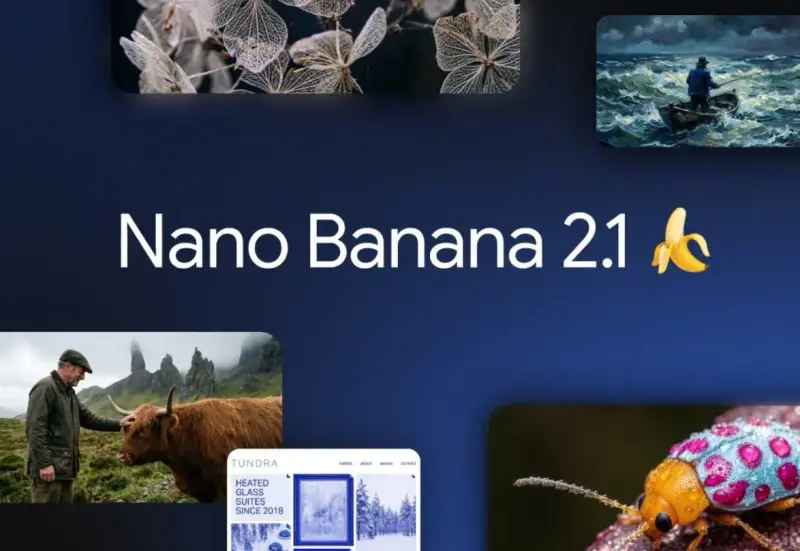
谷歌发布 Nano Banana 2.1:蒙版局部编辑升级,多图主体一致性大幅增强谷歌正式推出 Nano Banana 2.1,这是基于 Gemini 3.6 Image 打造的新一代AI图像生成与编辑模型,在Nano Banana 2(Gemini 3.1 Flash Image...图像模型早报# Gemini 3.6 Image# Nano Banana 2.1# 谷歌3周前680
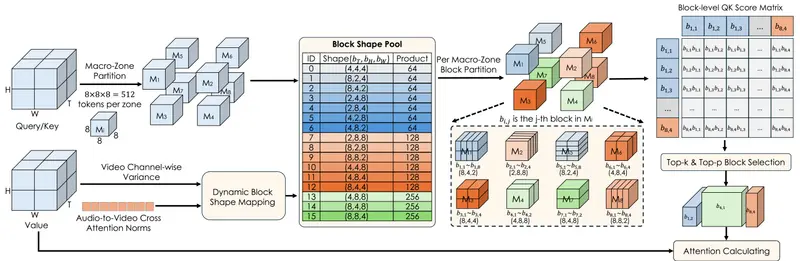
Prism:复旦+腾讯混元+浙大提出动态稀疏注意力框架,实现原生2K音视频联合生成高效训练复旦大学、腾讯混元团队与浙江大学联合推出 Prism,一款面向原生2K音视频联合生成的动态稀疏注意力科研框架,解决直接训练2K音视频大模型算力昂贵、音画同步易受损的难题。 项目主页:https://f...视频模型# Prism3周前780