SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    视频模型

    共 212 篇文章
    用于文生视频、图生视频、视频编辑的模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
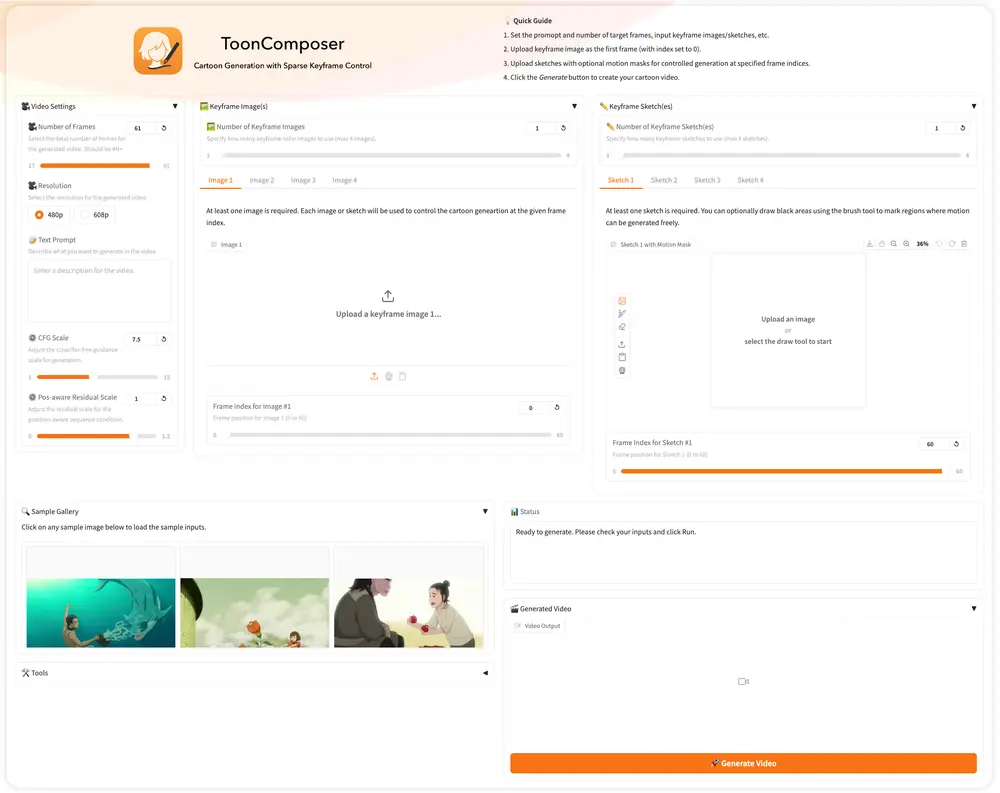
     ToonComposer:通过生成式后关键帧(post-keyframing)阶段简化卡通制作流程

     ToonComposer:通过生成式后关键帧(post-keyframing)阶段简化卡通制作流程

    香港中文大学、腾讯PCG ARC Lab和北京大学的研究人员推出 ToonComposer ,通过生成式后关键帧(post-keyframing)阶段简化卡通制作流程。传统的卡通和动画制作涉及关键帧绘...
    视频模型# ToonComposer# 卡通制作
    1年前
    1,3700
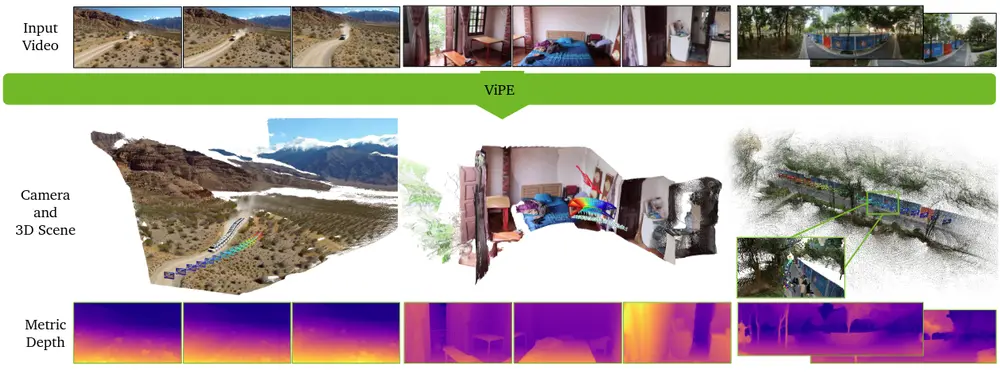
    视频处理引擎ViPE:用于从普通视频中估计相机运动、相机内参以及密集的度量深度图

    视频处理引擎ViPE:用于从普通视频中估计相机运动、相机内参以及密集的度量深度图

    英伟达、多伦多大学、矢量研究所和德克萨斯大学奥斯汀分校的研究人员推出视频处理引擎ViPE(Video Pose Engine) ,用于从普通视频中估计相机运动、相机内参以及密集的度量深度图,能够从普通...
    视频模型# ViPE# 视频处理引擎
    1年前
    5410
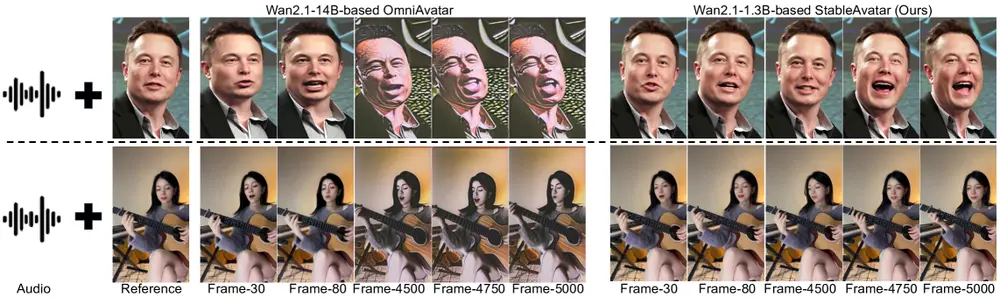
    StableAvatar:首个端到端生成无限长度虚拟人视频的扩散模型

    StableAvatar:首个端到端生成无限长度虚拟人视频的扩散模型

    你是否曾想过,仅凭一张静态照片和一段语音,就能让照片中的人物“开口说话”,并持续数分钟自然表达?这正是音频驱动虚拟人视频生成(Audio-Driven Talking Head Generation...
    视频模型# StableAvatar# 虚拟人
    1年前
    7440
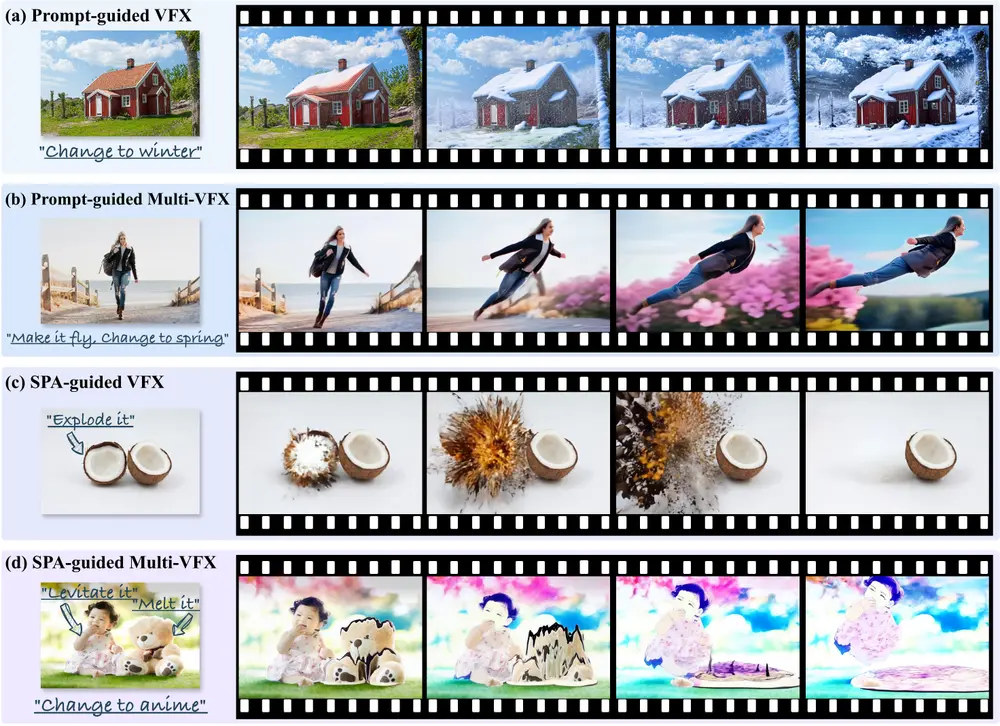
    阿里发布 Omni-Effects:首个支持空间可控复合特效生成的统一框架

    阿里发布 Omni-Effects:首个支持空间可控复合特效生成的统一框架

    在现代电影与视频制作中,视觉特效(VFX)是实现创意表达的核心工具。然而,传统 VFX 制作成本高昂、周期长,依赖专业团队和复杂软件。 近年来,AI 视频生成模型为 VFX 提供了更具成本效益的替代方...
    视频模型# Omni-Effects# 视觉特效
    1年前
    4080
    腾讯微信视觉团队发布 Stand-In:轻量级身份保持视频生成新框架

    腾讯微信视觉团队发布 Stand-In:轻量级身份保持视频生成新框架

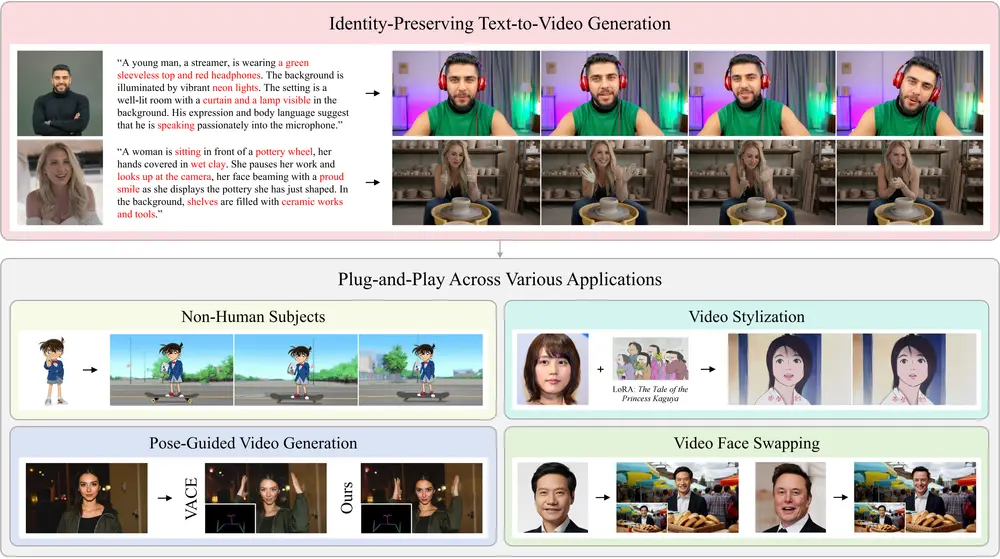
    在文本到视频(T2V)生成领域,一个长期存在的难题是:如何让生成的视频中的人物始终“长成你想要的样子”? 尽管现有模型能生成流畅、高质量的视频,但在身份一致性(identity-preserving...
    视频模型# Stand-In# 视频生成框架
    1年前
    8510
    LIA-X:一种可解释的肖像动画方法,让面部动作“看得见、控得住”

    LIA-X:一种可解释的肖像动画方法,让面部动作“看得见、控得住”

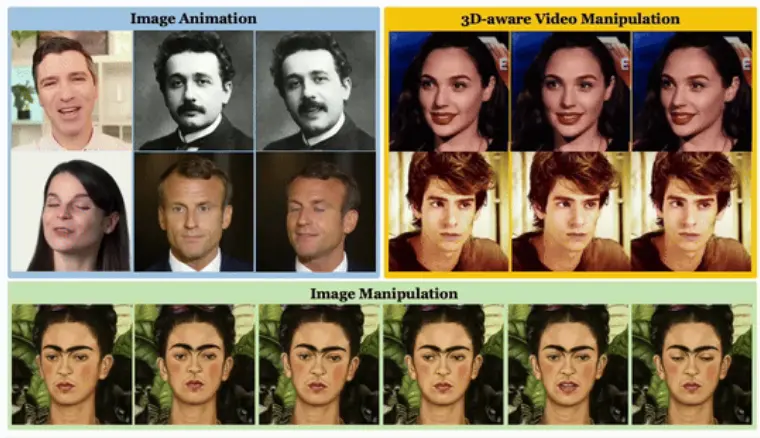
    上海人工智能实验室和蔚蓝海岸大学的研究人员推出一种新颖的可解释肖像动画器LIA-X,旨在将驱动视频中的面部动态转移到源肖像上,并实现精细控制。 项目主页:https://wyhsirius.githu...
    视频模型# LIA-X# 肖像动画
    1年前
    6120
    EchoMimicV3:用一个13亿参数模型,统一处理音频、文本、图像驱动的人体动画

    EchoMimicV3:用一个13亿参数模型,统一处理音频、文本、图像驱动的人体动画

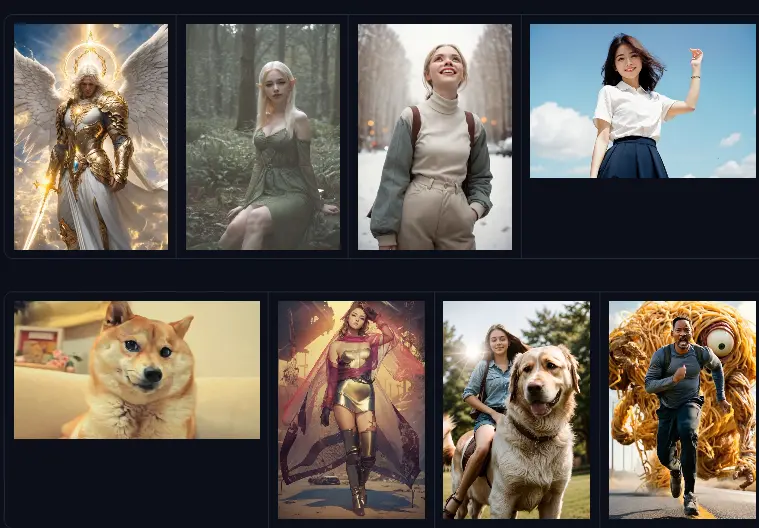
    你是否想象过这样的场景? 输入一段语音,AI 自动生成人物说话的视频,唇形精准对齐,表情自然生动; 给一张静态肖像,加上一句“他开始微笑并挥手”,画面立刻动起来; 结合提示词和参考图,生成一段人物动作...
    视频模型# EchoMimicV3# 人体动画
    1年前
    4800
    阿里云 PAI发布 Wan2.2-Fun:扩展Wan2.2文生视频与可控视频生成的能力边界

    阿里云 PAI发布 Wan2.2-Fun:扩展Wan2.2文生视频与可控视频生成的能力边界

    阿里云 PAI 团队昨日正式推出 Wan2.2-Fun 系列模型,作为其 VideoX-Fun 项目的重要更新,进一步扩展了文生视频与可控视频生成的能力边界。 模型:https://huggingfa...
    视频模型# Wan2.2-Fun# 阿里云 PAI
    1年前
    7800
    MiniMax-Remover:港中大等联合提出高效视频目标移除新方法

    MiniMax-Remover:港中大等联合提出高效视频目标移除新方法

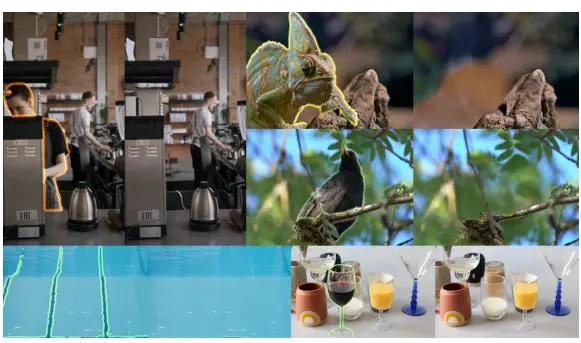
    在视频编辑中,目标移除是一项关键任务:从视频中删除指定对象(如行人、车辆、水印),同时保持背景的视觉一致性与时间连贯性。然而,现有方法常面临三大挑战: 生成伪影或“幻觉对象” 推理速度慢,依赖高步数采...
    视频模型# MiniMax-Remover
    1年前
    3700
    阿里 WAN 项目组正式推出 Wan2.2:MoE 架构 + 高压缩设计,开源视频生成再进化

    阿里 WAN 项目组正式推出 Wan2.2:MoE 架构 + 高压缩设计,开源视频生成再进化

    阿里 WAN 项目组正式推出 Wan2.2,这是对 WAN 系列视频生成模型的一次重大升级。本次发布涵盖多个模型变体,全面支持文本到视频(T2V)、图像到视频(I2V)以及混合输入(TI2V)任务,在...
    视频模型# Wan2.2# 视频生成模型
    1年前
    1,7050
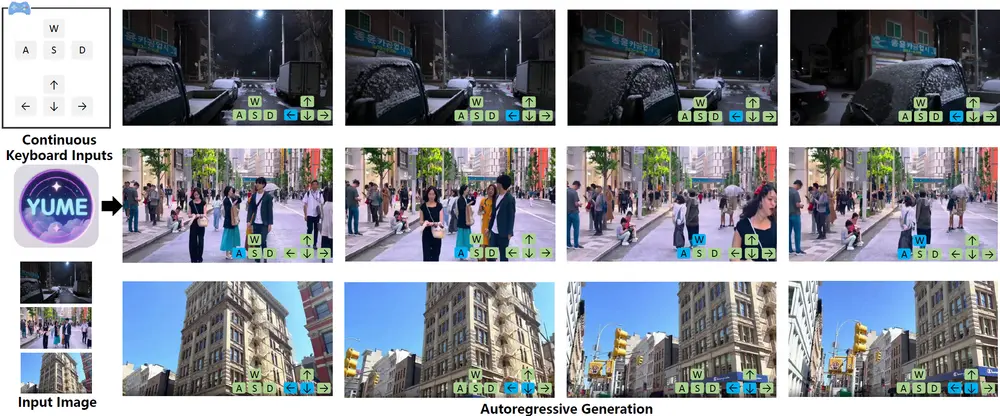
    交互式世界生成模型 Yume:通过输入图像、文本或视频来创建一个动态、逼真且可交互的世界

    交互式世界生成模型 Yume:通过输入图像、文本或视频来创建一个动态、逼真且可交互的世界

    由上海市人工智能实验室、复旦大学与上海创新研究院联合研发的新型生成模型 Yume 正式亮相。该模型旨在突破传统生成式 AI 的静态局限,构建一个可探索、可控制、高保真且动态演化的虚拟世界。 项目主页...
    视频模型# Yume# 交互式世界生成模型
    1年前
    5090
    浙大 × 阿里巴巴推出 OmniAvatar:首个支持音频驱动全身动画的可控虚拟人视频生成模型

    浙大 × 阿里巴巴推出 OmniAvatar:首个支持音频驱动全身动画的可控虚拟人视频生成模型

    在数字人、虚拟主播、AI 视频创作等领域,仅靠语音生成逼真且动作自然的虚拟形象视频,一直是生成式 AI 的关键挑战之一。 现有音频驱动视频生成方法大多聚焦于面部动画,尤其是唇部同步,而对身体动作、姿态...
    视频模型# OmniAvatar# 虚拟人
    1年前
    5350
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    WorkflowAI

    WorkflowAI

    WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
    BlitzBrowser

    BlitzBrowser

    BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
    海绵音乐

    海绵音乐

    海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
    Apple Wallpapers

    Apple Wallpapers

    AppleWalls 提供 iPhone、iPad 与 Mac 系统原生高清壁纸下载,收录 iOS 与 macOS 各版本官方壁纸。探索苹果设计美学,体验纯粹的 Apple 风格。
    SentrySearch

    SentrySearch

    SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      WorkflowAI

      WorkflowAI

      WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
      BlitzBrowser

      BlitzBrowser

      BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
      海绵音乐

      海绵音乐

      海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
      Apple Wallpapers

      Apple Wallpapers

      AppleWalls 提供 iPhone、iPad 与 Mac 系统原生高清壁纸下载,收录 iOS 与 macOS 各版本官方壁纸。探索苹果设计美学,体验纯粹的 Apple 风格。
      SentrySearch

      SentrySearch

      SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
      查看完整榜单