SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    视频模型

    共 212 篇文章
    用于文生视频、图生视频、视频编辑的模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
    Lightricks发布LTX-2:首个基于 DiT 的开源音视频基础模型

    Lightricks发布LTX-2:首个基于 DiT 的开源音视频基础模型

    Lightricks发布了首个基于 Diffusion Transformer(DiT) 架构的开源音视频联合生成模型LTX-2。它在一个统一框架中集成了现代视频生成的核心能力:同步的音频与视频输出...
    视频模型# Lightricks# LTX-2# 音视频模型
    10个月前
    4170
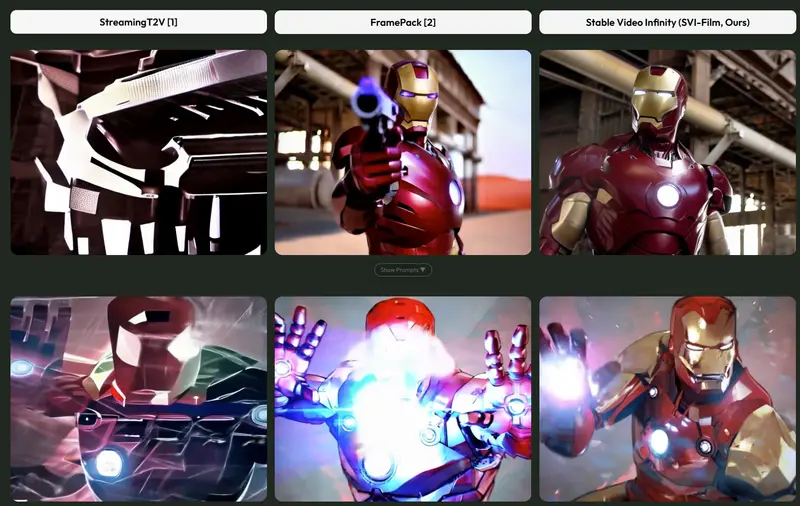
    Stable Video Infinity(SVI)发布 2.0 Pro:基于错误回收机制的无限长视频生成模型

    Stable Video Infinity(SVI)发布 2.0 Pro:基于错误回收机制的无限长视频生成模型

    洛桑联邦理工学院(EPFL)的研究团队推出 Stable Video Infinity(SVI) ——一款能够生成任意长度视频的人工智能模型。它通过一项名为 “错误回收微调(Error-Recycli...
    视频模型# Stable Video Infinity
    10个月前
    4380
    StoryMem:基于Wan2.2的新框架,用“视觉记忆”生成连贯的多镜头长视频

    StoryMem:基于Wan2.2的新框架,用“视觉记忆”生成连贯的多镜头长视频

    生成一段包含多个镜头、角色一致、场景连贯、时长达一分钟的叙事视频,是当前视频生成模型的重大挑战。主流方法要么局限于单镜头,要么在跨镜头切换时出现角色崩坏、场景断裂等问题。 由南洋理工大学与字节跳动联合...
    视频模型# StoryMem# Wan2.2
    10个月前
    3550
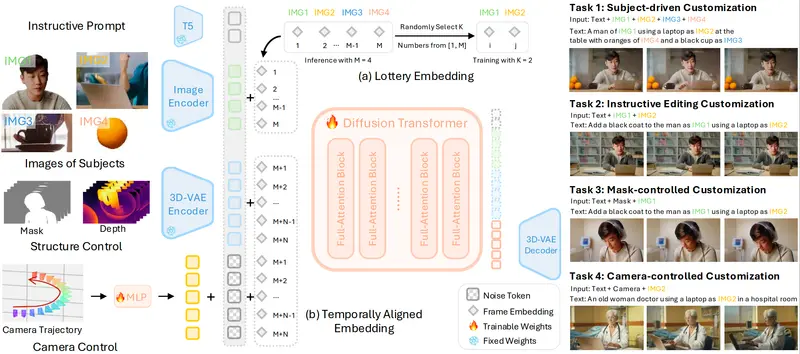
    OmniVCus:用多模态控制信号实现前馈式主题驱动视频定制

    OmniVCus:用多模态控制信号实现前馈式主题驱动视频定制

    在视频生成领域,一个长期挑战是:如何让用户通过简单指令(如文本、草图或相机轨迹),灵活定制视频中一个或多个主体的外观、动作与空间关系? 由约翰·霍普金斯大学、Adobe 研究院、香港大学、香港中文大学...
    视频模型# OmniVCus# 视频
    10个月前
    1640
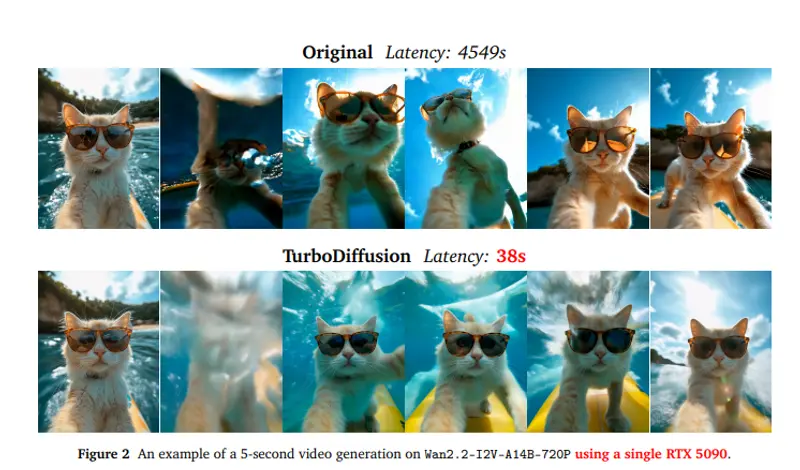
    TurboDiffusion:视频扩散模型提速 100–200 倍,质量几乎无损

    TurboDiffusion:视频扩散模型提速 100–200 倍,质量几乎无损

    视频扩散模型虽能生成高质量内容,但其缓慢的推理速度长期制约实际应用。近日,清华大学、生数科技与加州大学伯克利分校联合提出 TurboDiffusion——一个端到端视频生成加速框架,在单张 RTX 5...
    视频模型# TurboDiffusion# Wan2.2
    10个月前
    2330
    Spatia:基于可更新空间记忆的长期一致视频生成框架

    Spatia:基于可更新空间记忆的长期一致视频生成框架

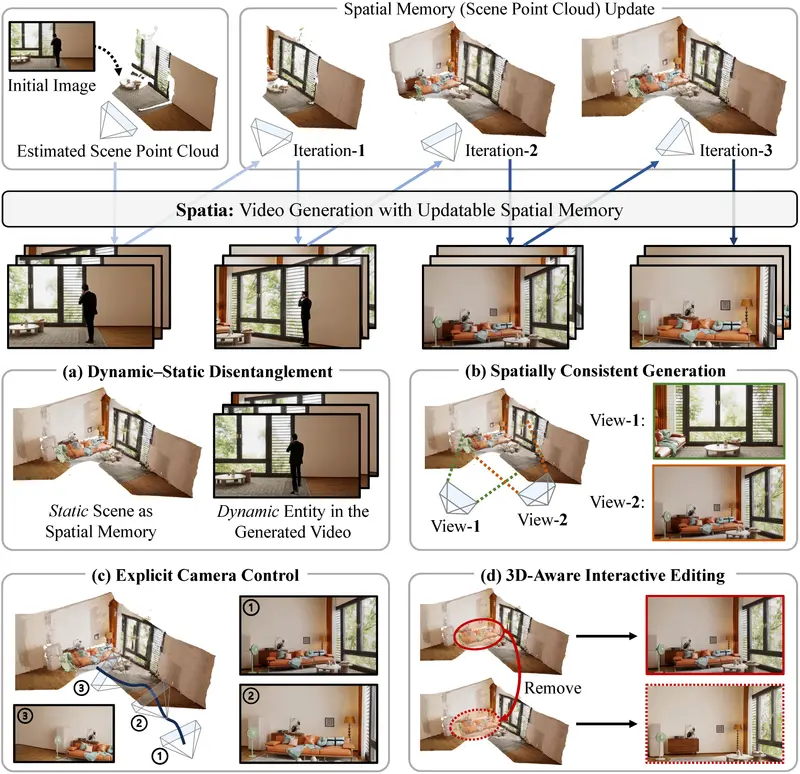
    传统视频生成模型在生成长视频时,常因高维时空信号的复杂性而难以维持长期的空间与时间一致性——场景结构漂移、物体位置突变、相机运动不连贯等问题普遍存在。 项目主页:https://zhaojingjin...
    视频模型# Spatia# 视频生成
    10个月前
    1760
    英伟达推出NitroGen:基于人类游戏视频的通用视觉-动作基础模型

    英伟达推出NitroGen:基于人类游戏视频的通用视觉-动作基础模型

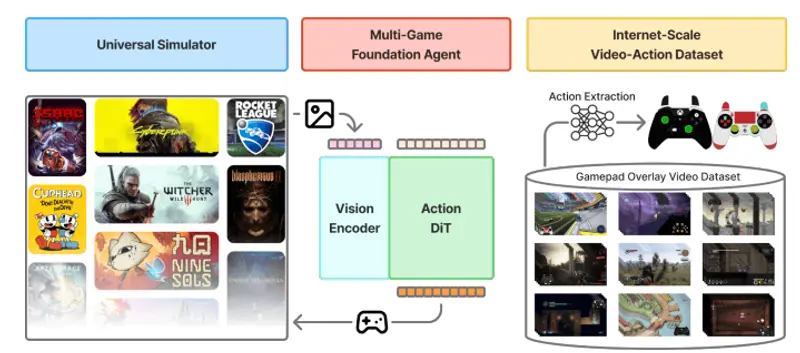
    NitroGen 是由英伟达开发的开放性具身智能基础模型(foundation model for embodied agents),旨在通过观察人类玩家的游戏视频,直接学习从原始画面到手柄动作的映射...
    视频模型# NitroGen# 英伟达
    10个月前
    3070
    FlashPortrait:端到端生成无限长度肖像动画,6倍加速且身份一致

    FlashPortrait:端到端生成无限长度肖像动画,6倍加速且身份一致

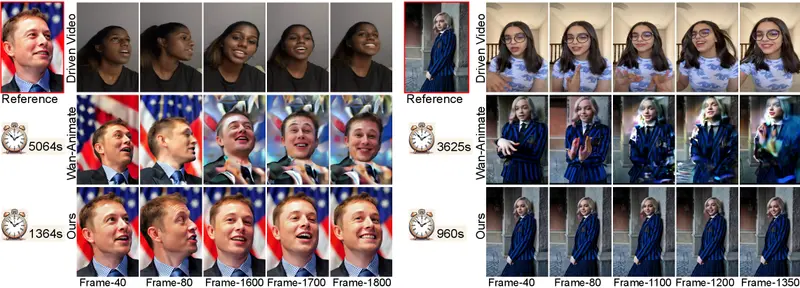
    在肖像动画(Portrait Animation)任务中,身份一致性与推理效率是两大长期瓶颈。现有扩散模型即便能生成逼真短片,也常在长序列中出现身份漂移、颜色偏移或动作断裂,且生成速度慢,难以用于实际...
    视频模型# FlashPortrait# 肖像动画
    10个月前
    2440
    美团 LongCat 发布统一音频驱动视频模型LongCat-Video-Avatar:支持长视频、多模态输入与多人物动画

    美团 LongCat 发布统一音频驱动视频模型LongCat-Video-Avatar:支持长视频、多模态输入与多人物动画

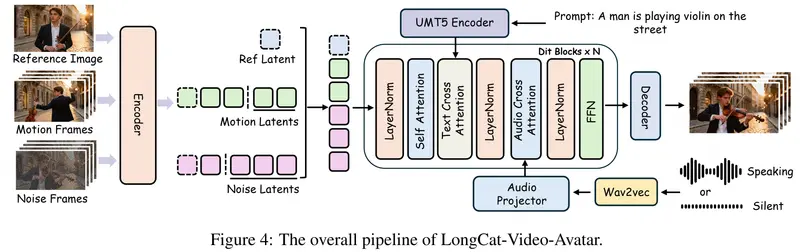
    音频驱动的人类视频合成(Audio-Driven Talking Head)近年来在唇形同步和画面逼真度上取得显著进展。但生成长时间、高动态、身份一致的视频仍是行业难题:现有方法要么在长序列中出现身份...
    视频模型# LongCat-Video-Avatar# 美团
    10个月前
    3000
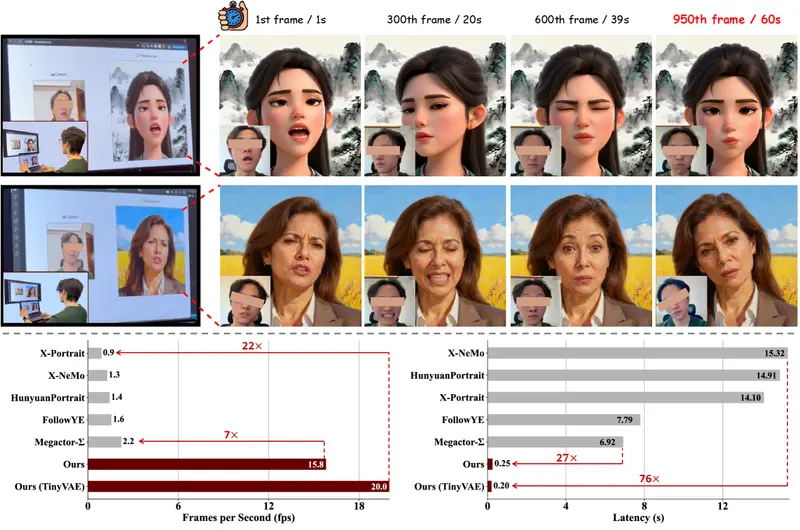
    PersonaLive:基于扩散模型的实时肖像动画系统,延迟仅0.25秒

    PersonaLive:基于扩散模型的实时肖像动画系统,延迟仅0.25秒

    在数字人、虚拟主播和直播场景中,高质量、低延迟、身份一致的肖像动画是核心需求。然而,主流扩散模型虽能生成逼真画面,却因高计算成本与多步去噪,难以满足实时交互要求——生成一段3秒视频往往需要数十秒,远不...
    视频模型# PersonaLive# 肖像动画
    10个月前
    1790
    MoLingo:通过语义对齐潜在空间实现高保真文本到动作生成

    MoLingo:通过语义对齐潜在空间实现高保真文本到动作生成

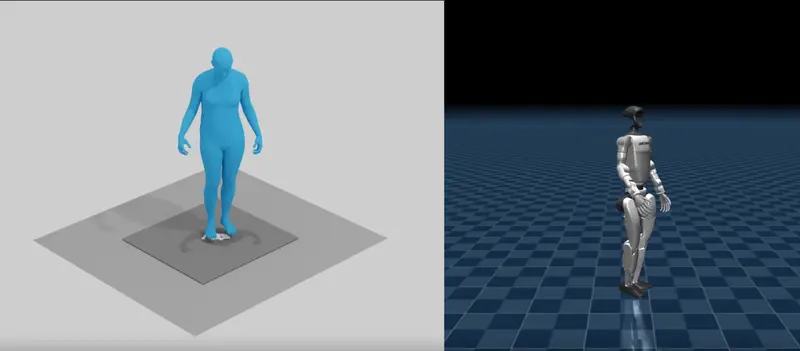
    在虚拟角色动画、VR/AR交互和智能体控制中,如何让AI根据一句自然语言(如“一个人正在跳华尔兹”)生成逼真、连贯且语义一致的人体动作,一直是核心挑战。传统方法要么动作生硬,要么与文本描述脱节,难以兼...
    视频模型# MoLingo# 动作生成
    10个月前
    3590
    智谱AI发布 Kaleido:通过多参考图像生成主体一致视频的 S2V 框架

    智谱AI发布 Kaleido:通过多参考图像生成主体一致视频的 S2V 框架

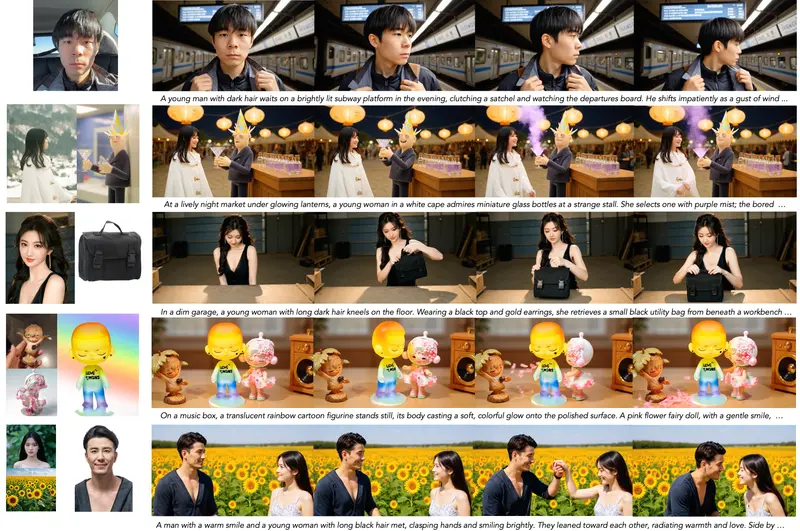
    在主体到视频(Subject-to-Video, S2V)生成任务中,目标是根据用户提供的多张目标主体参考图像和文本提示,合成一段主体身份一致、动作自然、背景可控的视频。尽管近期 S2V 模型取得进展...
    视频模型# Kaleido# 智谱AI
    11个月前
    3000
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    BlitzBrowser

    BlitzBrowser

    BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
    海绵音乐

    海绵音乐

    海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
    SentrySearch

    SentrySearch

    SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
    Whisk

    Whisk

    Whisk 是谷歌最新的 Google Labs 实验,允许用户通过输入或创建传达主题、场景和风格的图像,轻松组合并重新混合这些元素,生成独一无二的作品。Whisk 结合了 Imagen 3 的图像生成能力和 Gemini 的视觉理解和描述能力,使用户能够以有趣的新方式探索创意。
    Adobe Firefly Video

    Adobe Firefly Video

    由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      BlitzBrowser

      BlitzBrowser

      BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
      海绵音乐

      海绵音乐

      海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
      SentrySearch

      SentrySearch

      SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
      Whisk

      Whisk

      Whisk 是谷歌最新的 Google Labs 实验,允许用户通过输入或创建传达主题、场景和风格的图像,轻松组合并重新混合这些元素,生成独一无二的作品。Whisk 结合了 Imagen 3 的图像生成能力和 Gemini 的视觉理解和描述能力,使用户能够以有趣的新方式探索创意。
      Adobe Firefly Video

      Adobe Firefly Video

      由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
      查看完整榜单