Zyphra 开源 ZONOS3-Mini:800M 总参 MoE TTS,仅 100M 激活参数,支持词级表达控制Zyphra 正式发布了 ZONOS3-Mini,一款专为本地设备实时推理设计的开源文本转语音(TTS)模型。该模型采用稀疏混合专家(MoE)架构,总参数量 8 亿,但在每次推理时仅激活约 1 亿参数...语音模型# ZONOS3-Mini# Zyphra6天前180
谷歌最强模型 Gemini 4 Carbon 全面上线,面向复杂长程任务与多智能体工作流的前沿模型11 月 10 日,谷歌正式向付费开发者、企业、科学家及 Google AI Ultra 订阅用户开放 Gemini 4 Carbon。作为谷歌目前能力最强的模型,Carbon 专为测试模型智能极限的...大语言模型早报# Gemini 4 Carbon# Google AI Ultra# 谷歌6天前190
MiniMax 发布开源图像模型H3-Image:6 步采样直出最高 1600 万像素图像,支持最多 16 张参考图11 月 10 日,MiniMax 正式宣布开源 MiniMax H3-Image 模型权重。作为 MiniMax H3 系列中专用于图像生成与编辑的顶尖模型,H3-Image 将智能意图理解与视觉世...图像模型# H3-Image# MiniMax6天前360
Anthropic 发布 Claude Fable 5.2 / Mythos 5.2:旗舰双模型,全维度超越 Opus 5.5、降价提速11 月 9 日,Anthropic 正式推出 Claude Fable 5.2 与 Claude Mythos 5.2。作为其产品线中定位最高端的模型系列,新版本在编码、推理、视觉及科学计算等领域均...多模态模型早报# Anthropic# Claude Fable 5.2# Claude Mythos 5.27天前260
AI 降临派开源Sophon-Realtime v1 :32B 全双工语音模型,听懂语气、自主生成笑 / 叹气等副语言AI降临派(Adventists AI)正式推出 Sophon-Realtime v1,这是一个基于 Apache-2.0 协议开源的全双工语音模型系列。该模型旨在提供拟真的实时语音交互体验:在用户说...语音模型# AI 降临派# Sophon-Realtime v1# 全双工语音模型7天前310
Meta 推出轻量高效模型 Muse Ember:面向 Agent 高频任务,百万上下文,性价比领先Meta 正式推出 Muse Ember,这是其当前体量最小、运行效率最高的模型,定位面向智能体高频重复的复杂推理任务,覆盖工具调用、编码子任务、请求路由、信息提取以及长文档解析场景。 在同等推理部署...大语言模型早报# Meta# Muse Ember7天前240
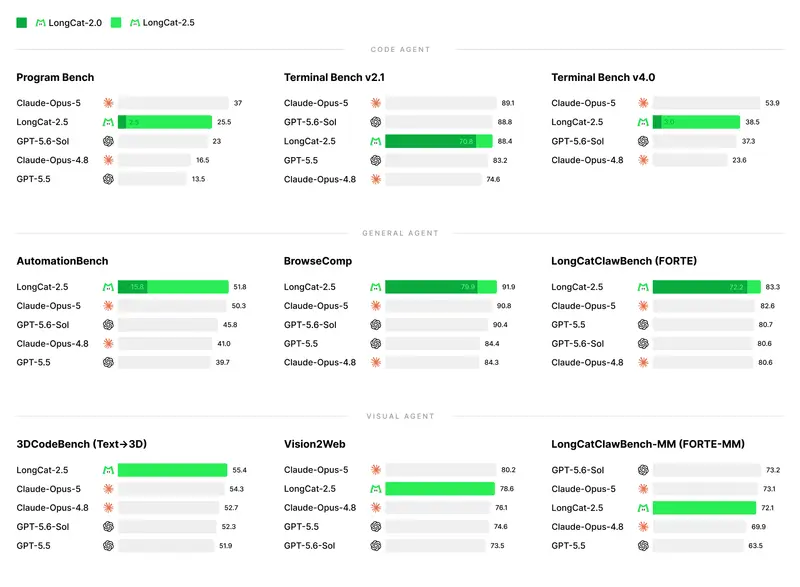
美团龙猫正式开源LongCat-2.5:原生多模态长程智能体模型,1M 上下文、MIT 协议可商用11月2日,美团龙猫对外发布适配长程智能体任务的原生多模态模型LongCat-2.5;11月9日,美团官宣该模型开源。 官方介绍:https://longcat.ai/blog/longcat-2.5...大语言模型# LongCat-2.5# 美团龙猫1周前310
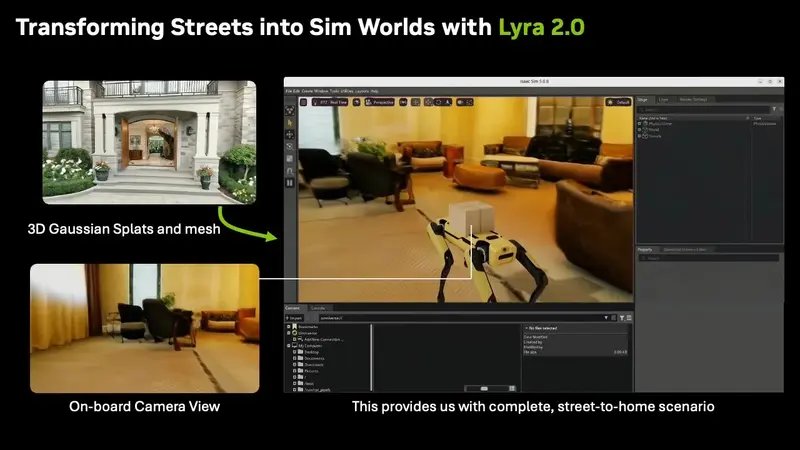
英伟达推出 Lyra 2.0:单图生成可漫游 3D 环境,攻克空间遗忘与时间漂移英伟达空间智能实验室(SIL)近期展示了 Lyra 2.0,这是一个 AI 驱动的框架,能够将单张静态照片转化为可探索的 3D 环境。该研究最初于 2026 年 4 月发表,目前英伟达正于 SIGGR...世界模型# Lyra 2.0# 英伟达1周前310
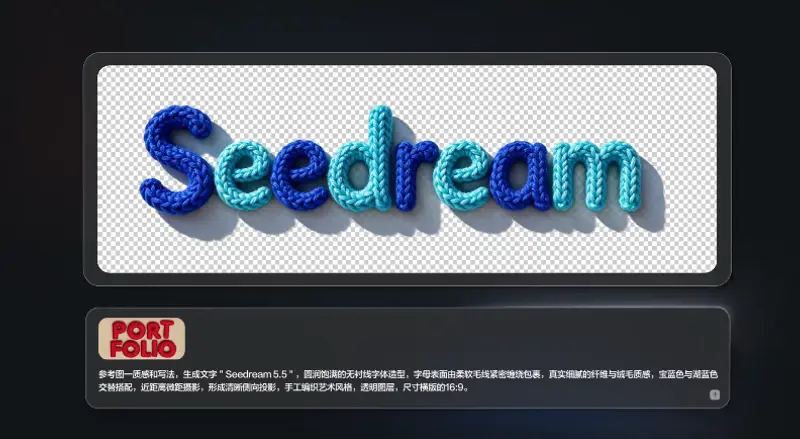
字节跳动发布 Seedream 5.5 图像模型:支持百轮像素级多轮编辑与原生 RGBA 输出2026年11月9日,字节跳动 Seed 团队正式发布新一代图像创作模型 Seedream 5.5。随着生成式 AI 逐步融入专业视觉生产流程,模型能否在交付标准、时间和成本的约束下持续产出可用结果...图像模型早报# Seedream 5.5# 字节跳动1周前450
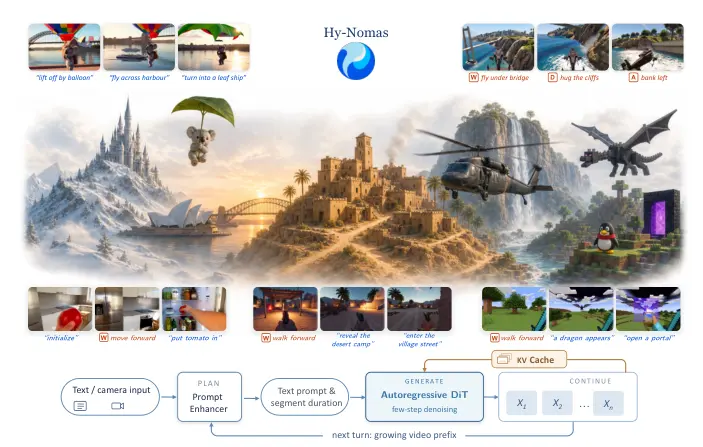
腾讯混元开源Hy‑Nomas:8B 交互式世界模型,文字 + 相机 WASD 混合操控,配套评测基准开源Hy‑Nomas 是腾讯混元团队推出的80亿参数交互式世界模型,基于HunyuanVideo1.5视频大模型改造,核心区别于传统一次性生成的文生视频:它可以维持一个连续的虚拟世界,在生成过程中持续接收...世界模型# Hy‑Nomas# 腾讯混元1周前230
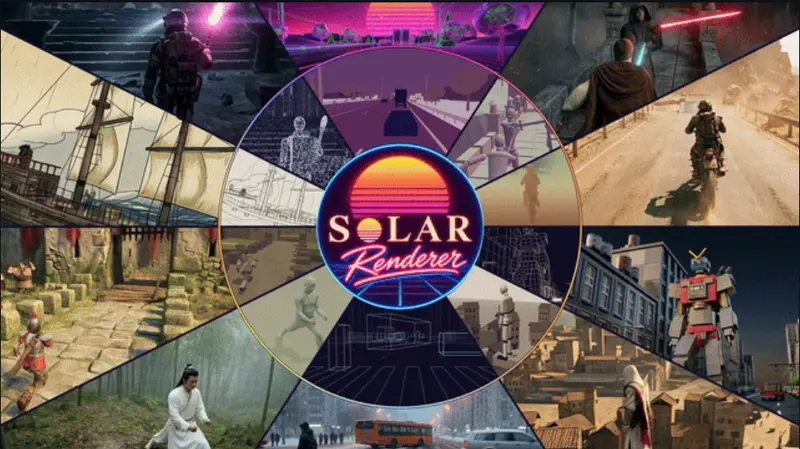
SolarRenderer:4 步生成式蓝图渲染框架,一套模型兼容简笔画 / 骨骼 / 线框等各类结构蓝图在游戏开发、影视预演及 AI 智能体内容创作中,创作者通常已提前规划好场景布局、物体摆放、人物动作轨迹及镜头运动。这些规划通常以结构蓝图的形式存在,如线框图、骨骼动作数据或灰度方块布局图,仅记录位置与...多模态模型# SolarRenderer1周前310
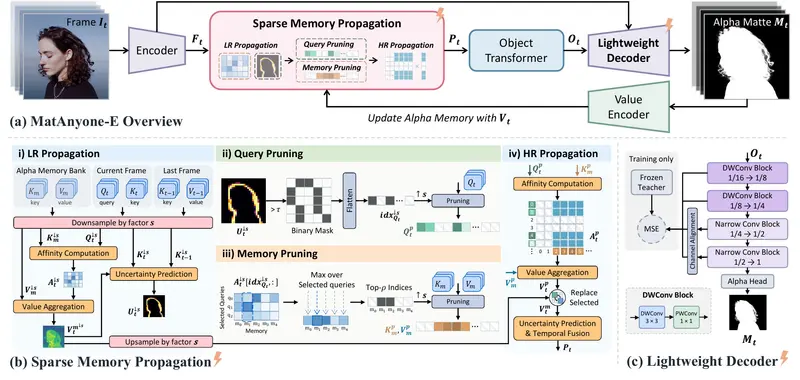
MatAnyone-E:基于稀疏记忆传播的高效高分辨率视频抠像模型,先低分辨筛不确定区域,仅局部做高精度匹配高分辨率视频抠像面临的核心矛盾在于:既要保留发丝、柔和透明度等细微视觉特征,又要维持严格的帧间时序一致性。传统的基于记忆(Memory-based)的方法通过将当前帧特征与早期帧存储的信息进行全局匹配...视频模型# MatAnyone-E# 视频抠像1周前270