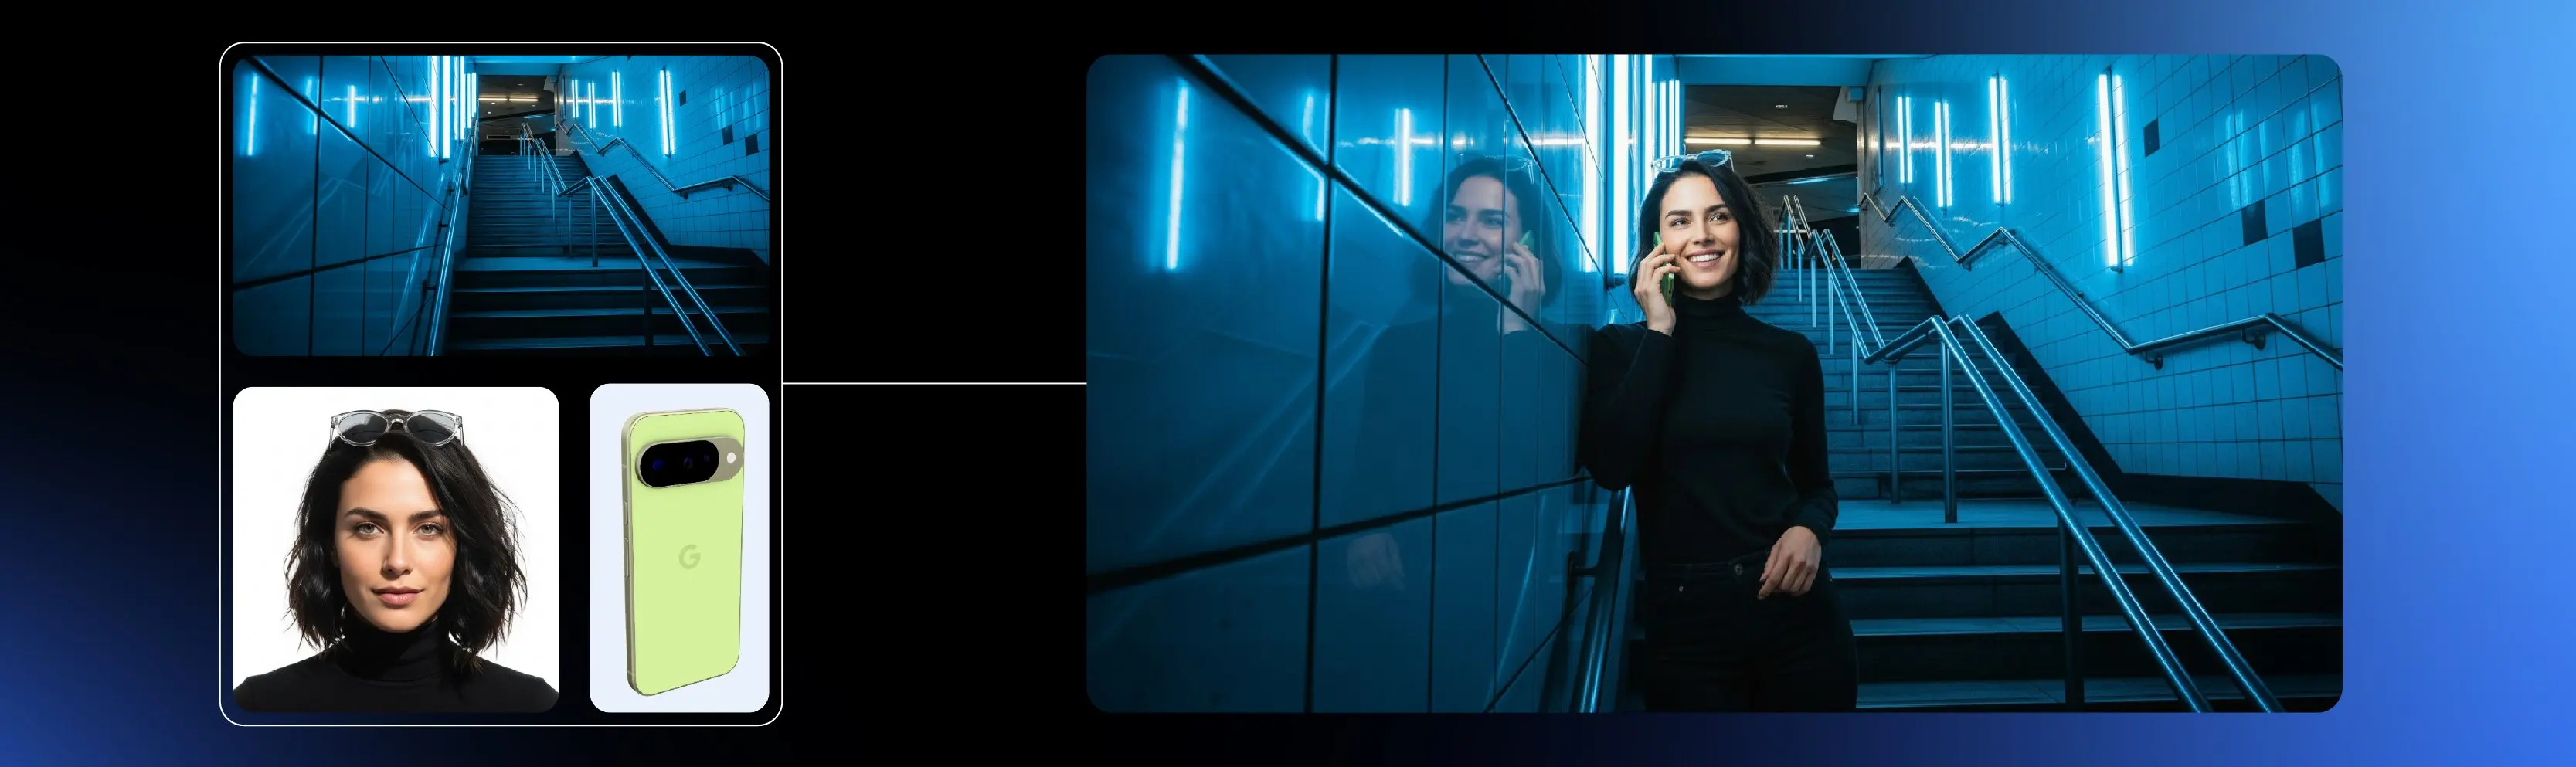
nano-banana正式版!谷歌发布全新图像模型Gemini 2.5 Flash Image,更精准的 AI 图像编辑谷歌正在为其 Gemini 聊天机器人引入一项重要升级:全新的 AI 图像模型 Gemini 2.5 Flash Image。该模型不仅提升了图像生成质量,更在编辑精度、角色一致性与多图融合方面实现了...图像模型# AI 图像编辑# Gemini 2.5 Flash Image# nano-banana1年前8500
Chroma 模型家族正式发布:基于 FLUX.1-schnell,8.9亿参数开源无限制,4大分支适配不同需求开发者 lodestones 近期宣布,基于 FLUX.1-schnell 构建的 8.9 亿参数生成模型 Chroma 已完成全部基础训练,正式开放供开发者与研究者使用。作为完全遵循 Apache ...图像模型# Chroma# FLUX.1 [schnell]1年前1,8860
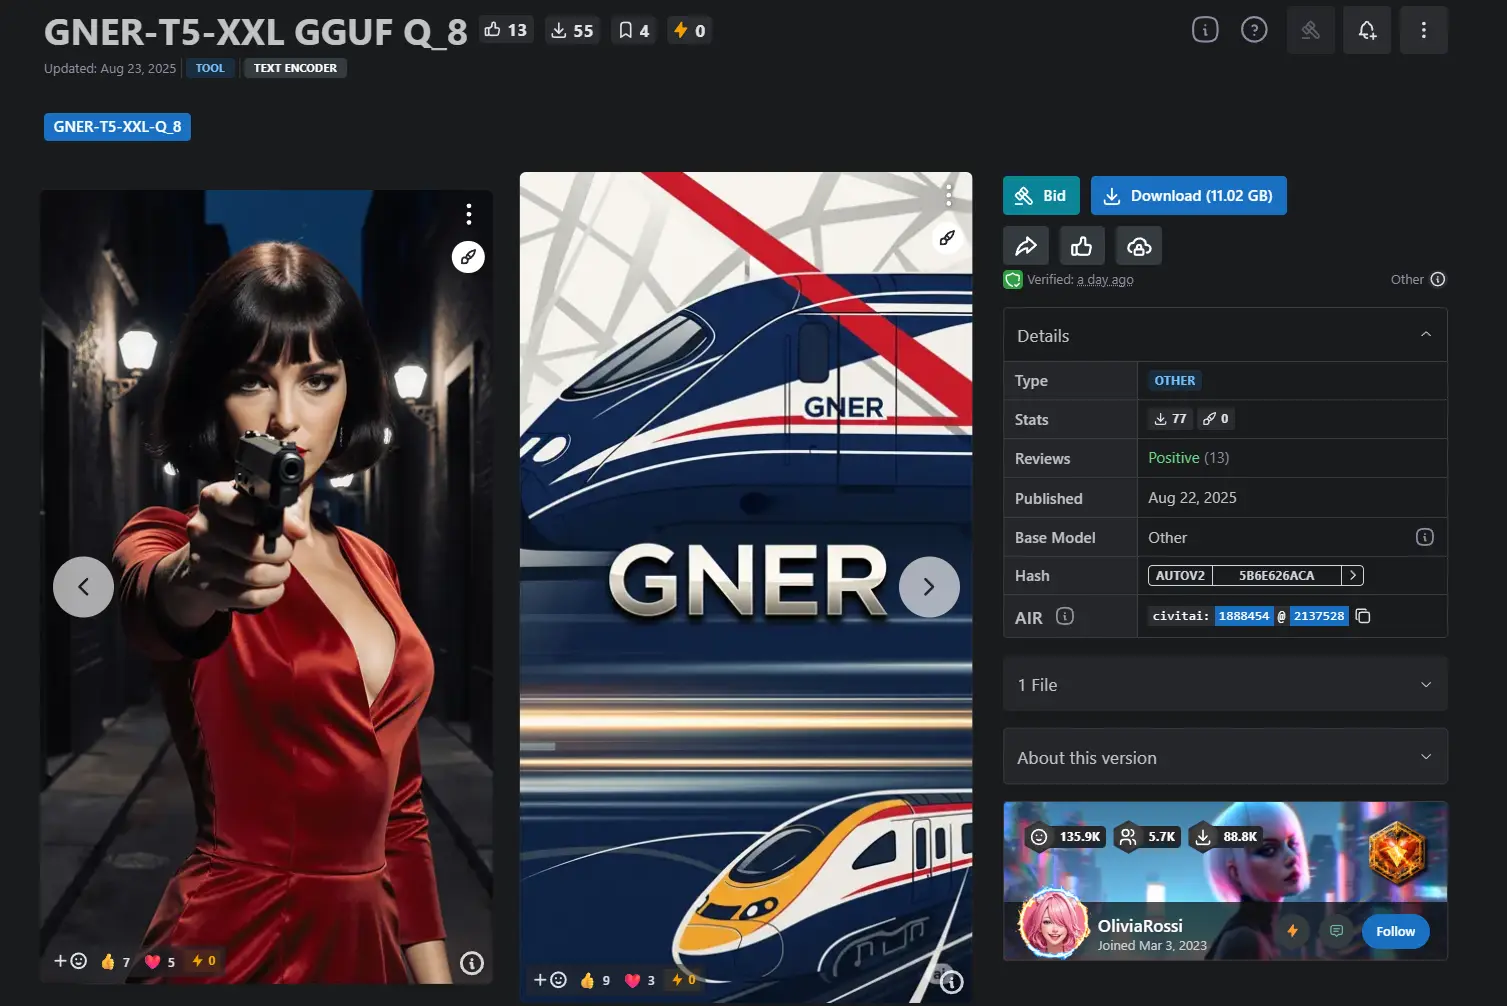
GNER-T5-XXL:GNER 提升零样本实体识别能力,可用于 Flux、Chroma 等模型在多模态生成系统中,精准识别文本中的关键语义元素,是生成高质量图像或内容的前提。例如,当输入提示词“一位身着红色礼服的女人,手持手枪,站在黑暗小巷中”,模型需要准确识别出“红色礼服”“手枪”“黑暗小巷...图像模型# Chroma# FLUX# GNER-T5-XXL1年前6940
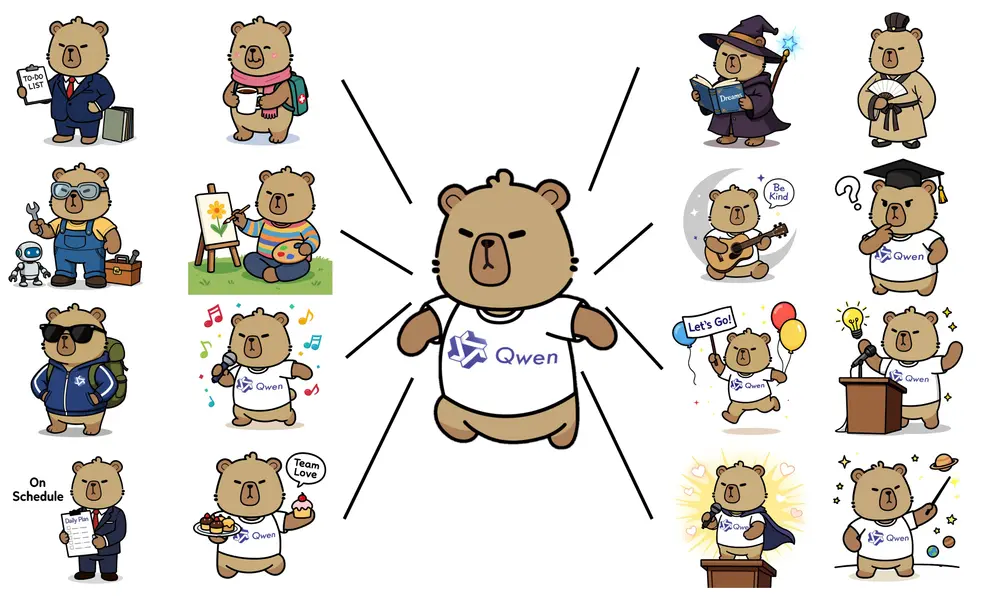
阿里 Qwen 团队发布Qwen-Image-Edit:支持语义与外观双重编辑的图像编辑模型阿里Qwen项目组今日正式推出 Qwen-Image-Edit,基于 Qwen-Image 20B 模型进一步训练而成,是 Qwen-Image 系列在图像编辑方向的重要延伸。 该模型不仅继承了 Qw...图像模型# Qwen-Image-Edit# 图像编辑模型1年前5550
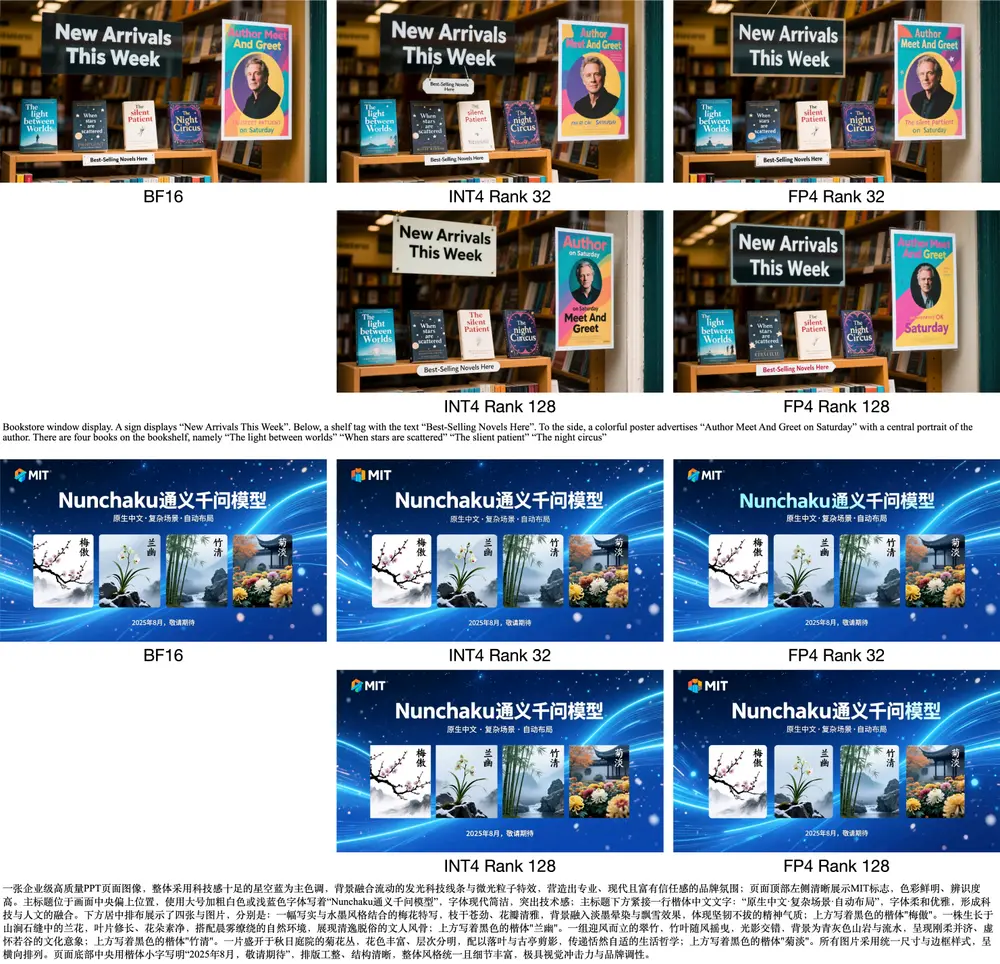
Nunchaku发布量化版Qwen-Image模型,支持高效图像生成Nunchaku 官方宣布,其基于Qwen-Image的四个量化版本模型已正式上线 Hugging Face和魔塔!这些模型专为高效文本到图像生成而优化,尤其在复杂文本渲染方面表现突出。 Huggin...图像模型# Nunchaku# Qwen-Image1年前1,0030
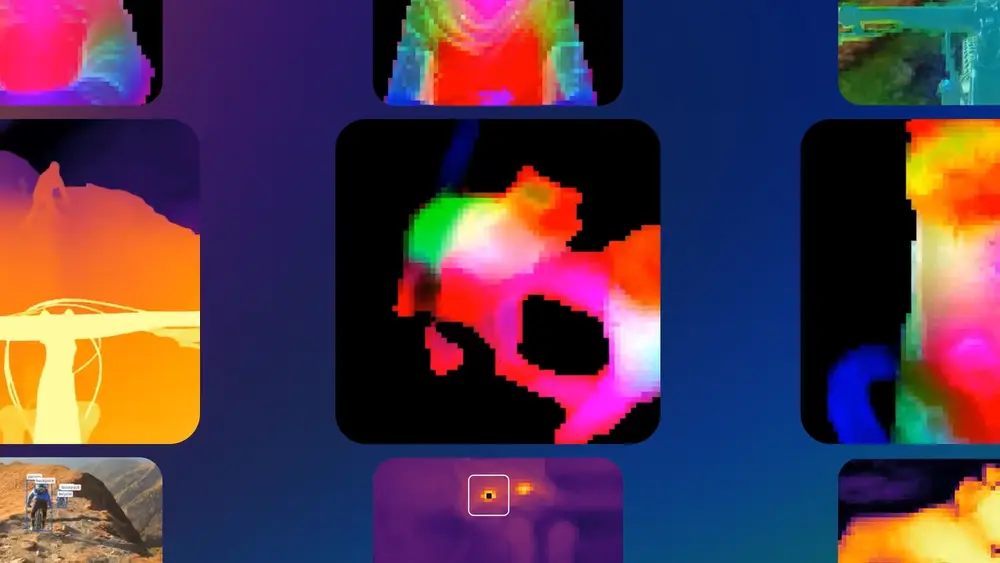
Meta AI 发布 DINOv3:无需微调、无需标注的下一代视觉模型Meta AI 正式推出 DINOv3 —— 一项在计算机视觉领域具有里程碑意义的自监督学习模型。它不仅刷新了密集预测任务的性能上限,更首次证明:一个通用、冻结的视觉骨干,可以在无需微调的情况下,在多...图像模型# DINOv3# 视觉模型1年前9500
阶跃星辰发布 NextStep-1:140 亿参数自回归模型,用“连续令牌”重塑图像生成在图像生成领域,自回归模型长期被视作“文本专家,视觉弱项”——它们擅长逐词生成语言,却难以像扩散模型那样精细构建图像。而如今,阶跃星辰(StepFun)正试图打破这一边界。 GitHub:https...图像模型# NextStep-1# 图像生成# 图像编辑1年前7880
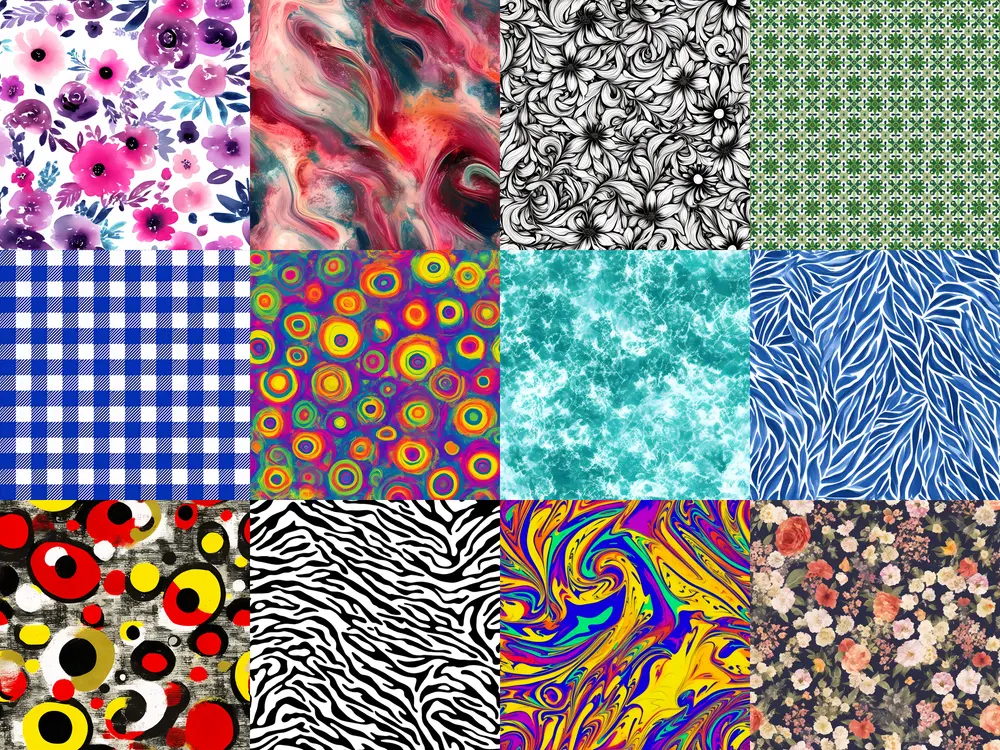
Pattern Diffusion:专为无缝图案生成而生的扩散模型由开发者 Alex Reid 推出的 Pattern Diffusion,是一个专为生成可平铺(tiling)表面图案而从零训练的扩散模型。它基于 Stable Diffusion 2-Base 架构...图像模型# Pattern Diffusion# 无缝图案1年前6350
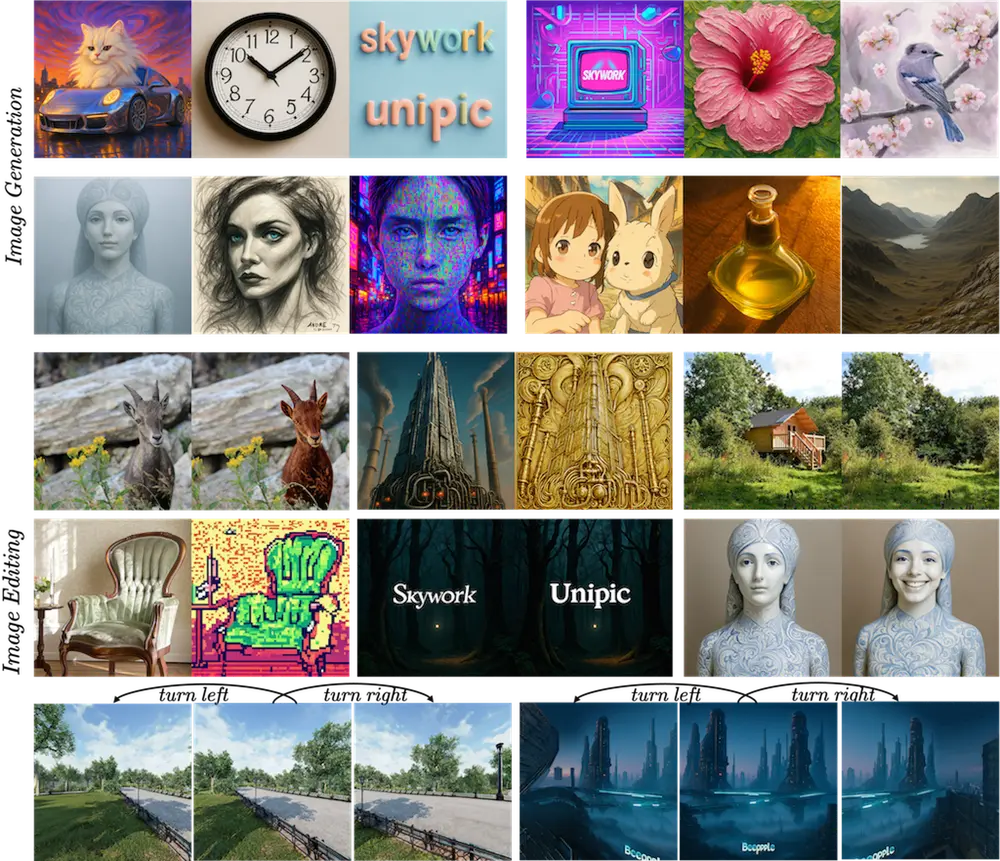
天工AI发布 UniPic-2.0:轻量高效、统一多模态图像生成与编辑新范式天工AI正式推出 UniPic-2.0 系列模型,基于 SD3.5-Medium 架构与创新训练策略,在文本到图像生成、细粒度图像编辑和多模态理解任务中实现全面性能突破。 GitHub:https...图像模型# UniPic-2.0# 天工AI1年前7120
LEGION:一个能“看懂”伪造痕迹并指导图像优化的多模态分析框架随着生成模型的飞速发展,AI 合成图像已变得越来越逼真。然而,这种进步也带来了严峻挑战:虚假内容泛滥、误导信息传播、数字信任危机加剧。 作为应对,合成图像检测技术应运而生。但当前方法普遍存在三大局限...图像模型# LEGION# 多模态分析框架1年前3610
X-Omni:腾讯混元提出统一图像与语言生成的离散自回归新模型“能否用同一个模型,既写诗又作画?”这是多模态模型长期以来追求的目标。 近年来,研究者尝试将语言模型中成功的“下一 token 预测”范式扩展到图像领域,构建统一的离散自回归模型,期望实现图像生成与语...图像模型# X-Omni# 自回归模型1年前4300
上海大学联合vivo推出新型交互式图像抠图方法SDMatte:用扩散模型重新定义交互式抠图上海大学与 vivo 联合研究团队近期提出一种名为 SDMatte 的新型交互式图像抠图方法。该方法基于稳定扩散模型(Stable Diffusion),支持点、框和掩码三种视觉提示,能够从自然图像中...图像模型# SDMatte# 图像抠图1年前9470