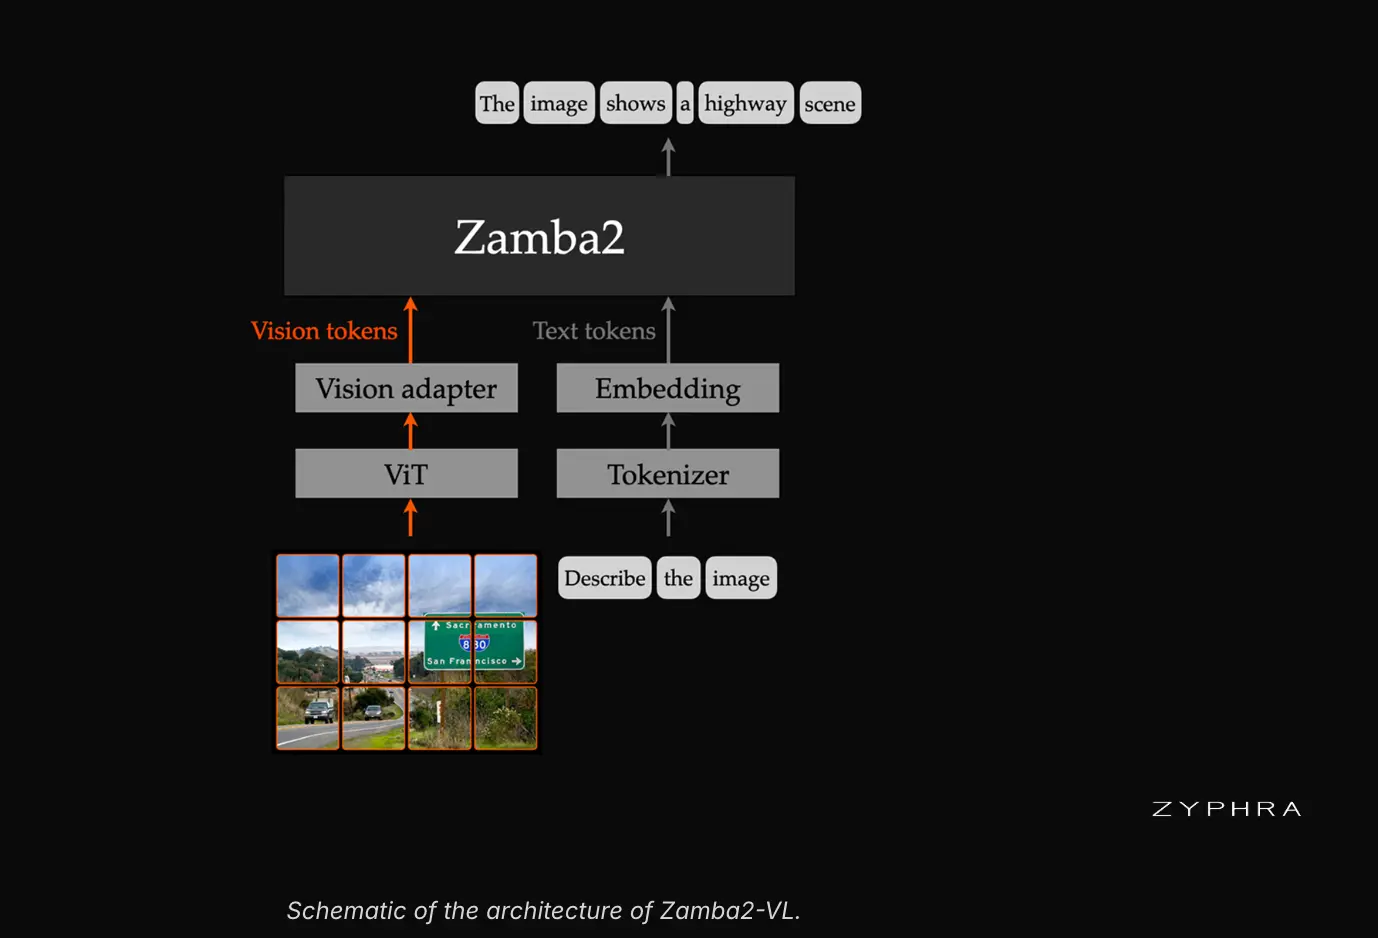
Zyphra 发布 Zamba2-VL:开源混合 Mamba2-Transformer 视觉语言模型,首 Token 延迟降低一个数量级,支持 1.2B/2.7B/7B 多规模边缘部署在多模态大模型日益普及的今天,高昂的计算成本与漫长的首字延迟(TTFT)仍是阻碍其实时交互与端侧落地的主要障碍。Zyphra 正式发布了 Zamba2-VL,这是首个基于完全开源的混合 Mamba2...多模态模型# Zamba2-VL# Zyphra5个月前2240
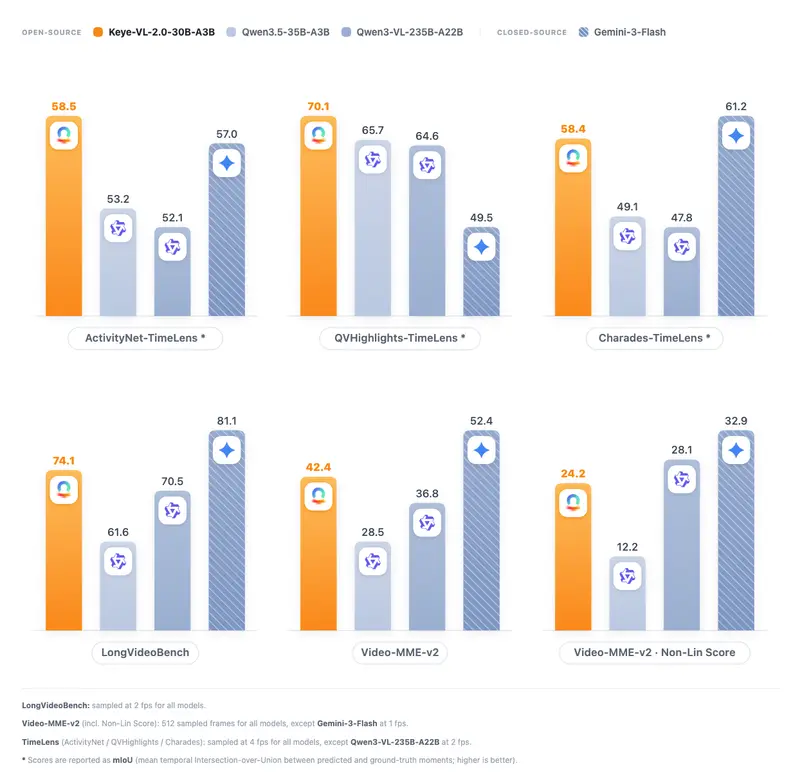
快手 Keye 发布 Keye-VL-2.0-30B-A3B:300 亿参数多模态旗舰,DSA 架构支持 1 小时长视频无损理解,时间定位能力媲美 Gemini-3-Flash快手 Keye 团队正式发布了 Keye-VL-2.0-30B-A3B,这是 Keye 系列最新的 300 亿参数旗舰基础模型。作为首个在生产环境中落地 DSA(动态稀疏注意力) 架构的多模态模型,它...多模态模型# Keye-VL-2.0-30B-A3B# 快手 Keye5个月前2280
阿里发布 Qwen3.7-Plus:首个视觉与语言统一的多模态智能体基座,支持 GUI/CLI 混合交互、端到端代码生成及 11+ 小时自主 APP 研发闭环阿里巴巴今日正式发布 Qwen3.7-Plus,这是一款将视觉与语言深度融合的多模态智能体基座模型。在继承 Qwen3.7 强大文本与编码能力的基础上,Qwen3.7-Plus 实现了从“被动理解”到...多模态模型# Qwen3.7-Plus5个月前2060
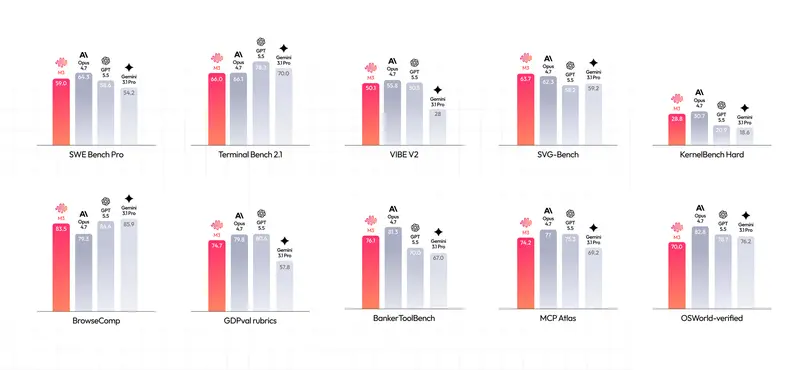
MiniMax M3 正式发布:首个集前沿编码、100万上下文与原生多模态于一身的开放权重模型,MSA 架构实现推理速度 15 倍加速MiniMax M3 正式发布,M3 在编码和代理工作等专门任务上达到了前沿水平的性能。它采用了MiniMax团队提出的全新注意力架构 MSA,并支持高达 100 万 token 的超长上下文窗口。备...多模态模型# MiniMax M35个月前1940
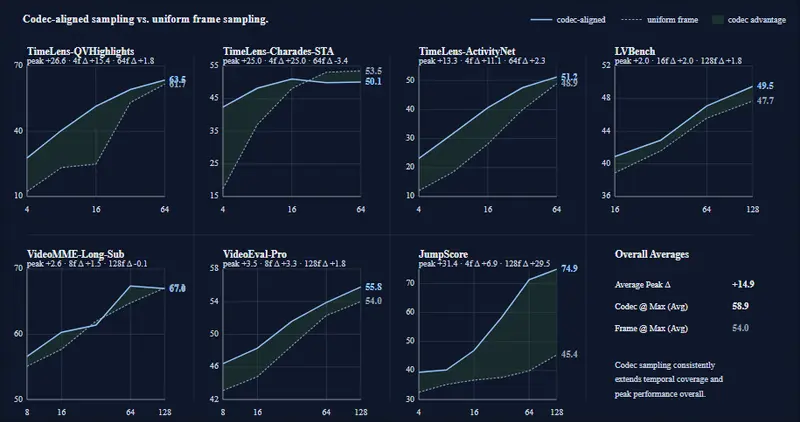
LLaVA-OneVision-2:首个“读懂”视频编码的 8B 多模态模型,抛弃均匀抽帧,长视频与时序定位能力代际领先LLaVA-OneVision-2 (LLaVA-OV-2) 是 LLaVA 家族的新一代里程碑式作品。作为一个完全开放的 80 亿参数多模态大模型,它基于 Qwen3-8B 语言骨干,首创性地引入了...多模态模型# LLaVA-OneVision-25个月前2180
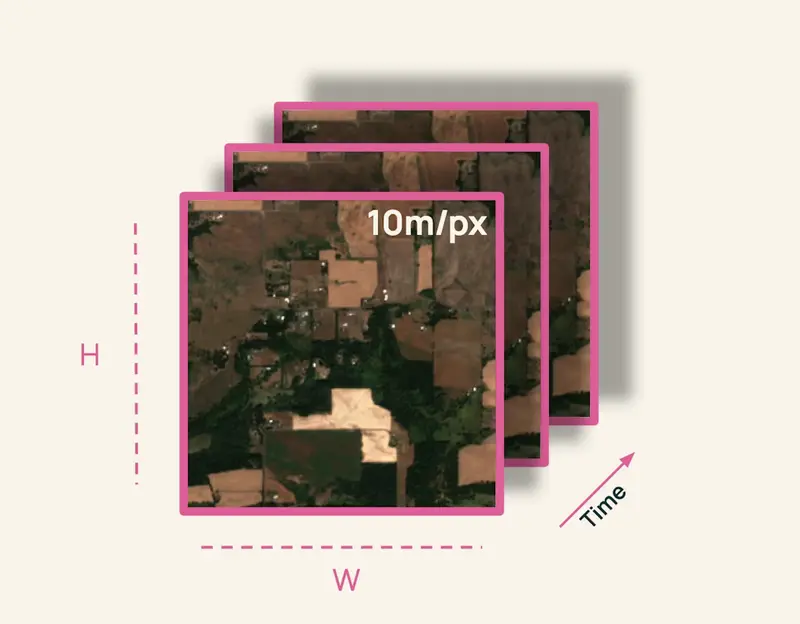
AllenAI 发布 OlmoEarth v1.1:计算成本降低 3 倍,高效赋能全球卫星遥感分析2025 年 11 月,AllenAI 发布了专注于地球观测的开源模型家族 OlmoEarth v1。自发布以来,该模型已被广泛应用于追踪红树林变化、分类森林损失驱动因素以及生成国家级作物类型地图等关...多模态模型# OlmoEarth5个月前2310
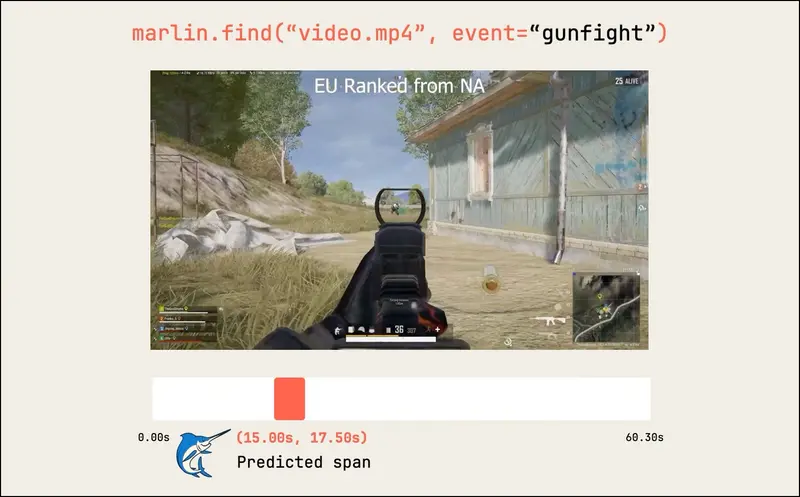
Nemostation 发布 Marlin:2B 参数视频模型,低成本实现高精度事件提取与时间定位在视频大模型(Video VLM)领域,高昂的算力成本和庞大的模型体积往往是落地应用的最大阻碍。近日,Nemostation 推出了 Marlin——一款仅拥有 20 亿(2B)参数的微型视频视觉语言...多模态模型# Marlin# Nemostation5个月前3050
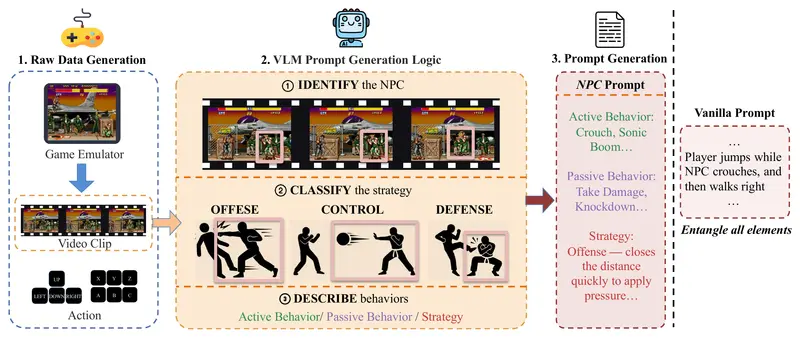
腾讯联合多所高校发布 ReactiveGWM:让游戏 NPC 具备跨游戏迁移的自主策略能力由腾讯、新加坡国立大学、香港理工大学、香港科技大学(广州)、中国科学院大学及香港科技大学的研究团队共同推出的 ReactiveGWM,正在重新定义游戏世界模型中非玩家角色(NPC)的行为逻辑。 项目主...多模态模型# ReactiveGWM# 游戏# 腾讯5个月前2710
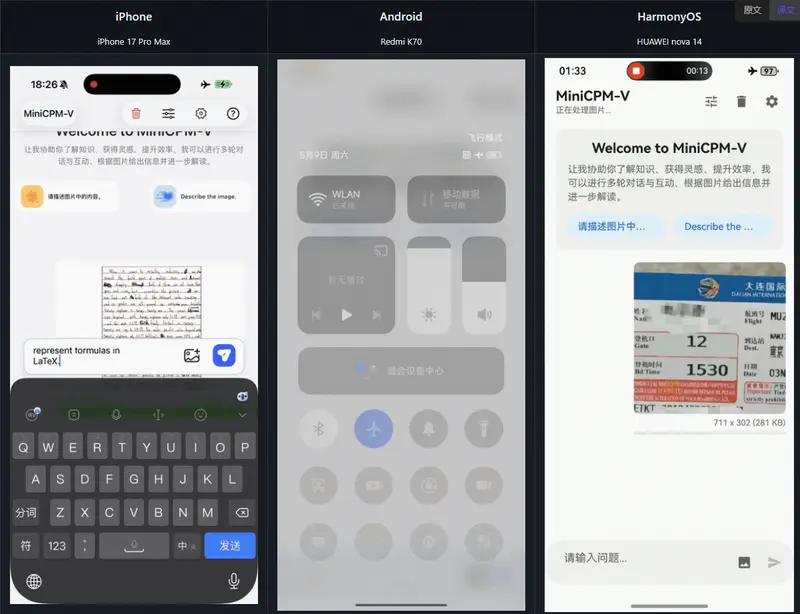
面壁智能发布MiniCPM-V 4.6:0.8B 参数实现 Qwen2B 级性能,全面支持 iOS/Android/HarmonyOS 原生部署在移动设备算力有限但多模态需求日益增长的今天,如何在手机端实现高精度、低延迟的图像与视频理解?MiniCPM-V 4.6 是由面壁智能最新发布的边缘部署友好型多模态大模型。它基于 SigLIP2-40...多模态模型# MiniCPM-V 4.6# 面壁智能5个月前2270
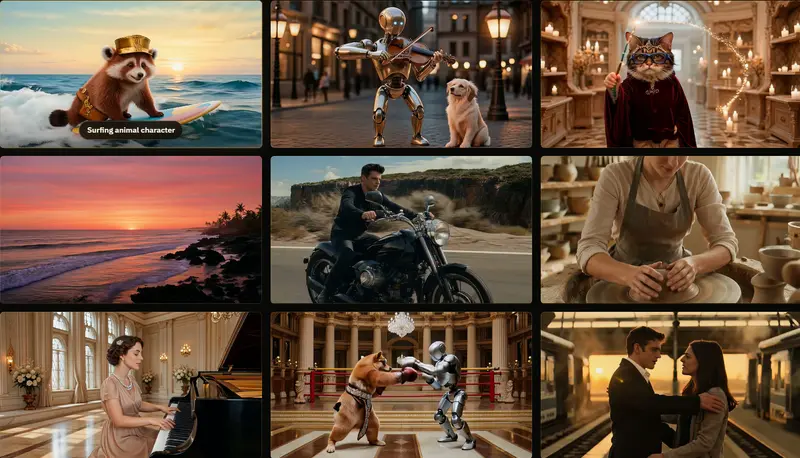
字节跳动发布Lance:重塑多模态 AI,一款 3B 参数实现理解/生成/编辑全统一的轻量级模型在当前 AI 领域,多模态模型往往面临“理解强则生成弱”、“功能单一且训练昂贵”的困境。Lance 是由字节跳动最新发布的轻量级、原生统一多模态模型。它仅凭 30 亿(3B)激活参数,便在单一框架下同...多模态模型# Lance# 字节跳动5个月前2420
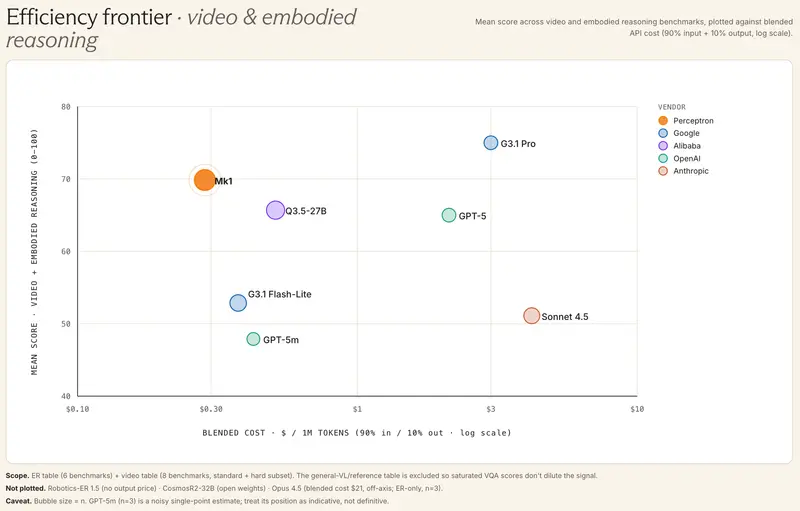
Perceptron发布Mk1:视频分析成本降低 90%,以“物理 AI”重构时空推理,性能比肩 GPT-5 与 Gemini 3.1 Pro在传统视觉语言模型(VLM)中,视频往往被简化为不连续的静态图像序列,导致模型难以理解因果关系、物体动态及时间连续性。Perceptron Mk1 应运而生——这是由 Meta FAIR 前科学家 A...多模态模型# Perceptron Mk15个月前1850
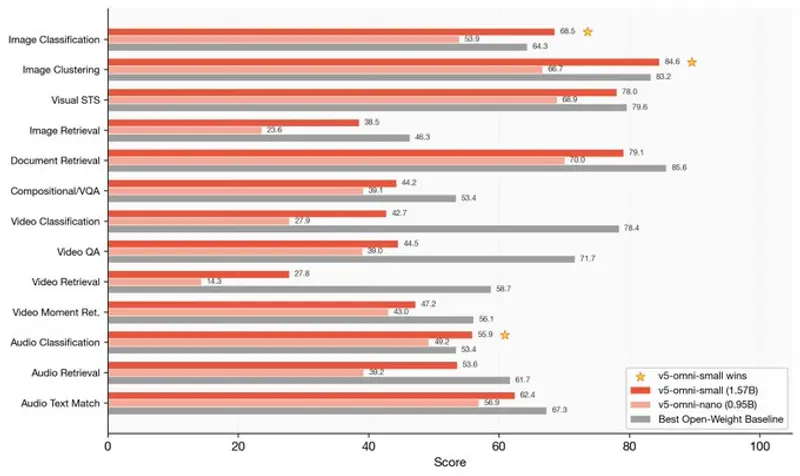
Jina AI 发布 jina-embeddings-v5-omni:文本向量字节级一致,无需重建索引即可实现图文音视跨模态检索,Small 模型性能媲美 LCO-7B在多模态检索领域,传统方案往往要求端到端重训整个模型,导致文本向量分布改变,迫使企业重建海量文本索引。Jina AI 正式发布 jina-embeddings-v5-omni,彻底打破这一困境。 官方...多模态模型# Jina AI# jina-embeddings-v5-omni6个月前2430