2026 年 8 月 31 日,深度求索(DeepSeek)正式在 Hugging Face 开源了其 V4 系列的首个多模态实验版本——DeepSeek-V4-Flash-Vision-Exp。该模型采用 MIT License 完全开源,不仅提供了模型权重,还公开了 Tokenizer、Prompt Encoding 参考实现以及最小化的 PyTorch 推理代码,涵盖了视觉编码器、Aligner、DFlash Attention、MoE、Hyper-Connections 与 DSpark 等核心模块。
- 模型:https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-Vision-Exp
核心亮点
- 原生多模态支持:
- 作为 V4 系列首款原生支持图片输入的模型,它能够处理 JPEG、PNG、GIF、WebP 等多种格式。
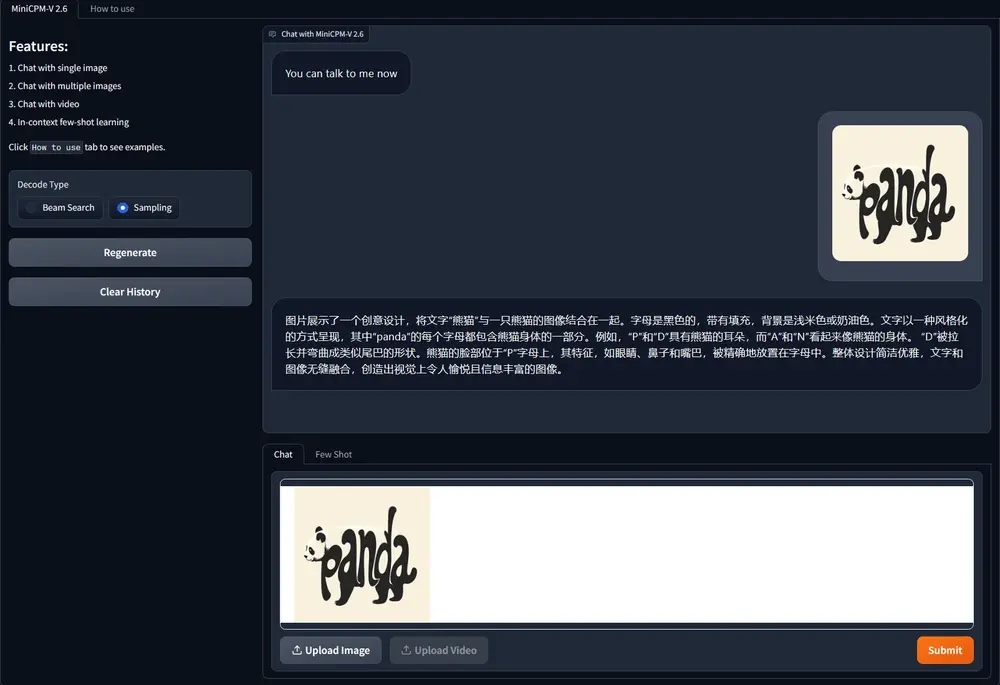
- 具备强大的视觉理解能力,包括图片描述、截图文字识别(OCR)、图表分析等。
- 性能比肩顶尖闭源模型:
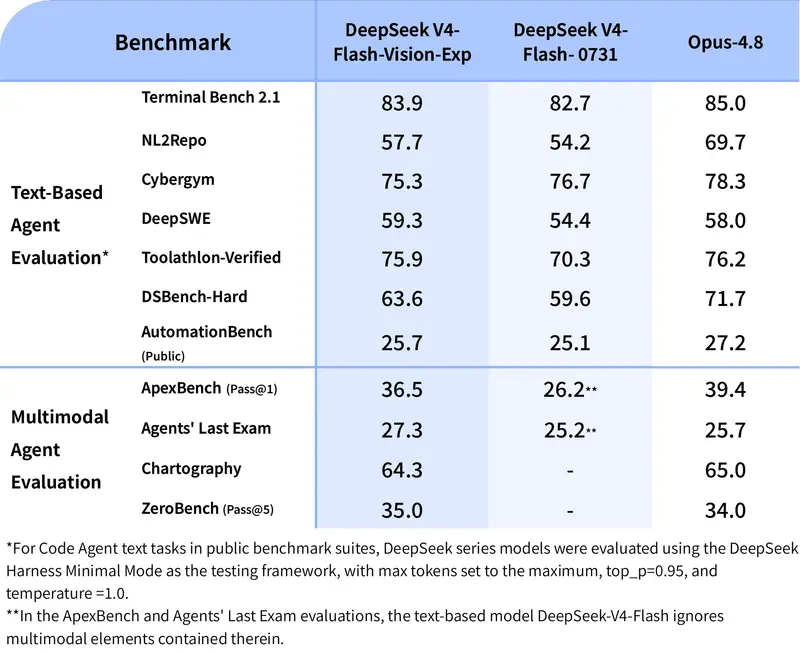
- 在纯文本任务(Agent、推理、世界知识)上,保持与 V4-Flash 正式版 持平的高水准。
- 在多模态 Agent 基准测试中表现卓越,能力已接近 Claude Opus-4.8,显著优于前代 V4-Flash。
- 极佳的 Agent 适配性:
- 官方强调其在各类 Agent 框架内的多模态适配能力,能够有效支持开发者利用多样化的工具解锁更复杂的工作场景(如自动分析报表、视觉导航等)。
- 完全开源与透明:
- 遵循宽松的 MIT 协议,允许商业使用和研究。
- 开源内容极其详尽,从底层架构模块(如 DSpark、Hyper-Connections)到最小化推理实现,为社区提供了深入研究和二次开发的宝贵资源。
技术架构概览
DeepSeek-V4-Flash-Vision-Exp 延续了 V4 系列的高效架构,并针对视觉任务进行了专项优化:
| 模块 | 作用 |
|---|---|
| Visual Encoder | 负责将输入的图片转换为高维特征向量。 |
| Aligner | 将视觉特征与语言模型的语义空间进行对齐。 |
| DFlash Attention | 高效的注意力机制,提升长上下文和多模态融合的处理速度。 |
| MoE (Mixture of Experts) | 混合专家架构,确保在增加视觉能力的同时保持推理的高效性。 |
| Hyper-Connections | 增强层间信息流动,提升模型对复杂多模态指令的理解。 |
| DSpark | 分布式训练与推理优化组件,支持大规模并行计算。 |
适用场景
- 智能文档处理:自动提取扫描件或截图中的关键信息与数据。
- 数据分析助手:快速解读复杂的商业图表、趋势图并生成总结报告。
- 多模态 Agent 开发:构建能够“看”懂界面、识别物体并执行操作的自动化智能体。
- 内容创作与审核:辅助生成图片描述、识别违规视觉内容。
© 版权声明
文章版权归作者所有,未经允许请勿转载。