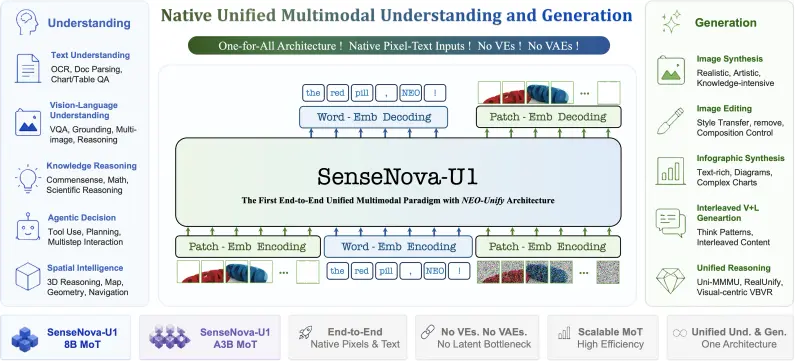
商汤科技(SenseTime)正式发布了全新一代原生多模态模型系列 SenseNova-U1。该系列基于全新的 NEO-Unify 架构,在单一模型中实现了多模态理解、推理与生成的真正统一,标志着多模态 AI 从“模态集成”向“原生统一”的范式转变。
- GitHub:https://github.com/OpenSenseNova/SenseNova-U1
- 模型:https://huggingface.co/collections/sensenova/sensenova-u1
SenseNova-U1 不再依赖传统的视觉编码器(VE)与变分自编码器(VAE)进行模态翻译,而是以原生方式跨语言与视觉进行思考与行动,开启从数据驱动学习向智能体学习(Agent Learning)进化的新篇章。
核心架构:NEO-Unify
NEO-Unify 是从第一性原理出发设计的多模态 AI 架构,其核心理念是像素与文字信息在本质上是深度相关的。
- 端到端统一建模:摒弃了传统的 VE+LLM+VAE 拼接模式,将语言与视觉信息作为统一整体进行端到端建模。
- 像素级保真与语义丰富度并存:在保留高维度语义理解能力的同时,维持极高的视觉生成保真度。
- 原生 MoT (Mixture of Thoughts):通过原生的混合思维机制实现高效的跨模态推理,显著减少模态间的冲突与损耗。
能力突破
1. 开源 SOTA 性能
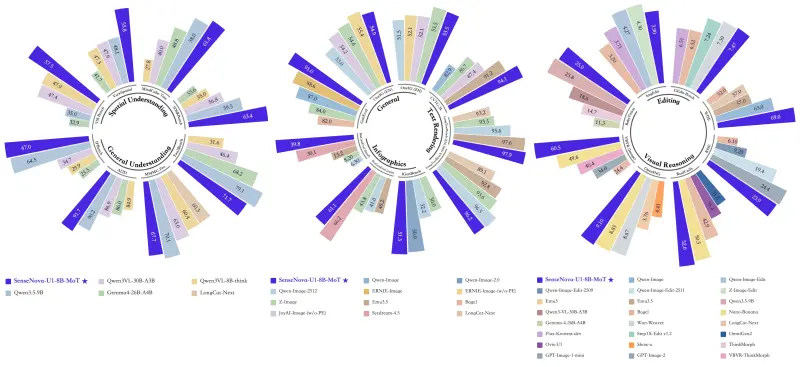
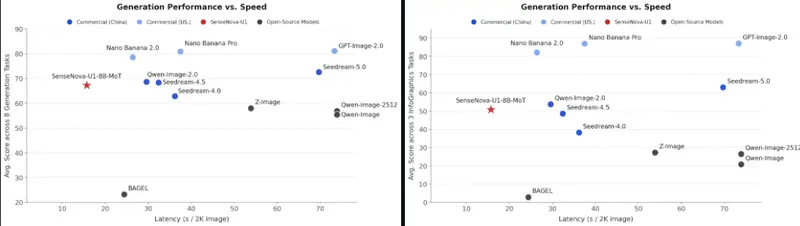
SenseNova-U1 在多种多模态理解、推理及生成基准测试中均达到开源模型最先进水平(SoTA),性能比肩顶尖商用闭源模型,展现出极高的性价比。
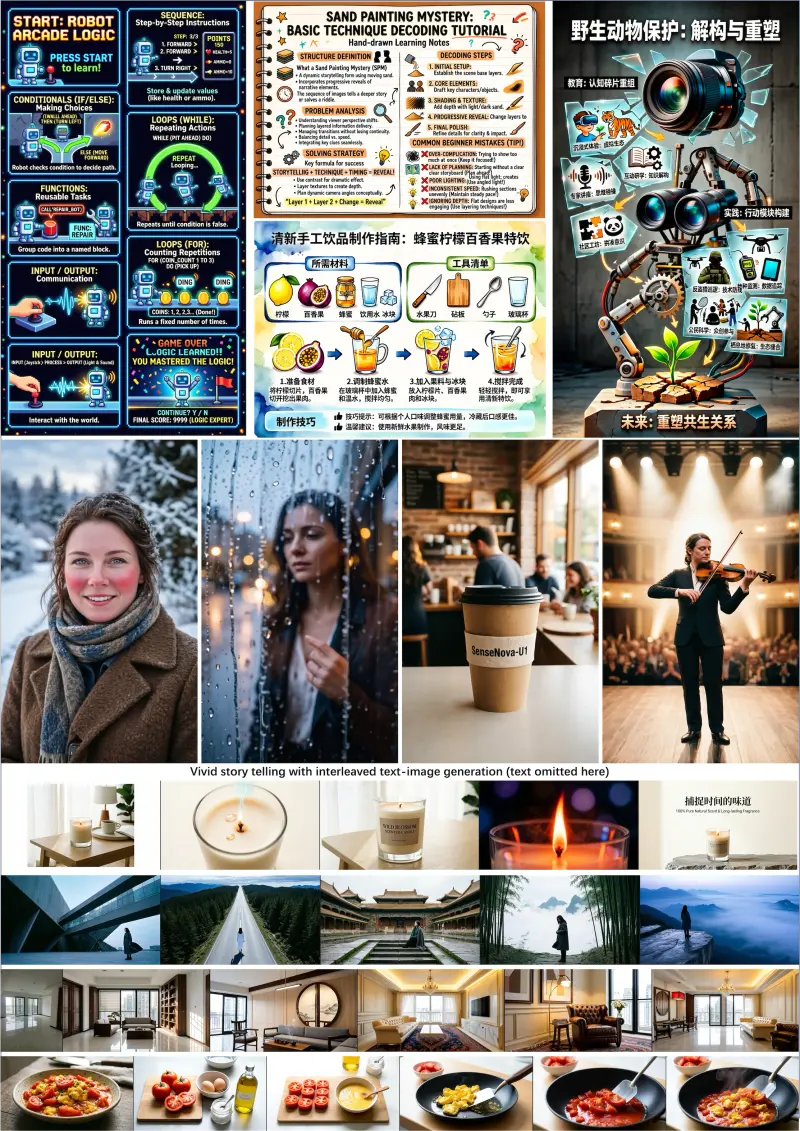
2. 原生图文交错生成
- 单次流程连贯产出:支持在单次生成过程中自然地产出图文交错的内容。
- 叙事性与表现力:特别适用于生活指南、旅行日记等需要清晰表达且富有感染力的场景,能将复杂信息浓缩为直观的图示。
3. 高密度信息呈现
- 复杂排版能力:能够生成结构丰富、排版复杂的高密度视觉内容。
- 应用场景广泛:适用于知识图解、海报设计、PPT 制作、漫画创作及简历优化等信息密集型任务。
4. 迈向 VLA 与世界建模
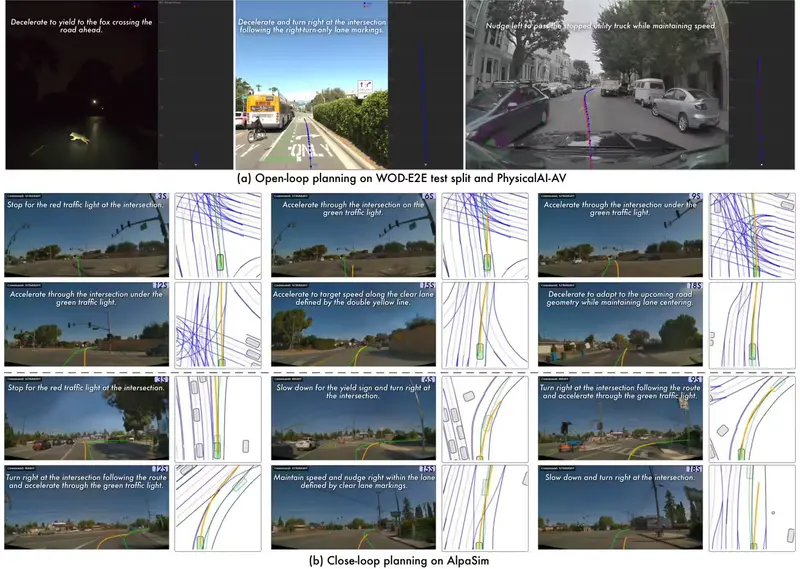
SenseNova-U1 的能力不仅限于图文,更为未来的 视觉-语言-动作(VLA) 协同及 世界建模(World Modeling) 奠定了坚实基础,助力 AI 向具身智能演进。
开源模型家族
本次发布开源了 SenseNova U1 Lite 系列,包含密集主干网络与 MoE 主干网络两种规格,兼顾性能与效率。
| 模型名称 | 参数量/架构 | 特点 | Hugging Face 权重 |
|---|---|---|---|
| SenseNova-U1-8B-MoT | 8B (密集) | 标准版,平衡性能与资源消耗 | 🤗 Link |
| SenseNova-U1-8B-MoT-SFT | 8B (密集) | 经过四阶段训练及 T2I 强化学习 | 🤗 Link |
| SenseNova-U1-A3B-MoT | A3B (MoE) | 激活参数量少,推理速度更快 | 🤗 Link |
| SenseNova-U1-A3B-MoT-SFT | A3B (MoE) | MoE 架构强化学习版,高效能首选 | 🤗 Link |
注:SFT 模型经过理解预热、生成预训练、统一中期训练、统一监督微调四个阶段,并额外进行了一轮 T2I 强化学习(RL),采用 ×32 下采样比例。
技术意义
SenseNova-U1 的发布解决了传统多模态模型中“理解强则生成弱,生成强则理解弱”的痛点。通过 NEO-Unify 架构,它证明了在紧凑的参数规模下,依然可以实现高质量的原生多模态统一。
这不仅为开发者提供了强大的开源基座,也为未来构建具备长期记忆、复杂推理及物理世界交互能力的智能体(如 OpenClaw 等框架所追求的愿景)提供了核心的认知引擎。
© 版权声明
文章版权归作者所有,未经允许请勿转载。