LLaDA2.0-Uni 是由蚂蚁集团Inclusion AI推出的最新一代多模态人工智能模型。它基于混合专家(MoE)架构,创造性地将多模态理解与生成能力统一在一个单一的扩散大语言模型(dLLM)中。
- GitHub:https://github.com/inclusionAI/LLaDA2.0-Uni
- HuggingFace:https://huggingface.co/inclusionAI/LLaDA2.0-Uni
- ModelScope:https://modelscope.cn/models/inclusionAI/LLaDA2.0-Uni
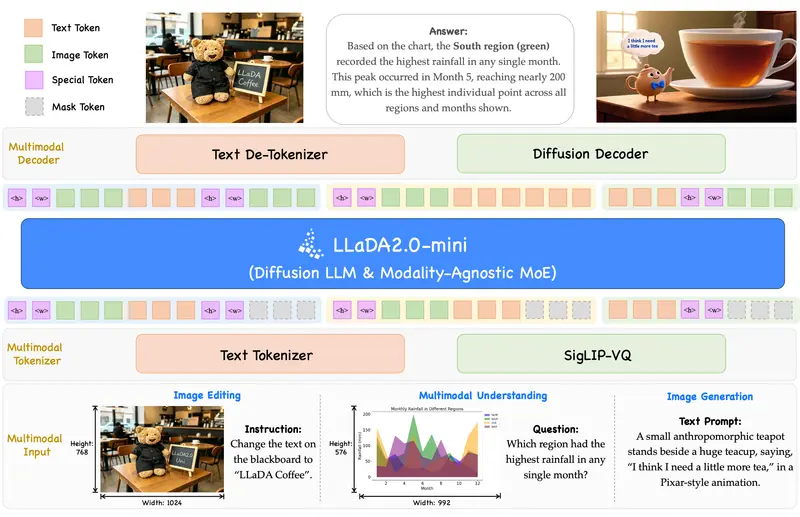
不同于传统“偏科”的 AI 模型(要么只会看图,要么只会画图),LLaDA2.0-Uni 实现了“看图、画图、改图、推理”的一体化,通过统一的掩码标记预测范式,解决了理解与生成分家、效率低下及细节缺失的行业痛点。
核心功能:一个模型,全能覆盖
1. 高保真文生图 (Text-to-Image)
- 思维链生成:支持可选的“思维/推理”过程,在生成图像前先进行逻辑规划,确保画面符合物理常识与用户意图。
- 精准还原:在物体位置、颜色、数量及文字生成上表现卓越,显著减少“AI 幻觉”。
2. 深度多模态理解 (Image Understanding)
- 复杂任务处理:支持视觉问答 (VQA)、图像描述生成、文档理解、图表识别及数学逻辑推理。
- 语义对齐:利用离散语义分词器,比传统模型更懂画面背后的深层含义。
3. 指令驱动式图像编辑 (Image Editing)
- 灵活编辑:支持单参考或多参考图的指令修改,如替换元素、调整风格、局部重绘。
- 多图合成:在多参考图合成任务中,其一致性与融合能力大幅领先同类模型。
4. 交错生成与推理 (Interleaved Generation & Reasoning)
- 图文混排:能够边写文字边配图,适用于教程编写、故事创作等场景。
- 逻辑推导:结合图文进行分步逻辑推理,如解答物理题、分析棋局变化,实现真正的“多模态思维”。
技术架构:三大核心引擎
LLaDA2.0-Uni 的成功得益于其创新的架构设计:
| 组件 | 技术原理 | 作用 |
|---|---|---|
| 离散语义分词器 | SigLIP-VQ | 将视觉输入转换为离散语义标记,保留核心信息,增强模型对画面的“理解力”。 |
| 统一 dLLM-MoE 主干 | 160亿参数 MoE | 采用混合专家架构,统一处理文字和图片符号,实现高效的资源调度与能力提升。 |
| 高效扩散解码器 | 8步蒸馏推理 | 将离散标记还原为高清图像,通过蒸馏技术将推理步数压缩至 8 步,速度提升 10 倍以上。 |
性能亮点:快、准、狠
1. Sprint 加速技术
- KV 缓存复用:大幅减少重复计算。
- 自适应解掩码:智能调整生成节奏。
- 效果:开启加速后,整体推理速度提升 1.6 倍;图片生成速度快 11 倍,且画质几乎无损失。
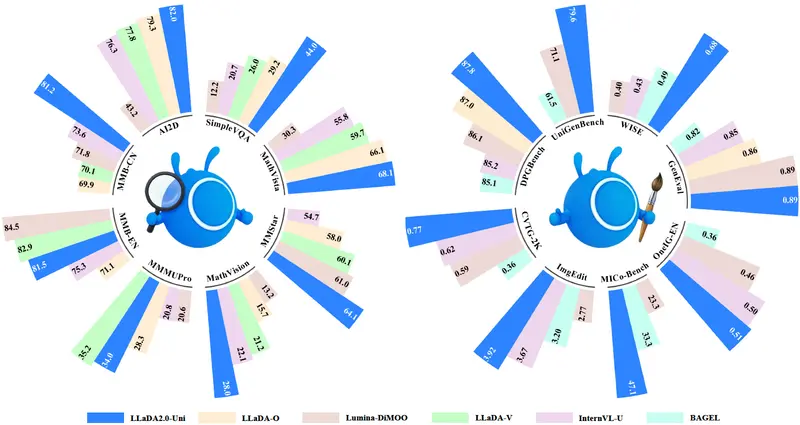
2. 权威 Benchmark 表现
在 20 多项主流测试中,LLaDA2.0-Uni 展现了统治级实力:
- 图文理解:与专业看图模型(如 Qwen-VL, InternVL)水平相当,尤其在图表与数学推理上表现优异。
- 文生图:在统一多模态模型中排名第一,GenEval 等指标领先。
- 图像编辑:指令遵循度与多图一致性大幅超越现有开源方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。