SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    语音模型

    共 209 篇文章
    包括文本生成音频、音乐生成模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
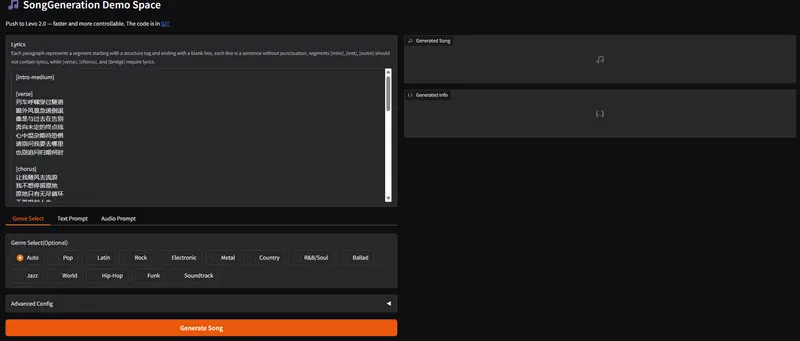
    腾讯开源SongGeneration 2:歌词准确率超越 Suno v5,首个真正达到“商业级”的开源音乐大模型

    腾讯开源SongGeneration 2:歌词准确率超越 Suno v5,首个真正达到“商业级”的开源音乐大模型

    腾讯 AI 实验室重磅发布 LeVo 2 (SongGeneration 2) —— 一个旨在打破开源 AI 音乐天花板的基础模型。经过大规模、严格的专家盲测评估,LeVo 2 在音乐性、歌词准确性和...
    语音模型# SongGeneration 2# 腾讯
    8个月前
    3770
    阿里通义发布 Fun-CosyVoice3.5 与 Fun-AudioGen-VD:自然语言指令即可实现“FreeStyle”语音与场景生成

    阿里通义发布 Fun-CosyVoice3.5 与 Fun-AudioGen-VD:自然语言指令即可实现“FreeStyle”语音与场景生成

    阿里通义实验室语音团队今日正式宣布,推出两款支持 FreeStyle 指令生成 的突破性模型:Fun-CosyVoice3.5 与 Fun-AudioGen-VD。 官方文档:https://help...
    语音模型# Fun-AudioGen-VD# Fun-CosyVoice3.5# 阿里通义
    8个月前
    3560
    MioCodec v2 发布:仅需 341 bps 即可重建 44.1kHz 高保真音频,TTS 模型无缝升级神器

    MioCodec v2 发布:仅需 341 bps 即可重建 44.1kHz 高保真音频,TTS 模型无缝升级神器

    在口语语言建模(Speech Language Modeling)领域,我们长期面临着一个两难选择:是要高压缩率以降低计算成本,还是要高保真度以确保音质清晰?传统的神经音频编解码器往往难以兼得,且常常...
    语音模型# MioCodec
    8个月前
    2260
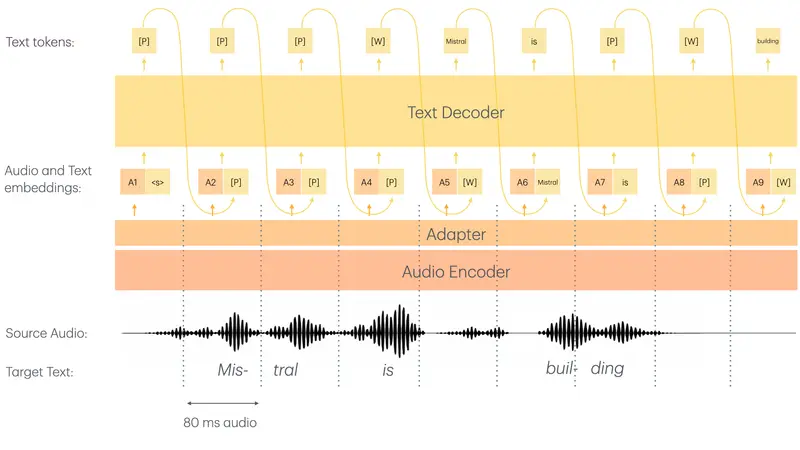
    Mistral AI 发布 Voxtral Mini 4B Realtime 2602:40 亿参数开源实时语音模型,延迟低至 500ms 且支持中文

    Mistral AI 发布 Voxtral Mini 4B Realtime 2602:40 亿参数开源实时语音模型,延迟低至 500ms 且支持中文

    在实时语音处理领域,准确性与低延迟往往难以兼得。传统的开源模型(如 Whisper)虽然精度高,但通常需要收集完整音频片段后才能开始转写,导致显著的延迟,无法满足实时字幕或即时语音助手的需求。 模型...
    语音模型# Mistral AI# Voxtral Mini 4B Realtime 2602
    8个月前
    2150
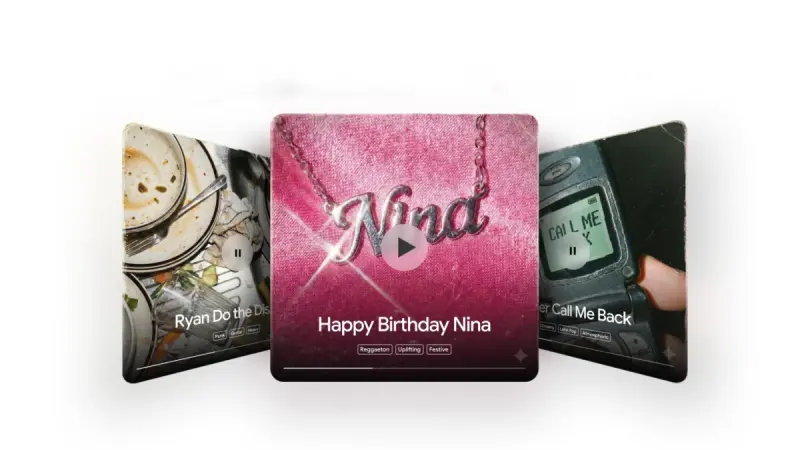
    谷歌发布全新音乐模型 Lyria 3:已集成到Gemini,输入文字或图片,30 秒生成原创音乐

    谷歌发布全新音乐模型 Lyria 3:已集成到Gemini,输入文字或图片,30 秒生成原创音乐

    谷歌周三正式宣布,其旗舰 AI 助手 Gemini 迎来重大功能升级——集成音乐生成能力。这一新功能由谷歌旗下 DeepMind 团队最新研发的 Lyria 3 模型驱动,目前正处于测试阶段,面向全球...
    早报语音模型# Lyria 3# 谷歌# 音乐模型
    8个月前
    2290
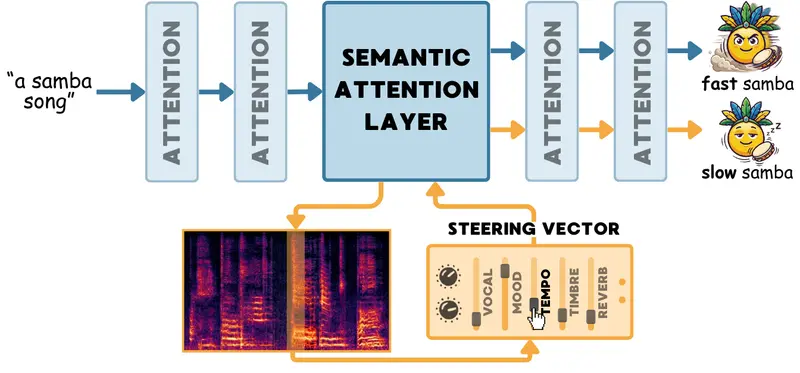
    TADA:给AI音乐生成装上”调音台”,让创作精准可控

    TADA:给AI音乐生成装上”调音台”,让创作精准可控

    想象一下,你对AI说"生成一首桑巴舞曲",它确实生成了一段不错的音乐。但你现在觉得节奏稍微快了点,或者想把女声换成男声,又或者想加点钢琴伴奏——用传统的文字提示,你只能说"一首快节奏的男性演唱桑巴舞曲...
    语音模型# TADA# 音频扩散模型
    8个月前
    1720
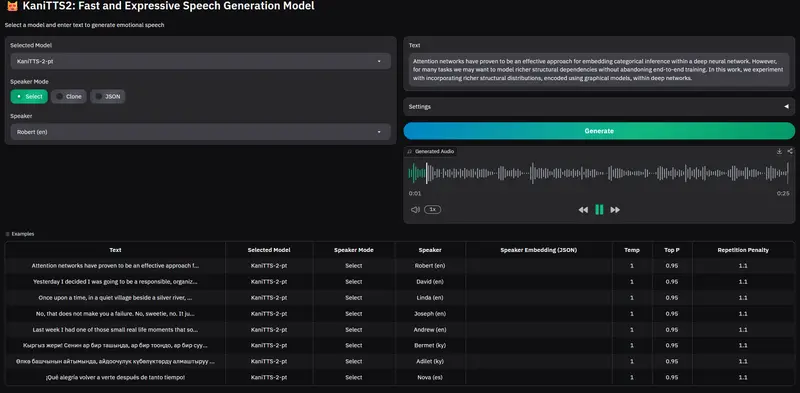
    NineNineSix 开源 KaniTTS2:4 亿参数实时对话 TTS 模型,支持语音克隆与多语言

    NineNineSix 开源 KaniTTS2:4 亿参数实时对话 TTS 模型,支持语音克隆与多语言

    AI 初创公司 NineNineSix 正式开源其新一代文本转语音(TTS)模型 KaniTTS2。该模型专为低延迟、高自然度的实时对话场景设计,支持语音克隆、多语言输出,并提供完整的从零预训练代码框...
    语音模型# KaniTTS2# TTS 模型
    8个月前
    2570
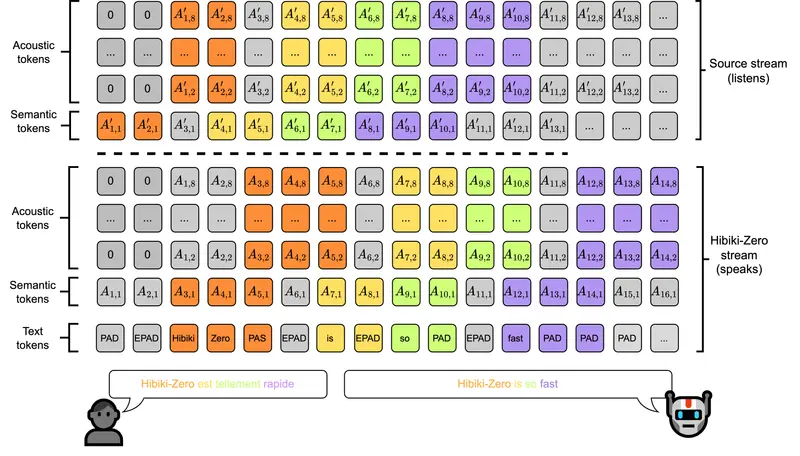
    Kyutai 开源 Hibiki-Zero:3B 参数实时语音翻译模型,无需词级对齐,支持音色迁移

    Kyutai 开源 Hibiki-Zero:3B 参数实时语音翻译模型,无需词级对齐,支持音色迁移

    实时语音翻译的核心挑战在于如何在翻译质量与系统延迟之间取得最佳平衡。传统方法通常需要大量精细标注的词级对齐数据来指导模型何时开始翻译,这不仅成本高昂,也极大地限制了模型向新语言的扩展能力。 为彻底解决...
    语音模型# Hibiki-Zero# 实时语音翻译模型
    9个月前
    2250
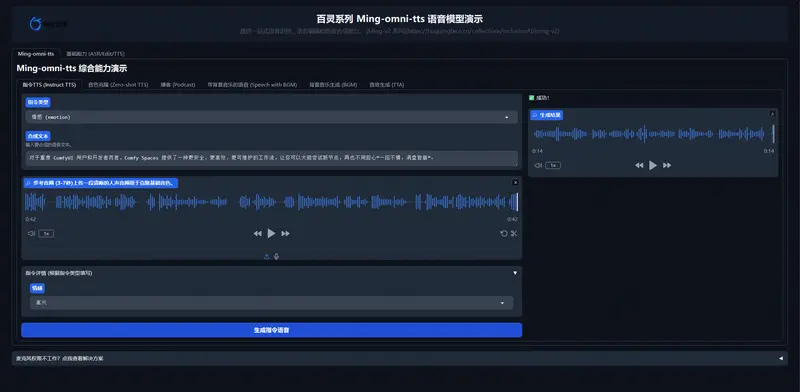
    蚂蚁集团 inclusionAI 团队发布统一生成模型Ming-omni-tts:统一语音、音乐与声音生成,实现高精度细粒度可控音频合成

    蚂蚁集团 inclusionAI 团队发布统一生成模型Ming-omni-tts:统一语音、音乐与声音生成,实现高精度细粒度可控音频合成

    蚂蚁集团 inclusionAI 团队近期正式发布了 Ming-omni-tts,这是一款设计简洁、运行高效的统一音频生成模型。它不仅可以在单一框架内合成高质量的语音,还能同时生成音乐与各类环境声音...
    语音模型# Ming-omni-tts# 统一生成模型
    9个月前
    3860
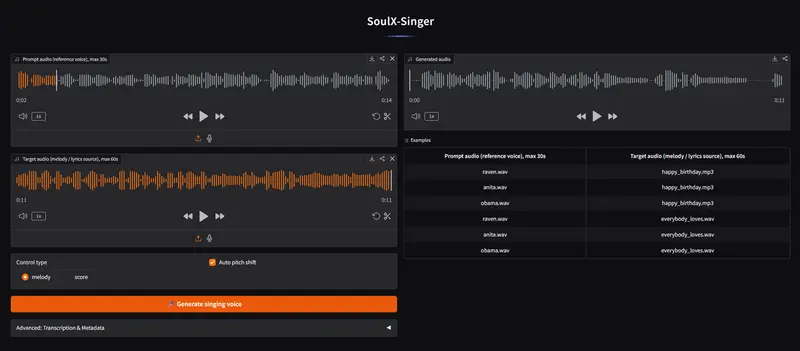
    SoulX-Singer:42,000 小时训练的零样本歌声合成模型,支持 MIDI 与旋律双模式控制

    SoulX-Singer:42,000 小时训练的零样本歌声合成模型,支持 MIDI 与旋律双模式控制

    Soul AI Lab(中国)联合吉利汽车研究院、天津大学及西北工业大学,共同发布了一款高保真、零样本歌声合成模型——SoulX-Singer。这款模型的核心优势的是,无需对未见歌手进行任何微调,就能...
    语音模型# SoulX-Singer# 歌声合成模型
    9个月前
    3370
    Linacodec:12.5 令牌/秒的高压缩音频分词器,支持 48kHz 高清语音

    Linacodec:12.5 令牌/秒的高压缩音频分词器,支持 48kHz 高清语音

    在 AI 语音模型(TTS/ASR)领域,音频分词器(Audio Tokenizer)的效率直接决定训练速度、推理延迟与生成质量。传统方案如 EnCodec、DAC 虽能压缩音频,但令牌率高、采样率低...
    语音模型# Linacodec# 音频分词器
    9个月前
    1560
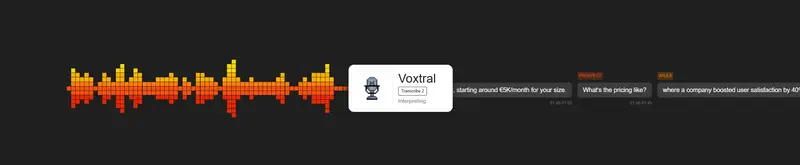
    Mistral AI 发布 Voxtral Transcribe 2:开源实时模型 + 高性价比批量转录,全面支持多语言语音应用

    Mistral AI 发布 Voxtral Transcribe 2:开源实时模型 + 高性价比批量转录,全面支持多语言语音应用

    Mistral AI 推出全新 Voxtral Transcribe 2 系列语音转文本(ASR)模型,包含面向批量离线处理的 Voxtral Mini Transcribe V2 和专为低延迟实时场...
    语音模型# Mistral AI# Voxtral Mini Transcribe V2# Voxtral Realtime
    9个月前
    2400
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    WorkflowAI

    WorkflowAI

    WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
    BlitzBrowser

    BlitzBrowser

    BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
    海绵音乐

    海绵音乐

    海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
    Apple Wallpapers

    Apple Wallpapers

    AppleWalls 提供 iPhone、iPad 与 Mac 系统原生高清壁纸下载,收录 iOS 与 macOS 各版本官方壁纸。探索苹果设计美学,体验纯粹的 Apple 风格。
    SentrySearch

    SentrySearch

    SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      WorkflowAI

      WorkflowAI

      WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
      BlitzBrowser

      BlitzBrowser

      BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
      海绵音乐

      海绵音乐

      海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
      Apple Wallpapers

      Apple Wallpapers

      AppleWalls 提供 iPhone、iPad 与 Mac 系统原生高清壁纸下载,收录 iOS 与 macOS 各版本官方壁纸。探索苹果设计美学,体验纯粹的 Apple 风格。
      SentrySearch

      SentrySearch

      SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
      查看完整榜单