索尼AI 正式开源了 Woosh,一款专为高质量音效生成打造的基础大模型。与市面上许多“黑盒”或低采样率的 AI 音频工具不同,Woosh 不仅完全公开了代码和权重,更在音质、速度和多模态能力上实现了突破,旨在填补开源社区在专业级音效生成领域的空白。
- 项目主页:https://sonyresearch.github.io/Woosh
- GitHub:https://github.com/SonyResearch/Woosh
无论是影视后期、游戏开发,还是日常创意创作,Woosh 都能让普通人通过简单的文字或视频,轻松生成广播级的高保真音效。
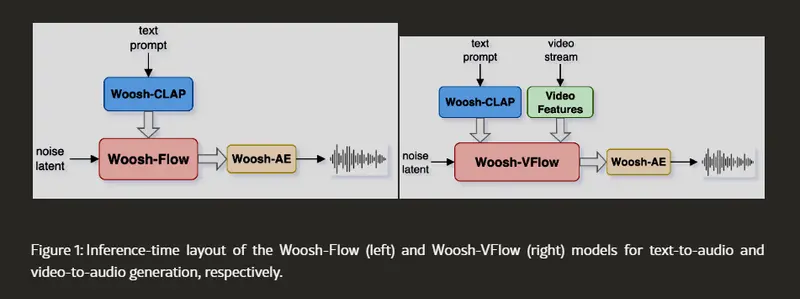
核心亮点
1. 48kHz 专业级音质
- 高采样率:支持 48kHz 采样率,远超普通模型的 16kHz 或 24kHz,确保高频细节清晰、无失真。
- 工作室级训练:基于大量正版、高质量的专业音效库训练,生成的声音干净、真实,直接满足影视和游戏制作标准。
- 超低失真:在音频重建测试中,失真度显著低于 Stable Audio Open 和 TangoFlux 等竞品,清晰度提升超 80%。
2. 极速推理:精简版模型
- 秒级生成:提供蒸馏版(Distilled)模型,仅需 4 步即可生成音效,速度比原版提升 20-50 倍。
- 硬件友好:精简版对显存要求极低,普通消费级显卡甚至 CPU 也能流畅运行,降低了使用门槛。
- 画质无损:速度大幅提升的同时,音质仅有微小下降,日常使用几乎感知不到差异。
3. 多模态生成能力
- 文本转音效 (T2A):输入“敲玻璃”、“风吹树叶”等描述,精准生成对应声音。
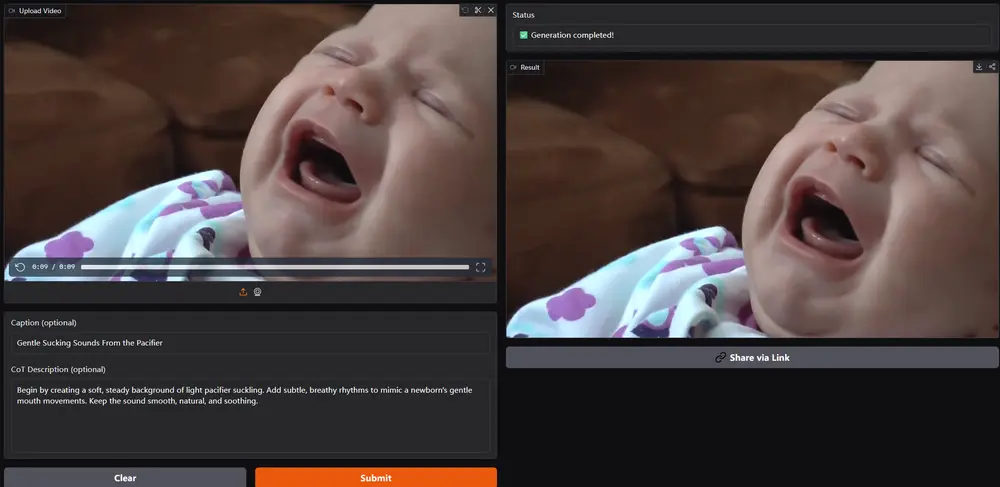
- 视频转音效 (V2A):上传视频片段,AI 自动分析画面动作与场景,同步生成贴合的背景音和动作音效,无需手动对齐。
- 精准语义理解:内置 Woosh-CLAP 模型,能深刻理解文本与音频的对应关系,避免“文不对题”。
4. 完全开源与模块化
- 透明开放:所有模块(编码器、对齐模型、生成模型)的代码和权重均公开,支持非商业用途免费使用及二次开发。
- 灵活架构:开发者可单独使用高质量的音频编解码器(Woosh-AE),或结合文本/视频条件进行定制开发。
技术架构:分工明确的“声音工厂”
Woosh 由四个核心模块协同工作,确保从理解到生成的高效与精准:
| 模块名称 | 功能描述 | 作用 |
|---|---|---|
| Woosh-AE | 音频编码器/解码器 | 将原始音频压缩为潜在表示(Latent),保留关键细节;生成后将潜在表示还原为高保真音频。 |
| Woosh-CLAP | 文本-音频对齐模型 | 理解文本提示,将其转换为 AI 可识别的条件 Token,确保生成的声音与描述高度一致。 |
| Woosh-Flow / DFlow | T2A 生成模型 | 基于潜在扩散模型(Latent Diffusion),根据文本条件生成音频。DFlow 为蒸馏加速版。 |
| Woosh-VFlow | V2A 生成模型 | 多模态扩散模型,结合视频帧信息和可选文本提示,生成与画面同步的音效。 |
性能对比:全面领先开源竞品
在与主流开源模型(如 Stable Audio Open, TangoFlux)的对比中,Woosh 展现出显著优势:
- 音质重建:在公共和私有数据集上,Woosh 的音频重建失真度最低,听感最自然。
- 文本匹配度:在复杂描述和专业术语测试中,Woosh 生成的音效与文本意图匹配更准确。
- 视频同步性:Woosh-VFlow 生成的音效与视频动作的时间戳对齐更精准,且参数更少,效率更高。
- 速度 vs 质量:精简版(DFlow)在速度提升 20 倍以上的同时,保持了接近原版的音质水平。
快速开始
Woosh 已发布在 Hugging Face 上,支持 Python 推理。
推荐配置:
- 原版模型:建议 NVIDIA GPU (24GB+ VRAM) 以获得最佳音质。
- 精简版 (DFlow):可在较低显存显卡甚至 CPU 上运行,适合快速迭代。
© 版权声明
文章版权归作者所有,未经允许请勿转载。