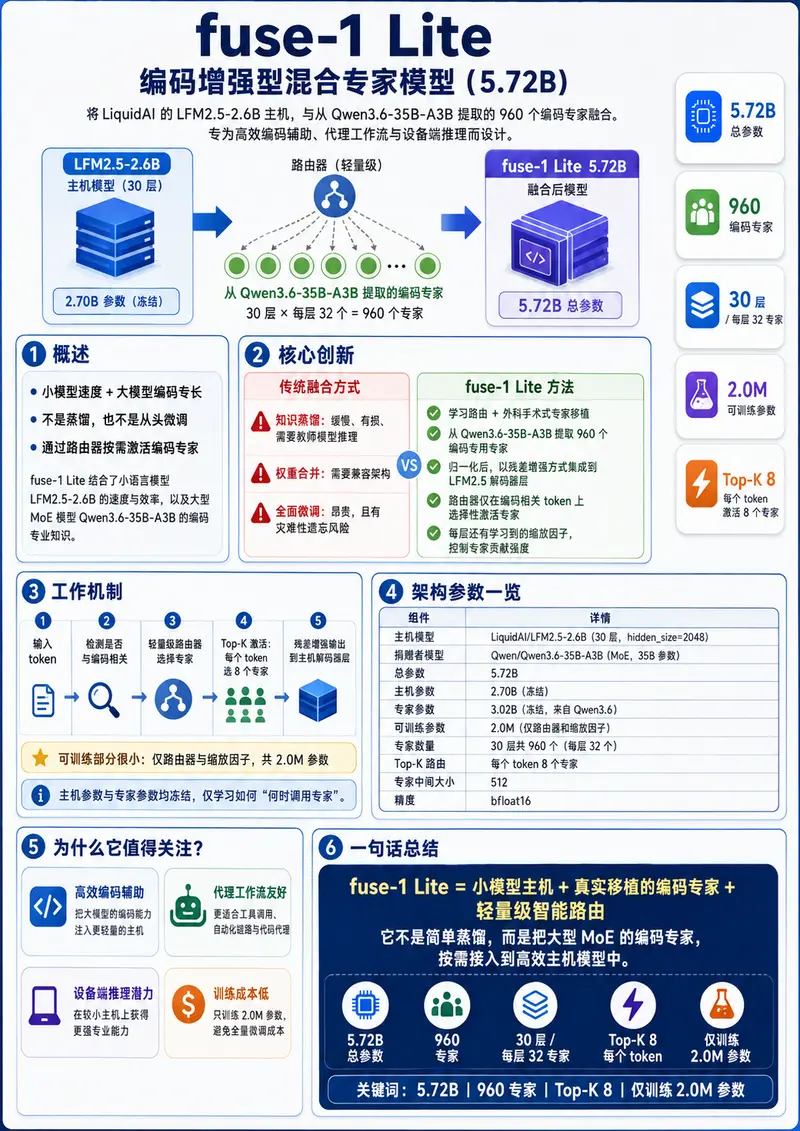
个人开发者推出fuse-1 Lite,融合LFM2.5主机与960个编码专家支持设备端推理个人开发者Vasko Djack发布的fuse-1 Lite是一款5.72B参数的混合专家模型,通过将Qwen3.6-35B-A3B中的960个编码专家“外科手术式”移植到LiquidAI LFM2...大语言模型# fuse-1 Lite3个月前940
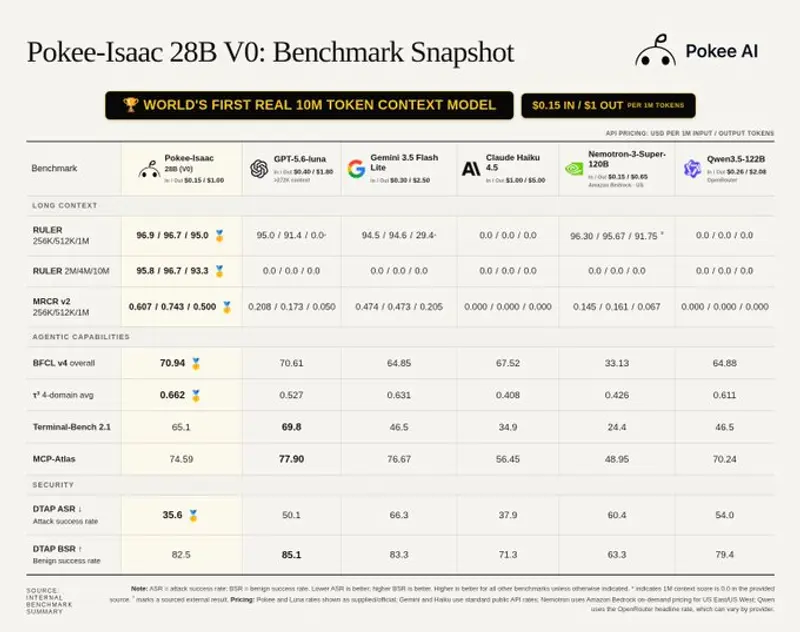
Pokee AI推出Pokee-Isaac 28B:可以本地跑千万字长文本,数据不出内网在云端大模型主导的今天,企业和个人用户面临着两难选择:要么将敏感数据上传至第三方服务器,承担泄露风险;要么忍受高昂的按量计费,且在处理超长文档时遭遇“失忆”困境。 项目主页:https://conso...大语言模型早报# Pokee AI# Pokee-Isaac 28B3个月前1180
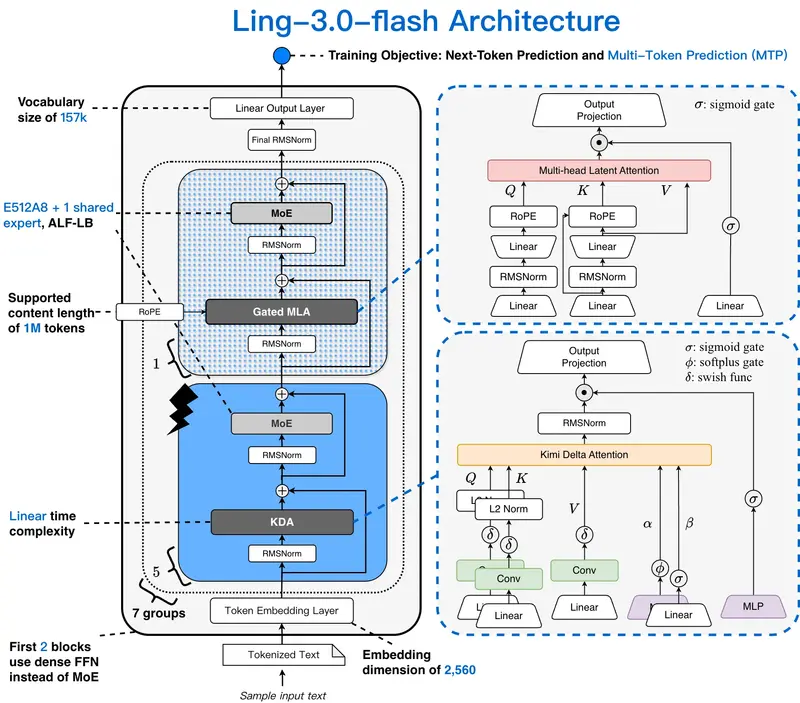
蚂蚁集团 inclusionAI 发布 Ling-3.0-flash:124B 参数仅激活 5.1B,重塑代理工作流效率蚂蚁集团旗下 inclusionAI 今日正式推出下一代原生混合推理模型 Ling-3.0-flash。该模型以 124B 总参数和仅 5.1B 激活参数的极致稀疏化设计,在关键基准测试中持平甚至超越...大语言模型# inclusionAI# Ling-3.0-flash# 蚂蚁集团3个月前900
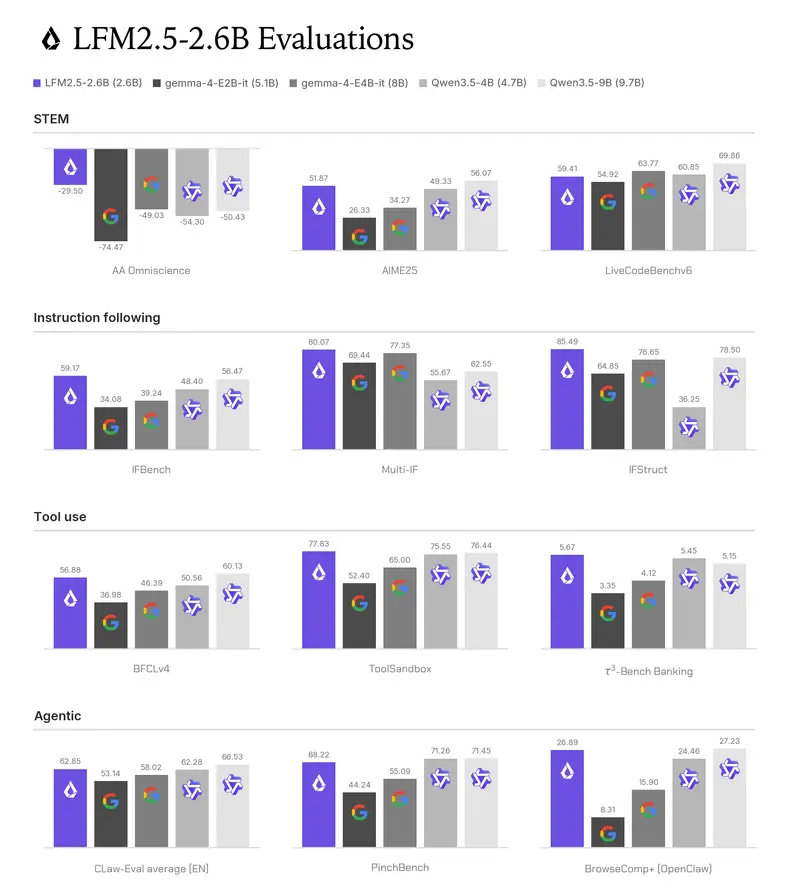
LFM2.5-2.6B:Liquid AI 发布端侧智能体模型,手机也能跑 Agent在 AI 智能体(Agent)日益普及的今天,云端 API 的成本、延迟和隐私顾虑始终是悬在开发者头上的达摩克利斯之剑。Liquid AI 今日发布的 LFM2.5-2.6B 试图彻底改变这一现状。这...大语言模型# LFM2.5-2.6B# Liquid AI3个月前1030
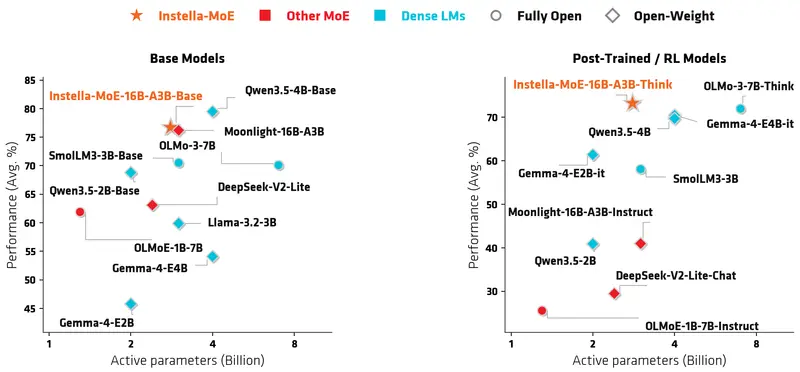
AMD 开源 Instella-MoE:在 Instinct GPU 上从头训练的 16B 混合专家模型在大模型领域,英伟达 的 CUDA 生态长期占据主导地位。但 AMD 正在通过开源全栈方案打破这一局面。近日,AMD 正式发布了 Instella-MoE-16B-A3B,这是一款完全在 AMD In...大语言模型# AMD# Instella-MoE3个月前1050
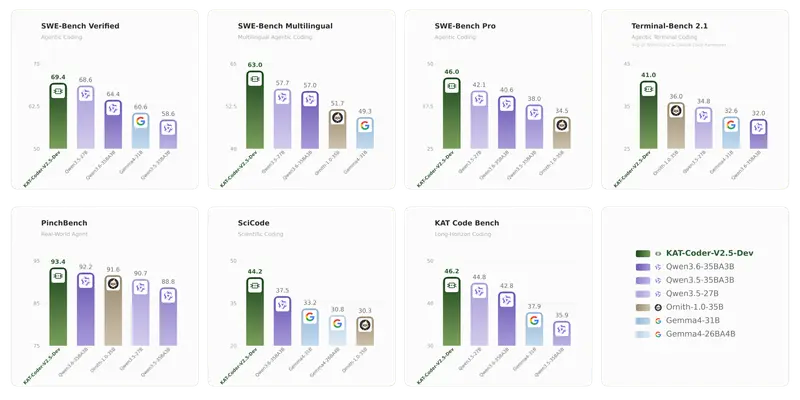
快手开源 KAT-Coder-V2.5:在 10 万个真实仓库中训练的 AI 编程智能体AI 写代码的能力正在从“生成片段”向“解决完整工程问题”进化。快手 KwaiKAT 团队最新发布的 KAT-Coder-V2.5,正是这一趋势的代表作。 模型:https://huggingface...大语言模型# KAT-Coder-V2.5# 快手3个月前1240
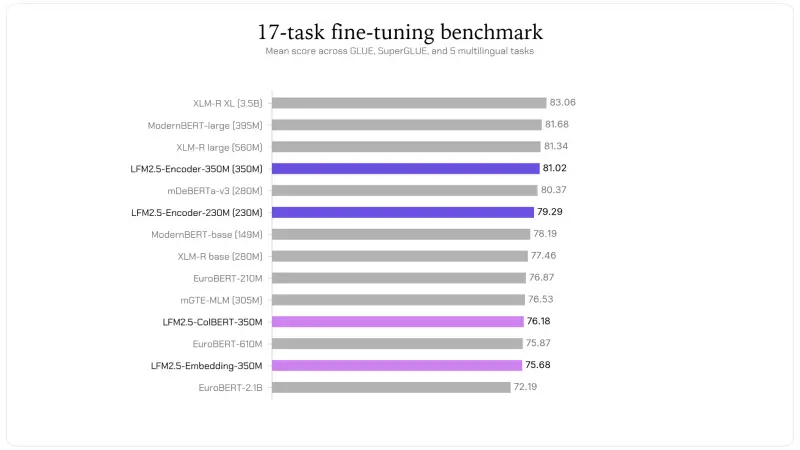
Liquid AI 开源 LFM2.5 编码器:CPU 上也能极速处理 8K 长文本大语言模型(LLM)通常被视为 GPU 的专属领地,但在分类、意图识别、安全过滤等日常任务中,我们更需要的是轻量、快速且能处理长文本的“编码器”。 Liquid AI 最新发布的 LFM2.5-Enc...大语言模型# LFM2.5-Encoder-230M# LFM2.5-Encoder-350M# Liquid AI3个月前1100
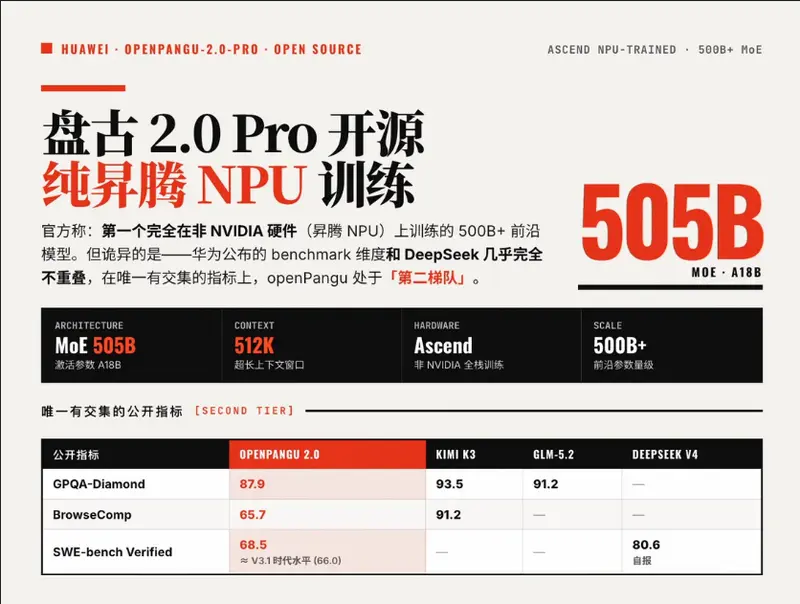
华为开源 5050 亿参数盘古大模型openPangu-2.0-Pro7 月 31 日,华为正式官宣开源 openPangu-2.0-Pro。这是一款拥有约 5050 亿总参数的大规模混合专家(MoE)语言模型。此次开源不仅包含了模型权重和基础推理代码,还同步发布了详细...大语言模型# openPangu-2.0-Pro# 华为3个月前1290
PolyAI 发布 Dialog-RSN-1:直接“听”懂音频的原生对话模型在语音交互领域,传统的做法通常是“先转文字,再理解意思”。这种级联模式虽然成熟,但往往会丢失语调、犹豫和停顿等关键情感线索。 PolyAI 最新推出的 Dialog-RSN-1 打破了这一惯例。这是一...大语言模型早报# Dialog-RSN-1# PolyAI3个月前1220
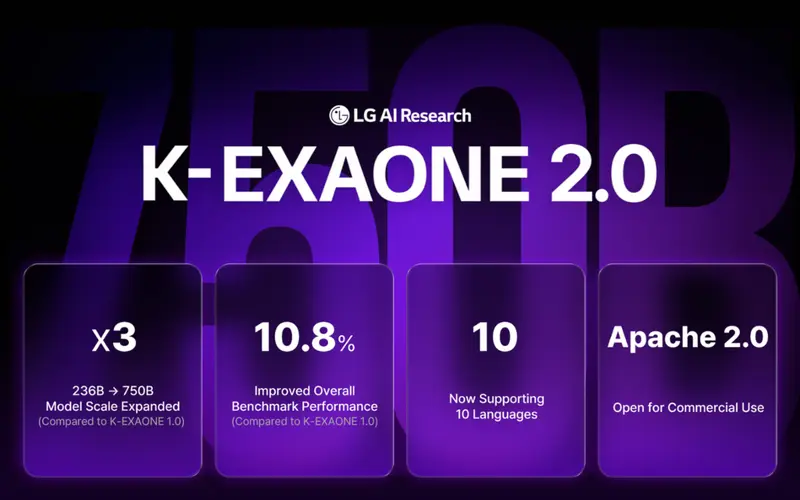
LG 开源韩国最大 AI 模型 K-EXAONE 2.0:7500 亿参数,Apache 2.0 许可LG AI 研究院今天在 Hugging Face 上正式发布了 K-EXAONE 2.0。 作为韩国科技信息通信部主权人工智能基金会项目下的第二款模型,K-EXAONE 2.0 以 7500 亿总参...大语言模型早报# K-EXAONE 2.0# LG3个月前1120
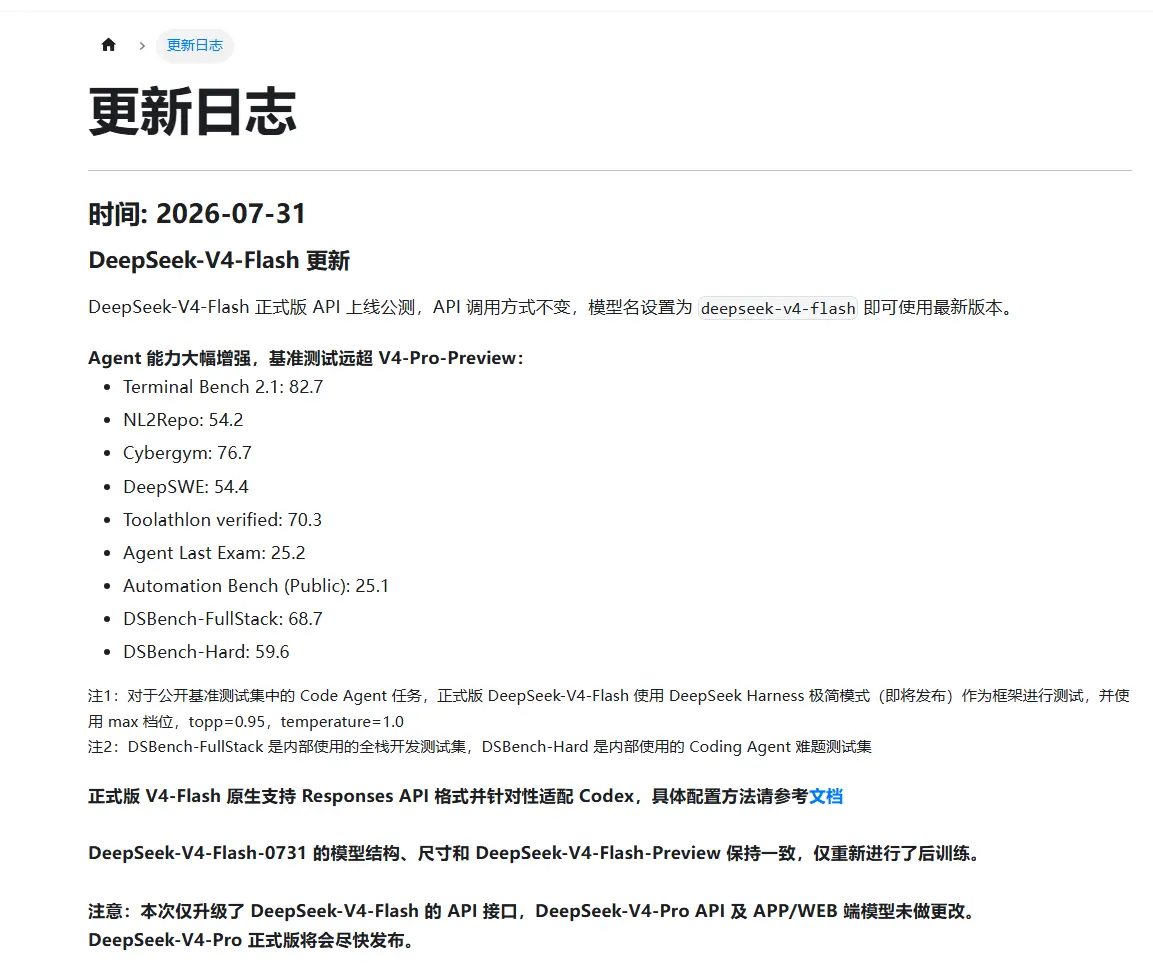
DeepSeek-V4-Flash 正式版上线:Agent 能力大幅增强,Hugging Face 同步开源7月31 日下午,DeepSeek 通过 API 文档发布日志宣布,DeepSeek-V4-Flash 正式版 API 开启公测。与此同时,该模型的权重也已在 Hugging Face 上正式开源。 ...大语言模型早报# DeepSeek-V4-Flash3个月前1190
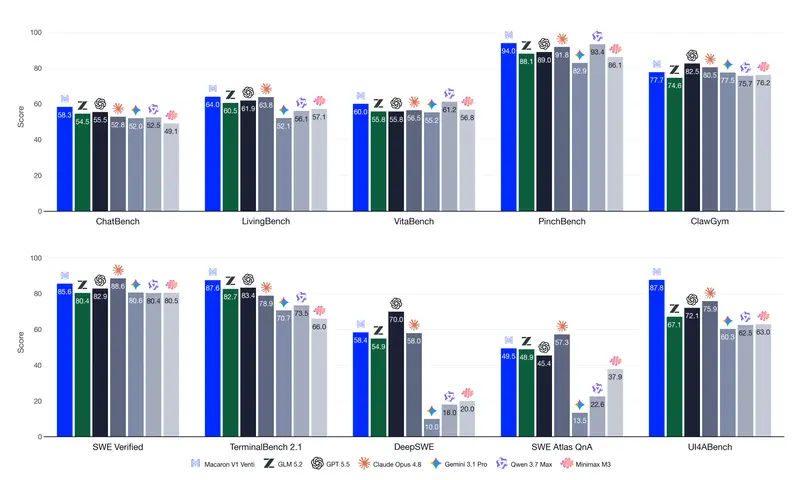
Mind Lab 发布 Macaron-V1:全球首个基于 GLM-5.2 后训练的 MoE 智能体模型,支持 200 万 Token 上下文Mind Lab 今天正式发布了 Macaron-V1,这是继预览版之后,其智能体模型家族的首次完整亮相。 这次发布不仅带来了两个新模型,更展示了一套完整的“适应与协作”技术栈。Macaron-V1 ...大语言模型# Macaron-V1-Tall# Macaron-V1-Venti# Mind Lab3个月前1180