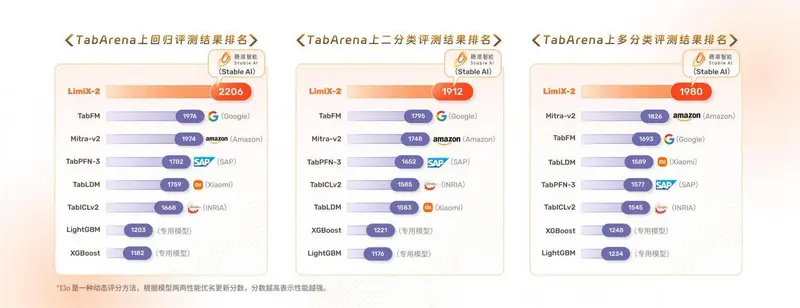
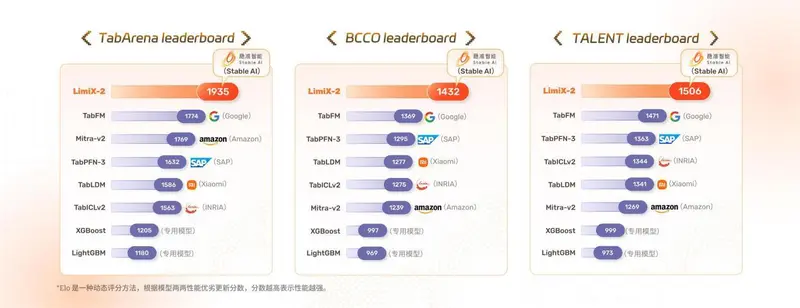
9 月 16 日,稳准智能联合清华大学计算机系崔鹏教授团队正式发布新一代数据大模型 LimiX-2。该模型将参数规模提升至 400M,并在 TabArena、BCCO、TALENT 三个国际主流结构化数据 Benchmark 中取得总体 Elo 分数第一的优异成绩,超越了 Google、SAP、Amazon 等国际科技巨头的同类模型。
- Github:https://github.com/limix-ldm-ai/LimiX
- Huggingface:https://huggingface.co/stable-ai/LimiX-2
- model scope: https://modelscope.cn/models/stable-ai/LimiX-2
核心战绩:全面领跑国际榜单
LimiX-2 在三大权威基准测试中均刷新了最高纪录,展现了极强的泛化能力和预测性能:
| 基准测试 | LimiX-2 Elo 分数 | 排名 | 超越对象 |
|---|---|---|---|
| TabArena | 1935 | 第 1 | Google, SAP, Amazon 等大厂模型 |
| BCCO | 1432 | 第 1 | 国际主流结构化数据模型 |
| TALENT | 1506 | 第 1 | 国际主流结构化数据模型 |
注:Elo 分数是衡量模型综合能力的排名指标,分数越高代表模型在多样化数据集上的表现越稳健。
三大技术突破:从“预测”走向“结构发现”
LimiX-2 的能力升级主要依托于以下三条核心技术路线:
1. 上下文机制网络 (CMNs):建模范式的转变
- 传统局限:经典 PFNs(如 TabPFN)主要以指定目标的预测分布为核心。
- LimiX 创新:提出 Contextual Mechanism Networks (CMNs),将建模重点从“目标预测”转向“变量间的相互关联”。
- 全变量联合依赖:不仅关注变量取值,更着眼于发现变量如何共同构成内在结构。
- 单元格级建模 (Cell-Level):以变量在各样本中的观测为基本单元,保留列身份、具体取值和缺失状态,支持跨变量、跨样本的深度交互。
- 统一任务框架:分类、回归、缺失值填补等任务被统一为对同一数据模型的不同查询。
2. 自动化合成数据生成引擎升级
- 针对结构化数据难以像文本那样大规模公开获取的痛点,LimiX-2 升级了预训练阶段的合成数据生成引擎。
- 能够自动生成包含线性、非线性、多变量交互、周期变化和噪声扰动等多种分布的数据,让模型在接触真实企业数据前,就已充分学习各种复杂的数据结构和变量关系。
3. Scaling Law 验证:参数规模扩至 400M
- 继去年提出“结构化数据基础模型遵循 Scaling Law”后,LimiX-2 再次验证了这一规律。
- 参数规模的扩大显著增强了模型的泛化能力,使其在因果关系规律的挖掘和稳定表达上更具优势。
额外亮点:因果发现的突破性进展
除了传统的预测任务,LimiX-2 在因果发现 (Causal Discovery) 领域也取得了显著突破:
- 挑战传统:传统方法依赖专家先验或严格统计假设,难以应对高维企业数据。
- LimiX 优势:基于联合关系建模提供的统计基础,LimiX-2 在 Sachs, UF, Causal Chamber 等多个公开标准数据集上,显著领先传统因果发现方法。
- 意义:这标志着 AI 正从单纯的“预测”向更深层次的“决策”和“机制归纳”迈进。
产业落地与未来展望
- 广泛验证:截至 2026 年世界人工智能大会,上一代 LimiX 已完成 800 余个跨行业、跨场景的公开数据集验证。
- 真实落地:已在 60 余个真实场景中落地应用,涵盖工艺参数优化、设备故障预测、电力预测、能耗优化和材料科学等领域。
- 中国模式:稳准智能正在探索依托产业场景驱动模型迭代的中国模式,与国际巨头形成差异化竞争。
稳准智能首席科学家崔鹏表示:“LimiX-2 的发布是团队在结构化数据大模型方向持续探索的重要阶段性成果。我们将长期坚持这一技术路线,不断提升模型对数据规律和变量因果关系的理解能力,助力人工智能更快速地从预测走向决策。”
© 版权声明
文章版权归作者所有,未经允许请勿转载。