9 月 17 日,中国电信人工智能科技有限公司正式发布新一代星辰语义大模型 Xing4.0-29B-A4B。该模型总参数量 29B,激活参数仅 4B,原生支持 256K 上下文(可扩展至 512K),是国内首个基于国产算力与国产框架完成全流程训练、并面向复杂工程任务深度优化的百亿参数级大模型。
- HuggingFace:https://huggingface.co/XingChen-AGI/Xing4.0-29B-A4B
- GitHub:https://github.com/XingChen-AGI/Xing4.0-29B-A4B
- 魔搭:https://modelscope.cn/models/XingChen-AGI/Xing4.0-29B-A4B
- Gitee:https://gitee.com/xingchen-agi/xing4.0-29b-a4b
- 魔乐:https://modelers.cn/models/XingChen-AGI/Xing4.0-29B-A4B
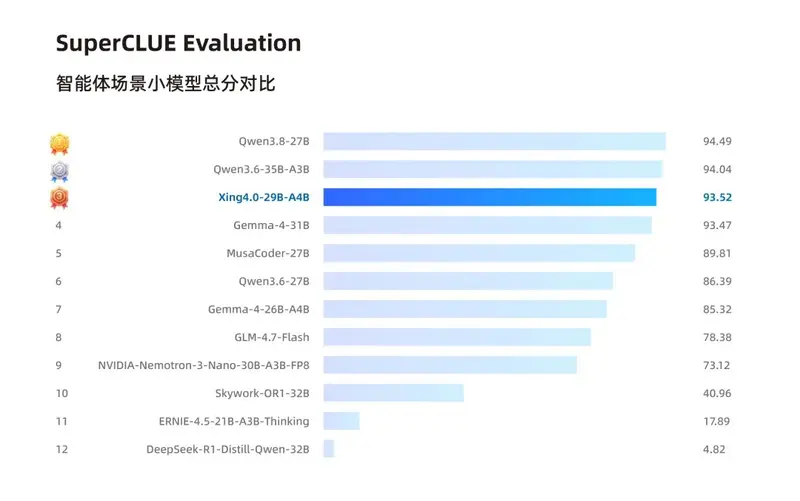
官方强调其“全栈国产”属性:从昇腾 910C 芯片训练、MindSpore/MindFormers 框架适配,到自研 mHC+MLA+MTP 架构及开源生态兼容,实现了从底层硬件到上层应用的完整自主可控路径。在 SuperCLUE 智能体能力评测中,Xing4.0-29B-A4B 得分 93.52,位列第三,与头部 Qwen 模型差距不足 1 分,显示出在 Agent 场景下的强竞争力。
架构设计与工程优化:为长上下文与工具调用而生
Xing4.0-29B-A4B 采用专为 Agent 任务设计的 mHC(multi-head Context)+ MLA(Multi-head Latent Attention)+ MTP(Multi-Token Prediction)复合架构,核心目标是在长上下文中维持多步骤规划、工具调用与推理链路的稳定性。具体技术参数如下:
- 总层数:40
- 隐藏维度:3584
- 稠密 FFN 中间维度:9216
- 专家中间维度:1024
- 路由专家数:64,每 token 激活 4 个,另含 1 个共享专家
- 注意力机制:MLA,降低 KV Cache 占用
- 上下文:原生 256K,支持扩展至 512K
在训练效率方面,通过细粒度 MoE 通信优化、选择性重计算、DVM 图算自动融合及 Ascend C mHC 融合算子等多层次协同,整体训练吞吐较初始开箱性能提升约 96%。这一优化使得在国产算力平台上实现高效稳定训练成为可能,而非仅停留在“能跑通”层面。
低资源部署与生态兼容:消费级显卡可本地运行
针对落地门槛高的行业痛点,Xing4.0-29B-A4B 在量化与生态适配上做了针对性设计:
- 显存友好:4-bit 量化后显存占用降至 15GB,相比 FP16 节省约 75%,RTX 3090/4090 等 24GB 消费级显卡即可本地运行长上下文任务。
- 微调灵活:支持 LLaMA-Factory、MindFormers 等主流微调框架,便于基于私域数据进行意图识别、表格理解、合同审计、知识问答等垂直场景轻量化定制。
- 推理广泛兼容:适配 SGLang、vLLM、KTransformers 等主流推理引擎;针对 OpenCode、Claude Code、OpenClaw、Hermes 等 Agent 框架进行定向格式对齐,可直接接入现有开发工作流。
- 跨平台部署:基于智源 FlagOS 完成多款 AI 芯片适配,支持跨架构一键部署,降低异构算力环境下的迁移成本。
这种“低门槛+高兼容”策略,使模型不仅适用于大型企业,也为中小团队和个人开发者提供了可行的本地化部署选项。
评测表现:Agent 与代码能力突出,数学推理稍弱
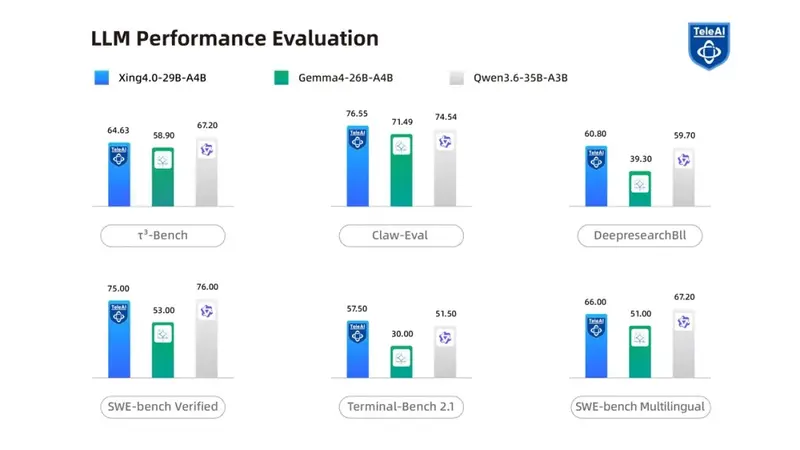
在多项权威基准测试中,Xing4.0-29B-A4B 展现出鲜明的能力特征:
| 评测基准 | Xing4.0-29B-A4B | Gemma4-26B-A4B | Qwen3.6-35B-A3B |
|---|---|---|---|
| IFBench | 69.67 | 72.67 | 65.50 |
| AIME2026 | 90.00 | 88.30 | 92.70 |
| AA.LCR | 61.00 | 66.00 | 62.00 |
| Tau3-Bench | 64.63 | 58.90 | 67.20 |
| Claw-Eval | 76.55 | 71.49 | 74.54 |
| SWE-bench Verified | 75.00 | 53.00 | 76.00 |
| Terminal-Bench 2.1 | 57.50 | 30.00 | 51.50 |
| SWE-bench Multilingual | 66.00 | 51.00 | 67.20 |
| DeepresearchBII | 60.80 | 39.30 | 59.70 |
关键观察点:
- Agent 与代码能力领先:在 SWE-bench Verified(75.00)、Terminal-Bench 2.1(57.50)、Claw-Eval(76.55)等工程实战指标上显著优于 Gemma4,接近或持平 Qwen3.6,验证了其“面向复杂工程任务优化”的定位。
- 长上下文研究能力强:DeepresearchBII 得分 60.80,远超 Gemma4(39.30),略高于 Qwen3.6(59.70),适合需要多轮检索与综合推理的研究型任务。
- 数学推理略有短板:AIME2026 得分 90.00,低于 Qwen3.6(92.70),但高于 Gemma4(88.30),仍属第一梯队末端。
- 指令遵循稍弱:IFBench 69.67,低于 Gemma4(72.67),提示在严格格式输出场景中可能需要额外 prompt 工程。
总体而言,Xing4.0-29B-A4B 是一款高度特化的工程型模型,在 Agent、代码、长文研究等维度具备差异化优势,但在通用指令遵循与纯数学推理上尚有提升空间。
使用建议与注意事项
- 适用场景优先:推荐用于代码生成/修复、多步工具调用、长文档分析、私有知识库问答等任务;若需高精度数学证明或严格 JSON 输出,建议搭配其他模型或增加后处理校验。
- 本地部署验证:虽宣称 15GB 显存可运行,但实际长上下文(>128K)下 KV Cache 仍可能溢出,建议在目标硬件上进行压力测试。
- 国产算力适配:若在昇腾环境部署,务必使用官方提供的 MindFormers 配置与融合算子包,避免自行转换导致精度损失。
- Agent 框架对接:使用 OpenCode/Claude Code 等框架时,请查阅最新适配文档,确认 tool schema 与消息格式已对齐,避免因版本差异导致调用失败。
- 持续关注更新:作为 Preview 阶段产品,后续可能释放更大量化版本、微调脚本或性能补丁,建议订阅官方渠道获取动态。
Xing4.0-29B-A4B其价值不仅在于分数高低,更在于提供了一条从国产芯片到终端应用均可自主掌控的技术路径,为关键行业智能化提供了可信赖的底座选项。
© 版权声明
文章版权归作者所有,未经允许请勿转载。