Linkup Research发布 SPARSEUP,一款基于 ModernBERT 主干的 149M 参数学习型稀疏嵌入模型,采用 Apache 2.0 许可在 Hugging Face 开放权重。该模型在 BEIR-13 基准上取得平均 nDCG@10 为 56.4 的成绩,据团队称是目前已知 150M 参数以下最强的公开词表级稀疏编码器。
- 官方介绍:https://www.linkup.so/blog/introducing-sparseup-by-linkup
- 模型:https://huggingface.co/Linkup-Platform/linkup-sparseup-embed-v1
与主流稠密检索模型不同,SPARSEUP 输出的是词表维度上的权重向量,每个非零项对应一个真实 token,天然适配倒排索引且具备可解释性。这一特性使其在罕见词匹配、关键词精确召回等场景中具有独特优势,尤其适合需要透明检索逻辑或混合检索架构的应用。
技术实现:三项关键改进解决 SPLADE 固有缺陷
SPARSEUP 的训练始于 LightOn 发布的 LateOn-unsupervised 检查点。由于该检查点缺失 MLM 头,团队重新接入 ModernBERT 原始 MLM 头,并仅使用 LightOn 的微调数据与对比学习完成训练(每查询采样 7 个硬负例 + 批内负例),无需交叉编码器蒸馏,单卡 H100 即可完成全流程。
针对传统 SPLADE 模型易产生停用词膨胀、向量过密的问题,SPARSEUP 引入三项工程化修正:
- Logit 平移:对 MLM logits 应用
log(1 + ReLU(x - 15))变换。ModernBERT 原始 logit 值过高导致 log 饱和,使初始化阶段词袋过于稠密;平移操作有效缓解此问题。 - 逐位置 top-k 截断:每个输入 token 在最大池化前仅保留其最强的 12 个词表维度,限制单 token 扩展度而非全局向量大小,从源头控制稀疏性。
- 大小写折叠:将字节级 BPE 中因大小写或前缀差异产生的多个 id(如 heat / Heat / Ġheat / ĠHeat)合并为单一 id,并保留最大权重。输出维度从约 50k 降至约 34k,提升存储与检索效率。
查询与文档分别添加 [Q] 和 [D] 前缀,相关性评分通过点积计算。评估时最大长度设为查询 128 token、文档 512 token。
性能表现:同主干下略逊于稠密与后期交互模型
在 BEIR-13 公开排行榜上,SPARSEUP(56.4)领先 opensearch-neural-sparse-encoding-doc-v3-gte(54.6)、splade-v3(51.7)等同类稀疏模型,但低于 1B 参数的 LACONIC-1B(58.7)。
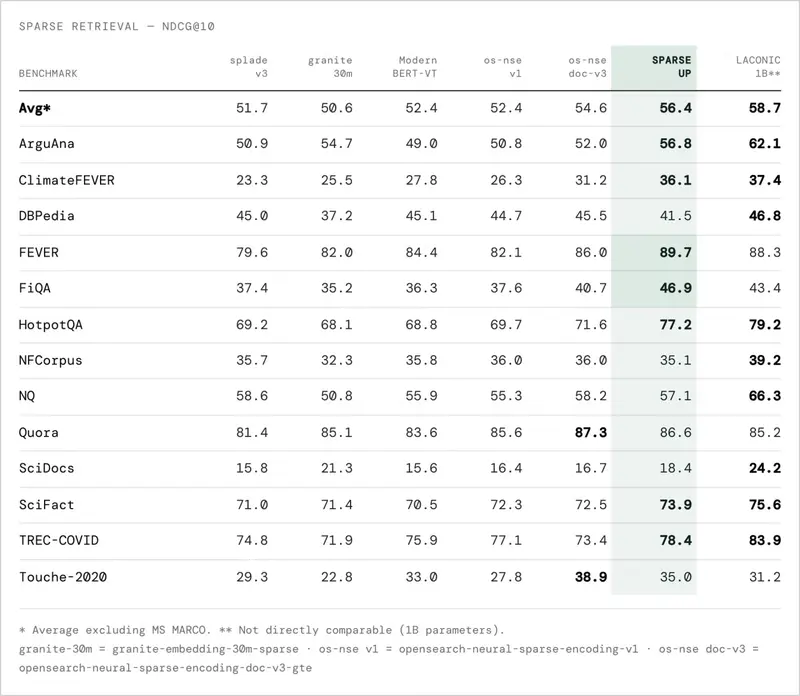
然而,在严格控制主干与训练数据的横向对比中,SPARSEUP 表现弱于同源的 DenseOn(57.9)和 LateOn(58.9)。差距主要出现在语义偏强的数据集(如 FiQA、DBPedia),而在 ArguAna、Touché 等关键词敏感任务上反超 DenseOn,并在 HotpotQA 上胜出。在去污染版 BEIR 上,与 DenseOn 的差距缩小至 0.17 分,但 Linkup 提醒 NQ 和 MS MARCO 子集样本量过小(仅 21/46 条查询),结果噪声较大。
推理效率方面,在 MS MARCO 上 SPARSEUP 平均每查询 47 个非零项、每文档 190 个,略高于 SPLADE-v3(25/170)。使用 Seismic 倒排索引时,单线程下每查询约 380 微秒即可达到 >97% 的精确搜索召回率。团队表示扩大向量尺寸可能带来 1–2 个 BEIR 点提升,但主动选择维持当前稀疏度以平衡速度与效果。
部署方式与适用场景建议
SPARSEUP 可通过 Transformers 或 Sentence Transformers 加载,需设置 trust_remote_code=True。作为 Linkup Research 首个开源模型,其价值不仅在于自身性能,更在于填补了 LightOn 开放生态中的稀疏检索空白——现在用户可在相同主干与数据下,直接比较稠密(DenseOn)、稀疏(SPARSEUP)与后期交互(LateOn)三种范式。
适用场景推荐:
- 混合检索系统:作为稀疏分支补充稠密模型,提升长尾查询与精确匹配能力。
- 可解释性要求高的领域:法律、医疗、合规审查等需追溯检索依据的场景。
- 资源受限环境:149M 参数量支持 CPU 或低端 GPU 部署,适合边缘设备或低成本服务。
- 研究对照实验:与 DenseOn/LateOn 构成完整三件套,便于消融分析与架构选型。
注意事项:
- 在纯语义相似度任务中可能弱于同级稠密模型,不宜单独用于问答或摘要生成。
- Seismic 索引需额外集成,标准 FAISS/Elasticsearch 无法直接利用其稀疏结构加速。
- 大小写折叠可能导致专有名词区分度下降,在品牌/人名敏感场景中需评估影响。
© 版权声明
文章版权归作者所有,未经允许请勿转载。