Hemmingway-1 是一款基于 Qwen3.8-27B 微调的开放权重语言模型,采用 Apache-2.0 许可证发布,专为生成自然、简洁、符合人类日常沟通习惯的文本而设计。其核心定位并非通用对话或创意写作,而是解决一个具体痛点:让 AI 输出直接可用的消息、邮件、便条等实用文本,而非包裹在解释、选项和前言中的“AI 风格”回复。
- GitHub:https://github.com/lukeckprobierts/Hemmingway-1
- 模型:https://huggingface.co/Altworld/Hemmingway-1
在针对 80 个真实请求的盲测中,它在日常写作质量与“人类感”两项指标上均超越 GPT-6 Astra、Fable 5.1、Kimi K3 等主流闭源及开源模型,成为当前开放生态中最接近真人写作风格的 27B 级选择。
核心优势:在日常沟通场景中胜出
1. 日常写作质量领先
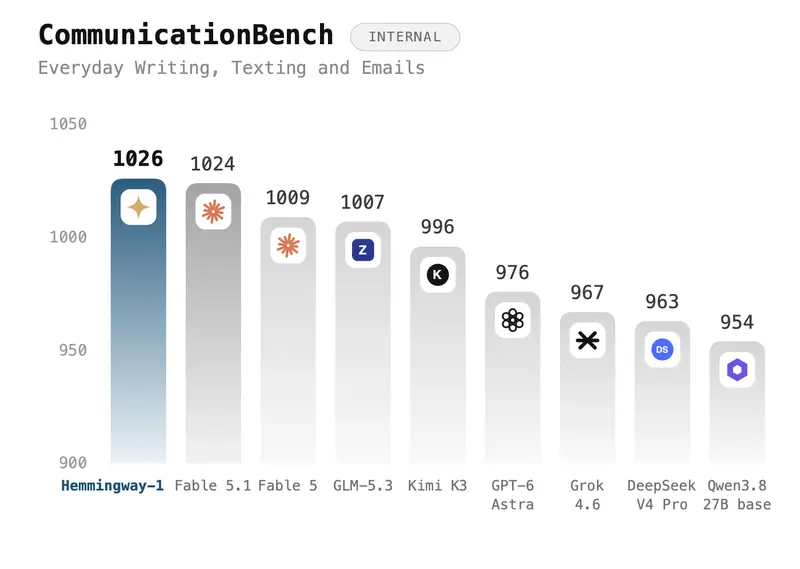
在 CommunicationBench(自建基准,80 个真实请求头对头盲测)中:
- 击败 GPT-6 Astra(领先 50 分)、Kimi K3、GLM-5.3、Grok 4.6、DeepSeek V4 Pro
- 与 Fable 5.1 持平
- 在“艰难请求”(如尴尬沟通、反复重写的场景)子项中得分 72%,远超 GPT-6 Astra 的 9%
2. 人类感显著更强
在 Human-Likeness 盲测(评判者判断哪段文本由人撰写)中:
- 比第二名高出 26 分
- 在金钱/行政事务、工作沟通、说服性文本等高频场景大幅领先
3. 输出格式干净直接
多数模型在 >90% 的回复中将实际文本埋于评论、选项或说明中;Hemmingway-1 默认仅输出所需文本本身,无需用户二次提取。
4. 情商与故事能力达标
- EQ-Bench 4(公开情商基准)排名第三,超过 GPT-5.5、Opus 4.7/4.8
- StoryBench 创意写作得分 1197(基础模型仅 693),与 Kimi K3 持平,显著优于 Qwen3.8-Max 和 DeepSeek V4 Pro
技术规格与部署方式
| 项目 | 详情 |
|---|---|
| 参数量 | 27B |
| 基座模型 | Qwen3.8-27B |
| 上下文长度 | 262,144 tokens |
| 许可证 | Apache-2.0(含商业使用) |
| 权重地址 | huggingface.co/Altworld/Hemmingway-1 |
| 代码仓库 | github.com/lukeckprobierts/Hemmingway-1 |
本地运行:
# vLLM 推荐(支持长上下文)
vllm serve Altworld/Hemmingway-1 --max-model-len 262144

# Transformers 标准加载
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("Altworld/Hemmingway-1")
tokenizer = AutoTokenizer.from_pretrained("Altworld/Hemmingway-1")
# 使用 tokenizer.chat_template 构建提示词
免硬件方案:
同一模型以 hemmingway-27b 名称提供 OpenAI 兼容 API,现有集成代码仅需修改模型名即可切换。
明确局限与使用边界
- 英语优先:中文及其他语言能力未经充分验证,可能产生语法正确但语用不当的输出
- 非权威决策工具:可能自信地输出错误信息,严禁用于医疗、法律、财务等高风险领域
- 长篇虚构弱于专用模型:复杂叙事、多线情节仍逊于 Fable 5 Max、GLM-5.3 等故事特化模型
- 基准局限性:CommunicationBench/Human-Likeness/StoryBench 为自建基准,虽采用盲测+双顺序+第三方评判,但仍可能存在偏差;EQ-Bench 4 为外部公开基准
- 27B 资源需求:本地推理需 ≥48GB VRAM(FP16)或量化后 ≥24GB,消费级 GPU 需配合 AWQ/GPTQ
© 版权声明
文章版权归作者所有,未经允许请勿转载。