SpaceXAI今天推出 Grok 4.7,定位为用于编程和知识工作的旗舰模型。该模型基于比 Grok 4.6 更大的基础架构,通过更长的强化学习周期在复杂任务组合上训练,权重显著偏向需数小时完成的长程问题。核心改进包括更强的自我验证能力、长上下文管理及对 Grok Bot harness 的原生支持。定价为输入 $2/百万 token、输出 $6/百万 token,与 Grok 4.6 持平;另提供速度翻倍、价格翻倍的快速变体。现已上线 Cursor、Grok Build、Grok API 及第三方平台。
技术演进:从规模到耐力的范式转移
Grok 4.7 的训练策略标志着明确的方向调整:
- 更大基础模型:底层容量扩展支撑更复杂的推理链条
- 延长 RL 训练:强化学习运行时间显著增加,奖励信号聚焦于多步骤任务的最终正确性而非中间流畅度
- 困难任务偏重:训练分布向高难度样本倾斜,使模型习惯长时间自主工作而非快速给出近似答案
- 自我验证内化:将“检查自身输出”作为可训练行为,降低长链推理中的累积错误率
- Harness 原生集成:直接理解工具调用协议,减少编排层的语义损耗
这种设计哲学回应了 Agentic 编程的核心瓶颈:多数模型擅长单步补全,但在跨文件重构、多轮调试等需持续数小时的任务中迅速退化。Grok 4.7 试图将“耐力”本身变为可优化的参数。
基准表现:编程与专业工作的双轨验证
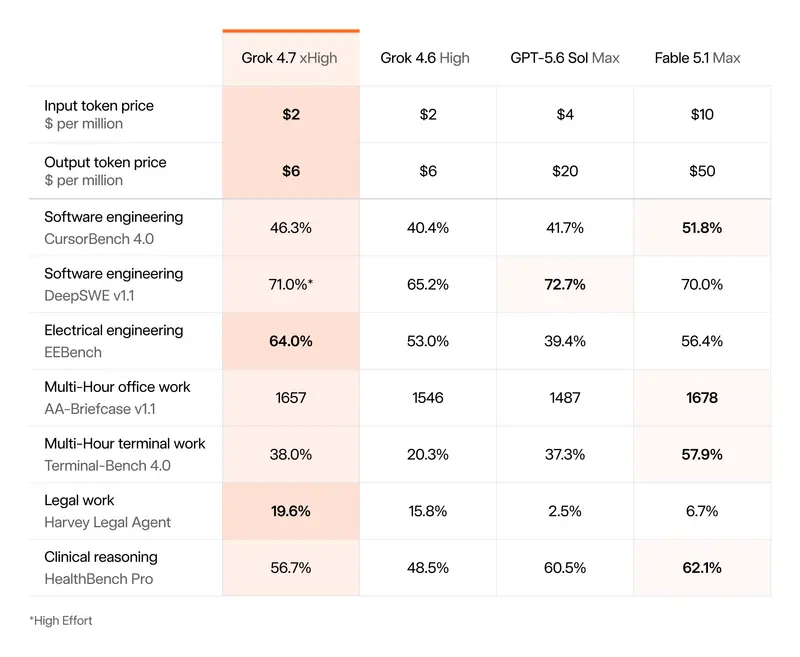
| 基准 | 领域 | 表现 |
|---|---|---|
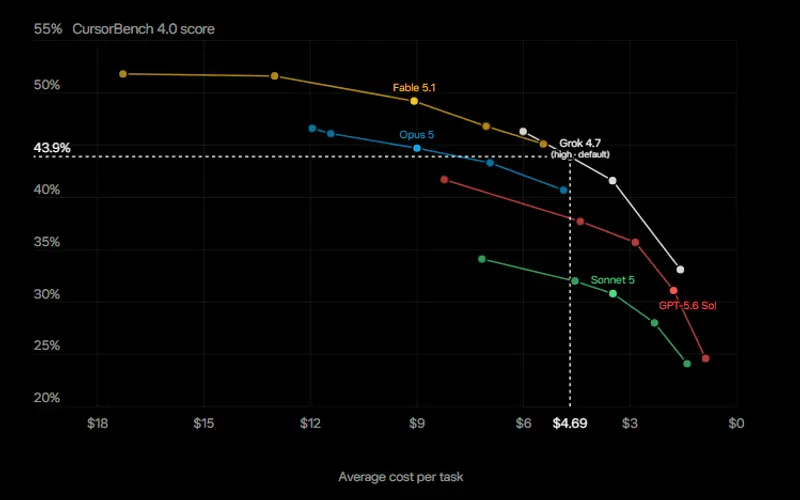
| CursorBench 4.0 | 长程编码任务 | 前沿性价比,强调运行时长而非单次响应 |
| GDPval | 律师/金融分析师等专业工作模拟 | 较 Grok 4.6 提升,与其他前沿模型相当 |
| AA Briefcase | 护士/行政等专业文档生成 | 同上 |
需注意:CursorBench 4.0 侧重“运行时间更长的编程任务”,这意味着评估的是 Agent 在真实 IDE 环境中的端到端成功率,而非孤立代码片段的语法正确性。GDPval 与 AA Briefcase 则验证模型在非编程专业场景的泛化能力——这对“知识工作”定位至关重要。
安全架构:两用领域的精细平衡
Grok 4.7 采用全新保障栈,在拒绝精度上实现关键突破:
- LatchBio 生物安全基准:62.4% 得分居首,证明在生命科学两用场景中能有效区分良性研究与危险请求
- HackerBench v0.3:仅 3.3% 高风险两用提示被放行,同时保持合法安全工作的低误拒率
- 红队能力开放:向精选网络安全合作伙伴提供仅限邀请的防御研究访问
这一设计的价值在于解决了长期困扰行业的“过度拒绝”问题:传统安全机制常因恐惧误放而阻断合法渗透测试或医学研究。Grok 4.7 通过更细粒度的意图识别,在安全性与实用性间取得工程化平衡。
定价与部署选项
| 变体 | 输入价格 | 输出价格 | 特点 |
|---|---|---|---|
| 标准版 | $2/M tokens | $6/M tokens | 与 Grok 4.6 同价同速 |
| 快速版 | $4/M tokens | $12/M tokens | 输出速度翻倍 |
接入渠道覆盖 Cursor(IDE 集成)、Grok Build(官方平台)、Grok API(直接调用)及第三方路由器/云平台。这种多渠道策略确保开发者无需迁移现有工具链即可切换模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。