加州理工学院背景的初创公司 PrismML 正式发布了其最新的微型大语言模型 Ternary Bonsai 2 27B。该模型基于阿里巴巴的 Qwen3.8 27B,通过独特的“三值权重”压缩技术,将模型体积缩小了 9 倍以上(仅占 5.9 GB),同时保留了原始模型 98.2% 的综合基准性能。
- GitHub:https://github.com/PrismML-Eng/Bonsai-demo/
- 模型:https://huggingface.co/collections/prism-ml/bonsai-2
- Demo:https://huggingface.co/spaces/webml-community/ternary-bonsai-2-webgpu-kernels
这一突破意味着,曾经需要昂贵服务器才能运行的高性能推理模型,现在可以轻松部署在高端智能手机、笔记本电脑甚至边缘设备上,且无需牺牲智能水平。
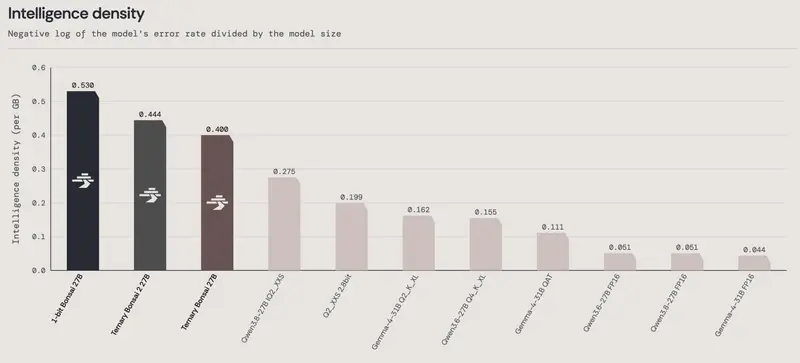
核心技术:三值权重 (Ternary Weights)
PrismML 的压缩方法不同于传统的量化(如 INT4/INT8),它采用了一种极端的三值表示法:
- 原理:将每个权重简化为三个值:+1, -1, 0。
- 效率:配合 FP16 分组缩放,每个权重有效仅占 1.76 位。
- 结果:模型总占用空间从原始的 ~50GB+ 降至 5.9 GB,内存需求减少 9-10 倍。
创始人背景:PrismML 由加州理工学院教授、压缩技术专家 Babak Hassibi 创立,并得到 Databricks 联合创始人 Ion Stoica 的顾问支持。其技术核心在于如何在极度压缩下保持模型的“智能密度”。
性能表现:近乎无损的压缩
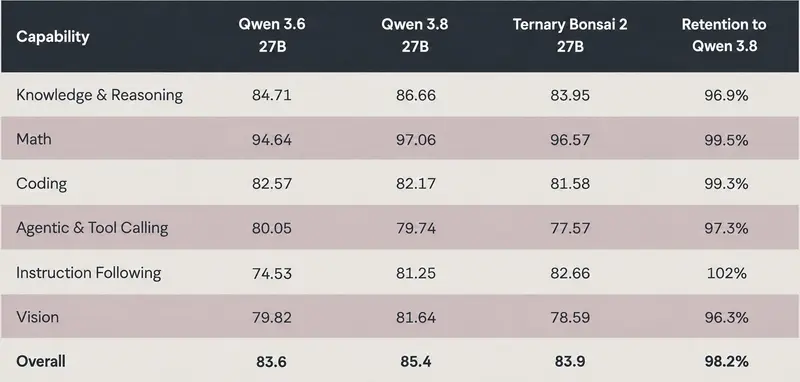
在涵盖推理、编码、视觉和代理能力的综合基准测试中,Bonsai 2 27B 的表现令人印象深刻:
| 能力维度 | Bonsai 2 27B | Qwen3.8 27B (原版) | 保留率 |
|---|---|---|---|
| 数学 | 96.57 | 97.06 | ~99.5% |
| 指令遵循 | 82.66 | 81.25 | 超越原版 |
| 编码 | 81.58 | 82.17 | ~99.3% |
| 代理与工具 | 77.57 | 79.74 | ~97.3% |
| 视觉理解 | 78.59 | 81.64 | ~96.3% |
| 综合得分 | 83.9 | 85.4 | 98.2% |
注:相比第一代 Bonsai (95% 保留率),第二代在关键领域(尤其是编码和代理任务)的性能退化显著降低。
速度与能效:本地推理的新标杆
Bonsai 2 27B 不仅小,而且快且节能,非常适合本地持续运行的 AI 助手:
- NVIDIA RTX 5090:高达 143 tokens/秒。
- Apple M5 Max:高达 46.8 tokens/秒。
- 能效优势:在 RTX 4090 上,每 Token 能耗仅 0.714 mWh,比全精度运行的 8B 模型节能 40%。
这意味着用户可以在本地运行更复杂的编码代理循环、多模态调试或私密文档分析,而无需担心电池耗尽或硬件过热。
生态与部署
- 开源许可:模型权重在 Apache 2.0 许可下发布,允许商业自由使用。
- 平台支持:
- 英伟达显卡:通过 CUDA 内核支持。
- Apple Silicon:通过 MLX 框架支持 Mac、iPhone 和 iPad。
- 上下文窗口:支持 262K 令牌,适合长文档处理和长周期代理任务。
AI 民主化的下一步
PrismML 的愿景是改变 AI 的经济学和架构:
- 隐私优先:数据完全在本地处理,无需上传云端。
- 成本归零:利用用户已拥有的设备算力,消除 API 调用费用。
- 混合架构:本地模型处理高频、敏感任务,仅在必要时升级到云端,实现最优的资源配置。
随着 Bonsai 2 27B 的发布,我们离“每个人口袋里都装有一个顶级 AI 专家”的目标又近了一步。对于开发者而言,这是一个在边缘设备上构建真正智能、响应迅速且隐私安全的应用程序的绝佳机会。
© 版权声明
文章版权归作者所有,未经允许请勿转载。