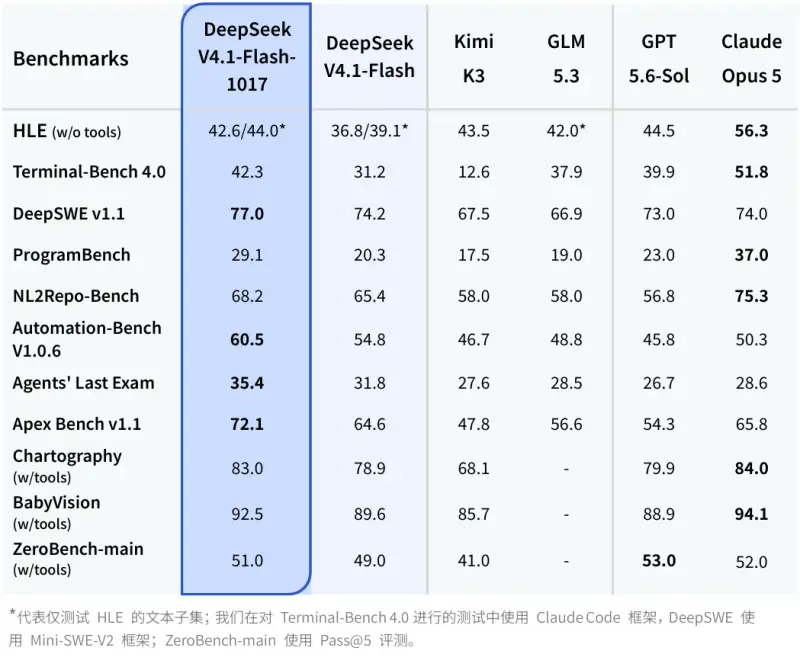
继 8 月 14 日上线 API 服务后,智谱 AI 于 8 月 28 日 正式公开了 GLM-5.3 的模型权重。作为 GLM-5 系列的最新迭代,GLM-5.3 并未更换基础底座,而是通过大规模、高质量的后训练(Post-training)实现了能力的显著跃升,尤其在复杂编程、长周期任务及网络安全领域取得了突破性进展,被官方誉为“当前编码能力最强的开放权重模型”。
- Hugging Face:https://huggingface.co/zai-org/GLM-5.3
- 魔搭:https://modelscope.cn/models/ZhipuAI/GLM-5.3
核心升级:后训练驱动的质变
GLM-5.3 沿用了与 GLM-5.2 相同的基础模型架构,其性能提升完全归功于精细化的后训练策略。这种“旧瓶装新酒”的方式证明了高质量数据与先进训练方法在挖掘模型潜力方面的巨大价值。
1. 编程能力全面领跑
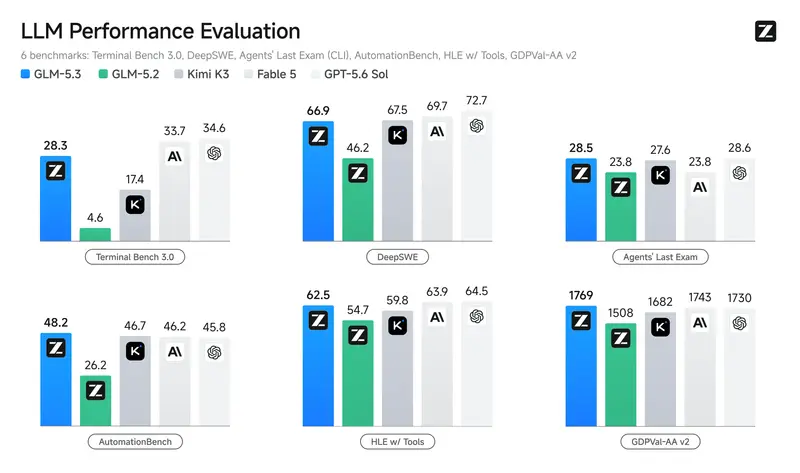
- 内部基准突破:在智谱自研的 Z.ai Code Bench 上,GLM-5.3 相比 GLM-5.2 提升了 50%,展现出对复杂代码逻辑更深刻的理解。
- 开源 SOTA:在 Terminal Bench 3.0 和 Agents’ Last Exam 等权威公开基准测试中,GLM-5.3 均达到了开源领域的最先进水平(SOTA),能够更可靠地处理多步调试、环境配置及长周期开发任务。
2. 涌现的网络安全能力
随着后训练规模的扩大,GLM-5.3 在安全领域展现出了意想不到的“涌现”能力:
- 漏洞发现最佳水平:在 CyberGym 基准测试中,GLM-5.3 在漏洞发现任务上达到当前最佳水平。
- 利用链上游优势:在攻击利用链(Kill Chain)的上游阶段(如侦察、武器化)提升最为显著。
- Exploitation 得分翻倍:在具体的利用(exploitation)基准测试中,其得分超过 GLM-5.2 两倍以上,显示出更强的自动化安全审计与渗透测试潜力。
性能对比概览
| 维度 | GLM-5.2 | GLM-5.3 | 提升幅度/状态 |
|---|---|---|---|
| 基础架构 | 相同底座 | 相同底座 | 无变化 |
| 编程能力 (Z.ai Code Bench) | 基准线 | 显著提升 | +50% |
| 终端操作 (Terminal Bench 3.0) | 优秀 | SOTA | 开源领先 |
| 智能体考试 (Agents’ Last Exam) | 优秀 | SOTA | 开源领先 |
| 漏洞发现 (CyberGym) | 良好 | 最佳水平 | 显著增强 |
| 利用能力 (Exploitation) | 基准线 | 大幅增强 | >200% |
行业意义
GLM-5.3 的开源不仅为开发者提供了一个强大的编码助手,更为安全研究人员提供了一个高效的自动化审计工具。其在长周期任务和复杂逻辑推理上的进步,标志着开源模型在代理(Agent)工作流中的实用性迈上了一个新台阶。
对于希望构建本地化、高安全性代码生成或安全分析系统的企业和团队而言,GLM-5.3 无疑是目前最值得关注的选择之一。随着权重的全面开放,社区有望基于此模型开发出更多垂直领域的创新应用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。