Google Research 正式发布了 TimesFM-3,这是一个拥有 3.3 亿参数的时间序列基础模型。与之前的单变量版本不同,TimesFM-3 原生支持多变量预测,能够在单次前向传递中同时处理多个相关序列、过去协变量以及已知未来的协变量。它在 GIFT-Eval、fev-bench 和 TIME 等主流基准测试中均取得了预训练基础模型的平均排名第一,标志着时间序列预测从“孤立看历史”向“全局看关联”的重大跨越。
- GitHub:https://github.com/google-research/timesfm
- 模型:https://huggingface.co/google/timesfm-3.0-pytorch
核心突破:从单变量到多变量的进化
- 原生多变量支持:
- 此前版本(直至 2.5)仅能基于单个序列的历史进行预测。
- TimesFM-3 在超过 1 万亿个时间点上进行了多变量预训练,能够理解序列间的复杂依赖关系(如冰淇淋销量受天气、促销、节假日等多重因素影响)。
- 零样本通用性:
- 无需针对特定任务微调,即可直接处理三种输入类型:
- 多个目标:联合预测多个序列。
- 过去协变量:仅历史可知的数据(如过去的客流量)。
- 过去-未来协变量:未来值已知的数据(如促销日历、节假日安排)。
- 无需针对特定任务微调,即可直接处理三种输入类型:
- 单次前向传递:
- 摒弃了早期版本的逐块解码方式,采用**连续分块掩码(Contiguous Patch Masking)**技术。
- 在单次前向传递中生成整个预测范围,显著降低延迟和累积误差,并输出每步的 9 个分位数(第 10 至 90 百分位),提供概率预测能力。
架构创新:二维注意力机制
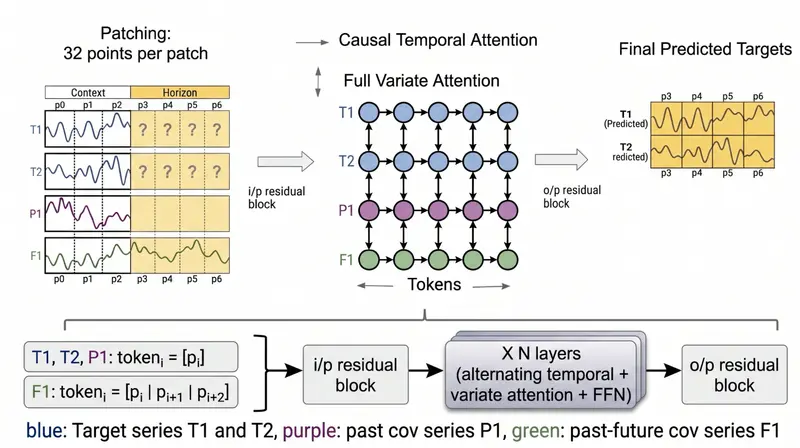
TimesFM-3 的主干网络仍为 Decoder-only Transformer,但引入了独特的二维注意力结构来处理多变量数据:
- 分块与归一化:将连续点分组为 32 步的分块,并按序列归一化,防止量级差异主导模型。
- 因果时间注意力(水平):严格因果,仅在序列内部较早令牌间运行,防止信息泄漏。
- 全变量注意力(垂直):在给定时间步,允许令牌读取该步骤的所有其他序列,从而学习跨序列的相关性。
- 前瞻技巧:对于过去-未来协变量,将当前分块与未来分块拼接,使模型能“预见”预定事件。
性能表现:全面领跑
在多个权威基准测试中,TimesFM-3 均超越了 Chronos-2、Toto 2.0 系列及 TimesFM-2.5:
| 基准测试 | 表现 | 备注 |
|---|---|---|
| GIFT-Eval | 排名第 1 | 基础模型类别 |
| fev-bench | 排名第 1 | 涵盖 100 个真实世界任务 |
| TIME | 排名第 1 | 涵盖 50 个领域数据集及 98 个评估任务 |
部署许可说明
- 代码开源:TimesFM 仓库代码采用 Apache-2.0 许可证。
- 权重限制:TimesFM-3.0 的模型权重以
timesfm-non-commercial-license-v1.0发布,仅限非商业、非生产用途(如学术研究、基准测试)。 - 生产建议:若需用于生产环境,建议继续使用采用 Apache-2.0 许可证的 TimesFM-2.5。
关键要点总结
- TimesFM-3 是首个原生支持多变量的 3.3 亿参数时间序列基础模型。
- 通过交替的因果时间注意力和全变量注意力,实现了零样本下的跨序列依赖建模。
- 利用连续分块掩码技术,在单次前向传递中完成全范围预测,效率与精度双升。
- 虽然在学术基准上全面领先,但其权重的非商业许可限制了其在生产环境的直接应用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。