Liquid AI 发布 LFM2.5-8B-A1B:端侧 MoE 模型新标杆,128K 上下文支持链式工具调用,M5 Max 解码速度达 253 tok/s
Liquid AI 正式发布了 LFM2.5-8B-A1B,这是一款专为消费级硬件设计的端侧混合专家(MoE)模型。作为 LFM2-8B-A1B 的进化版,LFM2.5 将上下文窗口扩展至 128K,预训练数据规模增至 38T Token,并通过大规模强化学习显著提升了工具调用能力与推理可靠性。它旨在让强大的 AI 代理在笔记本电脑甚至手机上也能流畅、私密地运行。
- 官方介绍:https://www.liquid.ai/blog/lfm2-5-8b-a1b
- 模型:https://huggingface.co/LiquidAI/LFM2.5-8B-A1B
核心亮点:端侧性能与可靠性的双重飞跃
1. 极速推理,无处不在
- CPU 极致优化:在 MacBook M5 Max 上解码速度高达 253 token/s,AMD Ryzen AI Max+ 395 上达 146 token/s,内存占用低于 6 GB。
- 移动端可用:在智能手机上仍能保持约 30 token/s 的速度,实现真正的即时响应。
- GPU 高吞吐:在单张 NVIDIA H100 上,高并发下吞吐量达 18.5K output tokens/s。
- 全生态支持:首发即支持 llama.cpp (GGUF), MLX, vLLM, SGLang, ONNX 及 Liquid 自家的 LEAP 平台。
2. 128K 上下文与多语言增强
- 长文档处理:上下文从 32K 扩展至 128K,支持更复杂的推理轨迹和长文档分析。
- 词汇量翻倍:Tokenizer 词汇量从 65K 增至 128K,显著提升非拉丁语言(如印地语、泰语、阿拉伯语等)的编码效率,减少 Token 消耗。
3. 纯推理模式与抗幻觉机制
- 显式思维链:采用纯推理策略,在给出最终答案前生成显式 CoT,利用 MoE 低激活参数优势,在不牺牲速度的前提下提升质量。
- 针对性 RL 优化:
- 防死循环:通过偏好优化识别并抑制长推理中的“Doom loops”。
- 抗幻觉:基于 avg@k 奖励的 RL 阶段,强化模型在知识边界外的弃权行为,降低幻觉率。
技术演进:从 LFM2 到 LFM2.5
| 特性 | LFM2-8B-A1B | LFM2.5-8B-A1B |
|---|---|---|
| 上下文窗口 | 32,768 Tokens | 128,000 Tokens |
| 预训练数据 | 12T Tokens | 38T Tokens |
| 词汇量 | 65,536 | 128,000 |
| 推理模式 | 标准生成 | 显式思维链 (Pure Reasoning) |
| 主要优化 | 基础工具调用 | 链式工具调用、抗幻觉、防死循环 |
实战演示:LocalCowork
Liquid AI 展示了基于 LFM2.5 的开源桌面代理 LocalCowork:
- 完全本地化:在一台笔记本电脑上运行,连接 13 个 MCP 服务器的 67 个工具。
- 零数据泄露:无云依赖、无 API 密钥,所有数据留在设备内。
- 交互式体验:工具调度循环低于 1 秒,实现询问、提议、确认、运行的流畅闭环。
基准测试表现
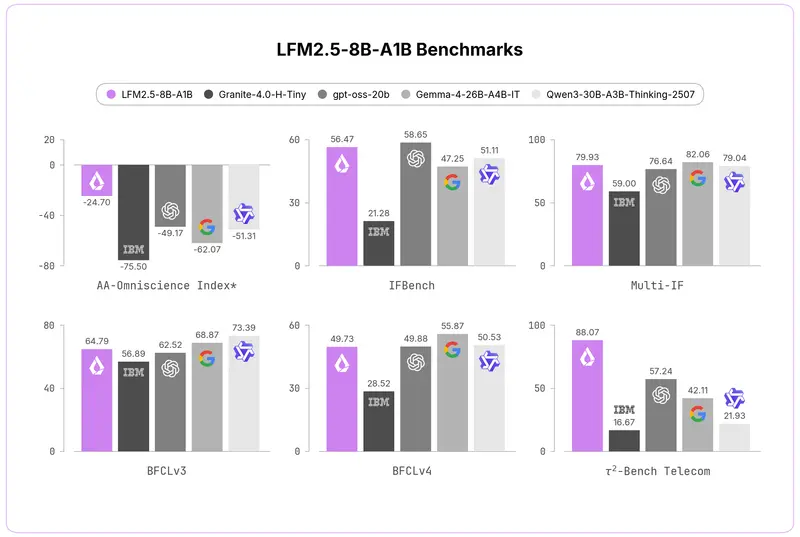
- 代理任务:在 Tau2-Telecom 等基准测试中表现强劲,与更大规模的 MoE 模型具备竞争力。
- 指令遵循:在多项指令遵循基准中领先,以较小的激活参数量实现了高质量输出。
- 数学与推理:得益于思维链和强化学习,在复杂逻辑任务中准确性显著提升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。