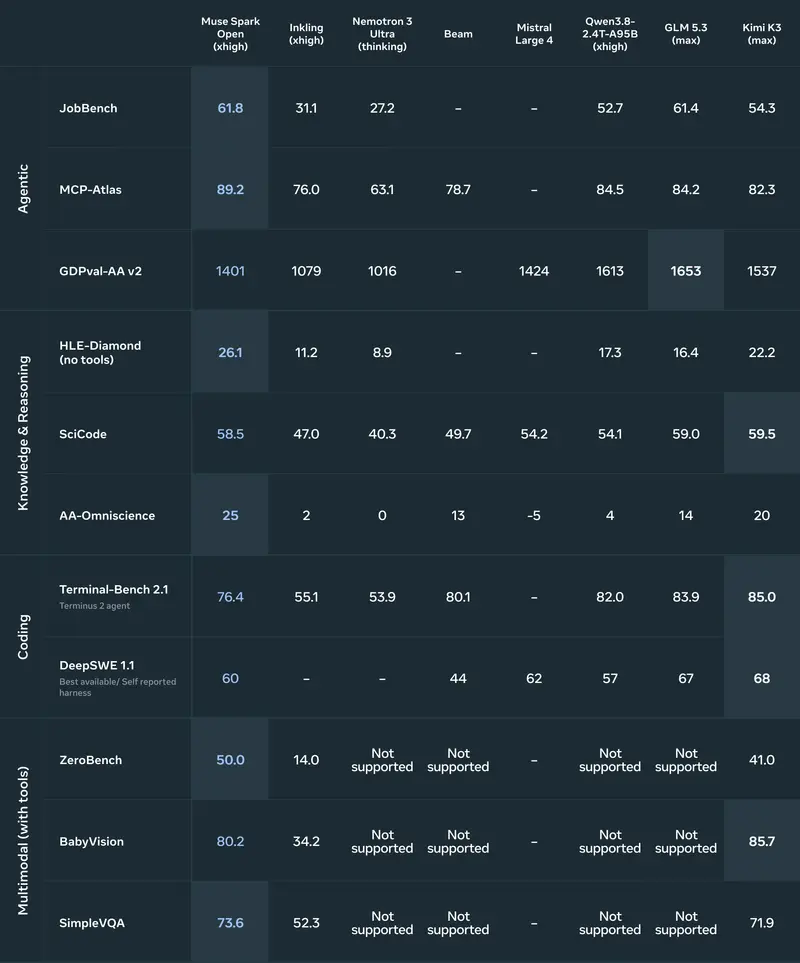
BottleCap AI 推出 ThinkingCap-Qwen3.8-27B,其 ThinkingCap 系列第二款模型,基于 Qwen3.8-27B 微调以实现更短推理轨迹。
- 模型:https://huggingface.co/bottlecapai/ThinkingCap-Qwen3.8-27B
模型可直接替换原版 Qwen3.8-27B,支持 FP8/NVFP4/GGUF/MLX 量化,通过 vLLM/SGLang 部署。采用 PolyForm Small Business 1.0.0 + BottleCap 个人授权,商业使用需单独协议。长上下文检索(AA-LCR)准确率反升 2.25pp,但 AIME 2026 数学竞赛下降 3.85pp,体现任务特异性权衡。
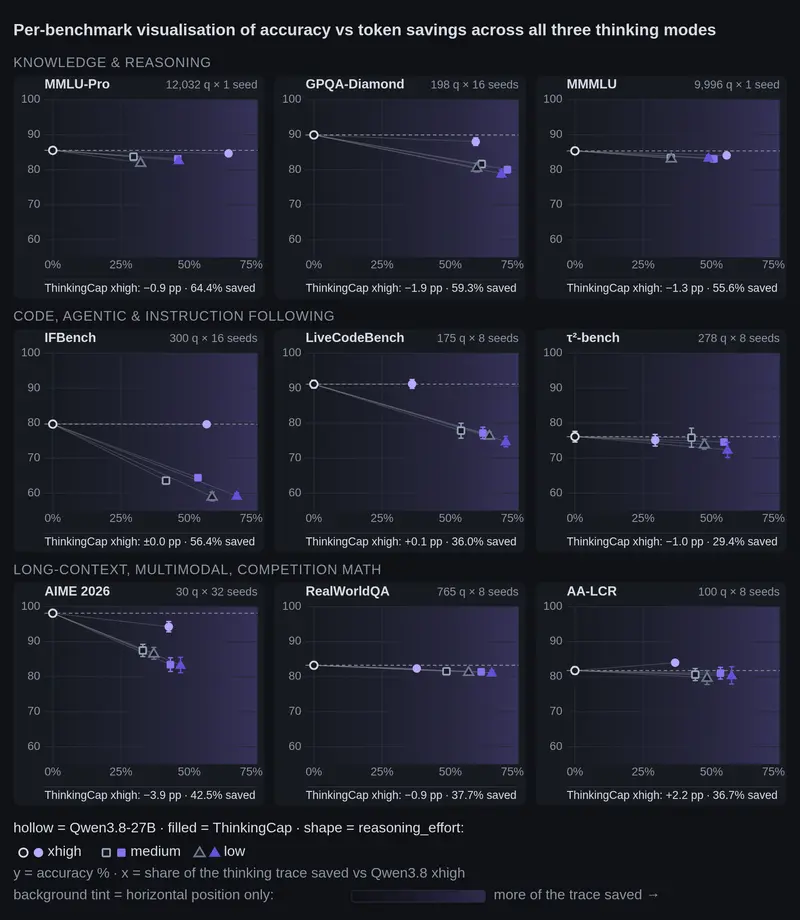
核心性能:效率与精度的精细平衡
xhigh 努力下关键基准变化
| 基准 | 思考 tokens 削减 | 准确率变化 | 说明 |
|---|---|---|---|
| MMMLU | -65.5% | — | 知识/多语言任务压缩最显著 |
| MMLU-Pro | -57.3% | — | 同上 |
| IFBench | -46.4% | -0.04pp | 指令遵循几乎无损 |
| GPQA-Diamond | -43.1% | — | 研究生级问答 |
| AA-LCR | -38.6% | +2.25pp | 长上下文检索准确率提升 |
| LiveCodeBench v6 | -20.3% | +0.07pp | 代码生成微升 |
| τ²-bench | -30.9% | -1.01pp | 智能体任务轻微损失 |
| Terminal-Bench 2.1 | -10.7% | -0.56pp | 在 ±4.26pp 误差范围内 |
| AIME 2026 | -30.2% | -3.85pp | 最大权衡点 |
💡 关键洞察:
- 37.2% 为每基准削减的平均值,非合并 token 总量削减率
- 在 16K-token 预算上限下,ThinkingCap 得分高于基础模型(截断率 0.34% vs 0.51%)
- MTP 投机解码(3 草稿 tokens)对 AIME 准确率中性,接受率 53%
与推理努力拨盘的交互
| 努力级别 | 基础模型思考削减 | ThinkingCap 思考削减 | 准确率代价差 |
|---|---|---|---|
| xhigh | baseline | -37.2% | -0.86pp |
| medium | -52.1% | -60.2% | -0.74pp |
| low | -55.4% | -62.3% | -1.08pp |
| off | — | — | -5.7pp |
⚠️ 团队建议:xhigh 为最佳准确率-token 平衡点;低/中等努力下优势缩小,关闭思考时落后明显。
部署规格与量化选项
| 量化格式 | 大小 | 兼容硬件/运行时 | 备注 |
|---|---|---|---|
| BF16 | 28B params | H200/A100 | 原始检查点 |
| FP8 | 31 GB | Hopper/Blackwell + vLLM | 推荐服务端 |
| NVFP4 (weights-only) | 21 GB | Hopper (Marlin) / Blackwell + vLLM | 最低显存占用 |
| NVFP4 W4A4 (AWQ) | 23 GB | 仅 Blackwell | 全量化 |
| GGUF | 16–55 GB | llama.cpp / LM Studio / Ollama | 本地/CPU 友好 |
| MLX 4-bit DWQ | 21 GB | Apple Silicon (≥32GB) | Mac 本地部署 |
服务配置
vllm serve BottleCapAI/ThinkingCap-Qwen3.8-27B \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_xml
- 思考内容返回于独立
reasoning字段 - 采样参数与基础模型完全相同(temp=1.0, top_p=0.95, top_k=20, min_p=0.0)
许可证与合规要点
- 基础模型:Qwen3.8-27B 部分保持 Apache-2.0
- ThinkingCap 微调权重:PolyForm Small Business 1.0.0 + BottleCap 个人使用授权
- 商业使用:年收入 >$1M 或超出小企业定义需签署 BottleCap 商业协议
- 托管状态:Hugging Face 上尚无第三方推理提供商,需自部署
© 版权声明
文章版权归作者所有,未经允许请勿转载。