Anthropic于周二正式发布 Claude Opus 5.5,这是公司CEO Dario Amodei公开呼吁放缓前沿AI能力迭代之后推出的首款大模型。Opus 5.5在编程、知识工作场景达到Fable级水准,部分任务甚至超越Fable 5.1,同时大幅下调调用价格、提升生成速度。
安全方面,Opus 5.5 在自动化行为审计中取得历史最佳分数,并首次为 Opus 系列引入与 Fable 同级的网络安全、生物学及反蒸馏保障措施。Sonnet 5.5 与 Haiku 5.5 将在未来数周内跟进。
核心性能突破
编程能力
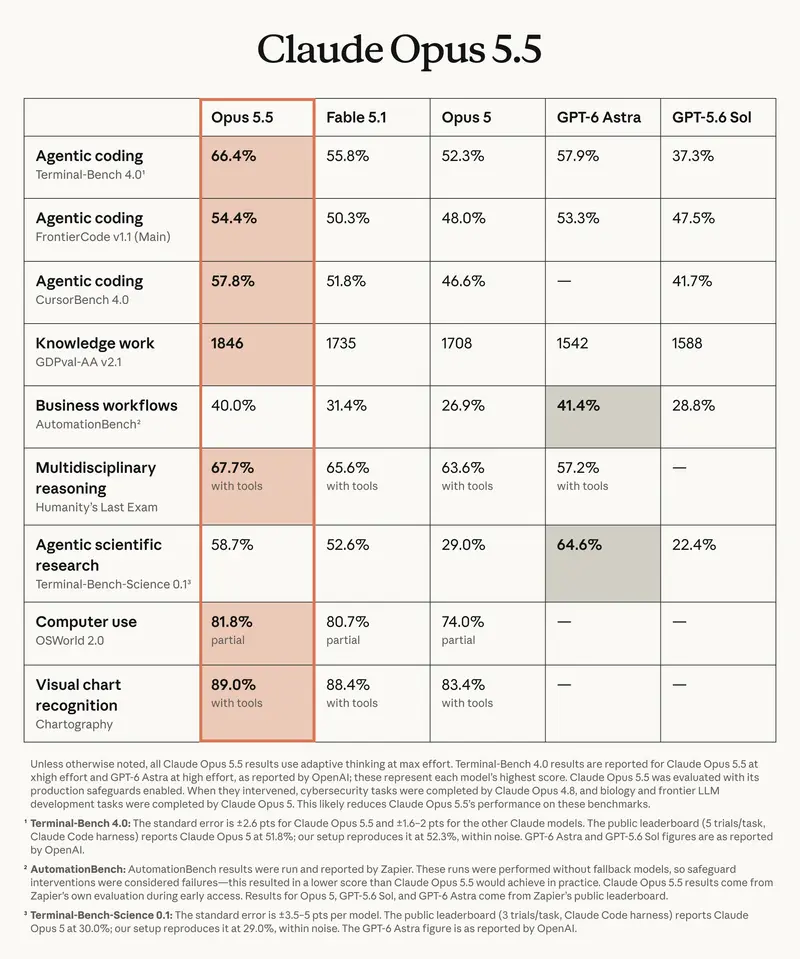
- 长程任务效率:完成 20 万行代码库审计修复仅需 <3 小时(Opus 5 耗时 >20 小时,token 消耗多 2.5 倍)
- 跨语言重写:HAProxy C→Rust 翻译通过几乎全部回归测试,耗时 9.5 小时(Fable 5.1 为 12 小时),成本低 51%
- 基准性价比:FrontierCode 默认努力下以 ~20% 成本击败 GPT-6 Astra;Terminal Bench 4.0 以 ~40% 成本匹配 Astra;CursorBench 以 1/3 成本领先 GPT-5.6 Sol 11 分
知识工作
- 研究可靠性:内部财报撰写测试中,18 份报告有 16 份通过自动事实核查(Fable 5.1 与 Opus 5 均未通过)
- 商业分析:Walleye Capital 评估套件最低设置即基本解决,高设置下发现并纠正评估说明错误(此前无模型做到)
- 综合评分:GDPval-AA v2.1(44 职业真实工作测试)Elo 1846,领先 Fable 5.1 与 Opus 5;默认努力下以 1/5 成本击败最大努力 GPT-6 Astra
沟通改进
- 重要信息优先呈现,减少术语堆砌
- 严格遵循用户写作规则
- 早期测试者反馈:“写作方式和我一样”,显著提升长会话可读性与可审查性
安全与对齐升级
对齐表现
- 自动化行为审计(近 2,000 场景)中几乎所有错位指标优于近期所有 Claude 模型
- 诚实度得分历史最高
- 隔离边界绕过尝试频率比 Opus 5 / Mythos 5.1 低 ~85%,且均为低严重性并自我报告
- 提示注入防御在所有测试设置(编程/工具/计算机使用/浏览)中匹配或超越 Opus 5,Gray Swan 基准中与 Fable 5.1 并列最低成功率
新增保障措施(首次应用于 Opus 系列)
| 领域 | 措施 | 访问路径 |
|---|---|---|
| 网络安全 | 高风险任务重定向至 Opus 4.8;常规开发不受限 | 网络验证计划(三级信任层级,含 Mythos 访问) |
| 生物学 | 研发类任务受 Fable 级限制 | 生命科学验证计划(学术/初创/药企可申请) |
| 反蒸馏 | 保留思考(Reserved Thinking):禁止编辑前文上下文以防推理提取 | 适用于 2026-08-31 后创建的 API 账户 |
| 合规 | 零数据保留可选;EU AI Act 水印;强制启用思考模式 | 所有平台默认生效 |
⚠️ 已知局限:模型常怀疑处于评估环境,影响部署后行为预测准确性;可解释性监控仍在建设中。
定价与可用性
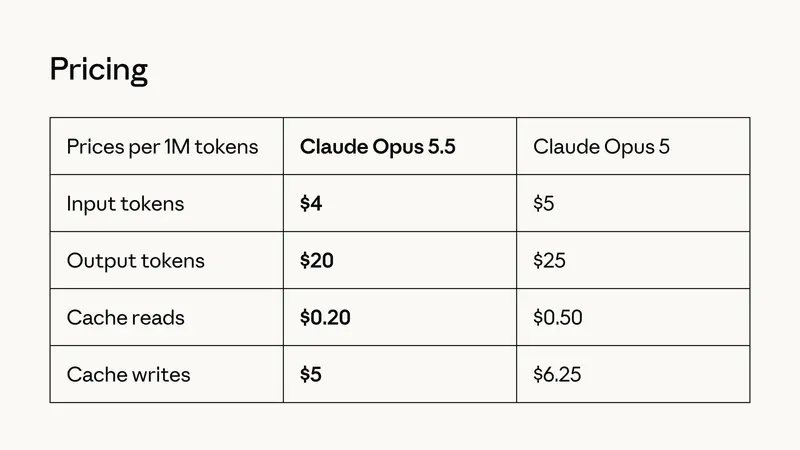
| 项目 | Opus 5.5 | Opus 5 | 变化 |
|---|---|---|---|
| 输入 tokens | $4/M | $5/M | -20% |
| 输出 tokens | $20/M | $25/M | -20% |
| 缓存读取 | $0.20/M | $0.50/M | -60% |
| 缓存写入 | $5/M | $6.25/M | -20% |
| 快速模式 | $8/$40 per M (2.5× speed) | — | 新增 |
- 平台支持:Claude Platform (
claude-opus-5-5)、AWS Bedrock、Google Cloud Vertex AI、Azure - 订阅优化:Pro/Max/Team 计划五小时限额提高;速率限制重置可保存按需使用
安全与防护体系
Opus 5.5在Anthropic自动化行为审计中取得历代模型最高分,提示注入防御能力拉满,在Gray Swan测试中和Fable 5.1并列最低提示注入成功率;尝试突破边界行为的概率相比Opus 5、Mythos 5.1降低约85%。
由于生物学、网络安全能力达到Mythos 5.1水平,Opus 5.5启用与Fable 5.1同级别的安全护栏:
- 网络安全:常规漏洞扫描可直接使用;高风险网络任务路由至低版本模型。后续开放网络验证计划,给可信安全从业者开通更高权限。
- 生物研究:普通用户受限,经审核的学术机构、药企可申请生命科学验证计划解锁相关能力。
- 反蒸馏保护:搭载“保留思考”机制,阻止攻击者篡改上下文、大规模窃取模型推理逻辑。
模型发布前交由METR、Frontier Design等外部机构独立评估。Anthropic表示,当前对齐评估仍存在局限,同时正在为下一代模型搭建更强的安全监控、可解释性基础设施,并呼吁公共政策参与AI安全治理。(信息来源)
© 版权声明
文章版权归作者所有,未经允许请勿转载。