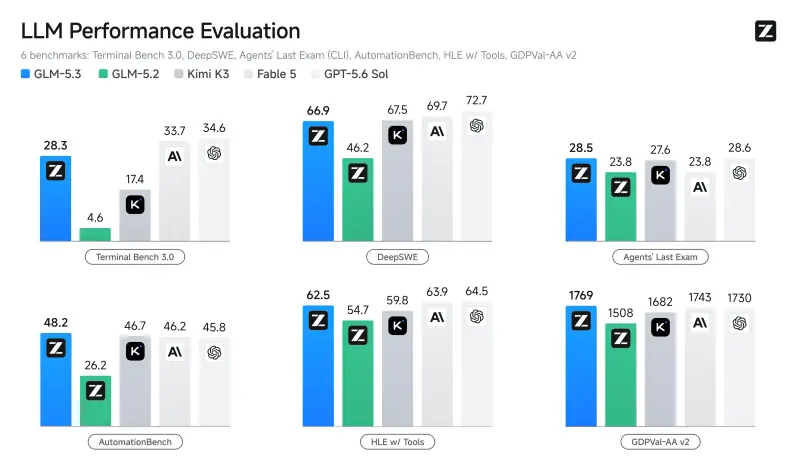
智谱发布 GLM-5.3:后训练加强编程能力与网络安全能力智谱 AI 今日正式发布 GLM-5.3。与上一代 GLM-5.2 相比,新模型保持了相同的基座架构,其性能飞跃完全归功于后训练阶段的规模扩展(Post-training Scaling)。通过引入数...大语言模型早报# GLM-5.3# 智谱2个月前1560
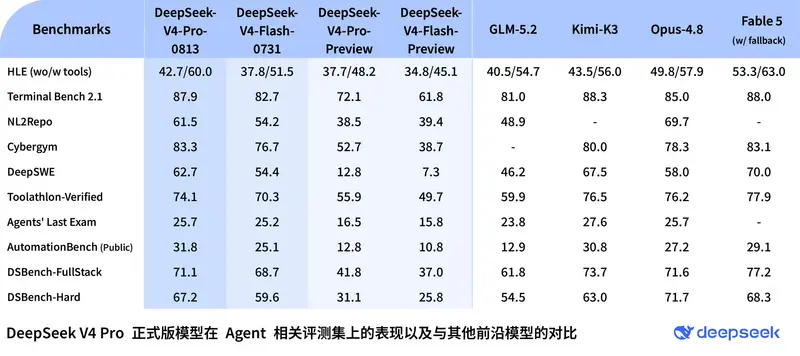
DeepSeek-V4-Pro 正式版上线:增强 Agent 能力,API 引入峰谷定价DeepSeek 今日晚间宣布,DeepSeek-V4-Pro 正式版(版本标识为 DeepSeek-V4-Pro-0813)已在 App、网页端及 API 同步上线。此次更新重点强化了模型在生产环境...大语言模型# DeepSeek-V4-Pro# DeepSeek-V4-Pro-08133个月前790
Cactus推出Needle 2:14MB 的极致轻量的端侧工具调用模型在 AI 模型日益庞大的今天,Cactus 推出了 Needle 2,一款仅重 14MB、运行内存仅需 28MB 的开源小模型。它专为工具调用、设备控制和结构化数据提取而设计,以极致的轻量化和自包含架...大语言模型# Cactus# Needle 23个月前1190
Qwen3.8-2.4T-A95B 正式开源:阿里通义千问首次开放 Max 级别权重,2.4T 参数重塑 Agent 基准北京时间 8 月 12 日晚间,阿里通义千问(Qwen)团队迎来里程碑式时刻:Qwen3.8-2.4T-A95B 模型权重正式向全球开发者开放。这是 Qwen-Max 级别的旗舰模型首次实现权重开源...大语言模型# Qwen3.8-2.4T-A95B# 阿里3个月前1200
DeepSeek V4 Pro 正式版(DeepSeek-V4-Pro-0813)发布:Agent 能力跃升,定价极具竞争力8月12日晚间,DeepSeek V4 Pro 正式版(版本号 DeepSeek-V4-Pro-0813)已经上线 API。尽管官方尚未发布正式公告,但第三方平台 OpenRouter 已率先上架该模...大语言模型早报# DeepSeek-V4-Pro# DeepSeek-V4-Pro-08133个月前1460
Grok 4.6 正式发布:对标 GPT-5.6 Sol,强化长程智能体与全栈开发能力北京时间 8 月 12 日晚间,xAI 正式推出 Grok 4.6。作为 Grok 4.5 的迭代升级版本,新模型在长时间运行的智能体任务、复杂交互逻辑以及视觉工作流处理上实现了显著突破。在权威基准测...大语言模型早报# Grok 4.6# xAI3个月前1370
英伟达推出Nemotron 3.5 Lightning:30B MoE 模型,专为高吞吐量 AI 代理加速在 AI 代理(Agent)从“单次对话”走向“长时间自主执行”的今天,速度与成本成为了新的瓶颈。英伟达今日正式推出 Nemotron 3.5 Lightning,这是一个开放的 30B 混合专家(M...大语言模型# Nemotron 3.5 Lightning# 英伟达3个月前880
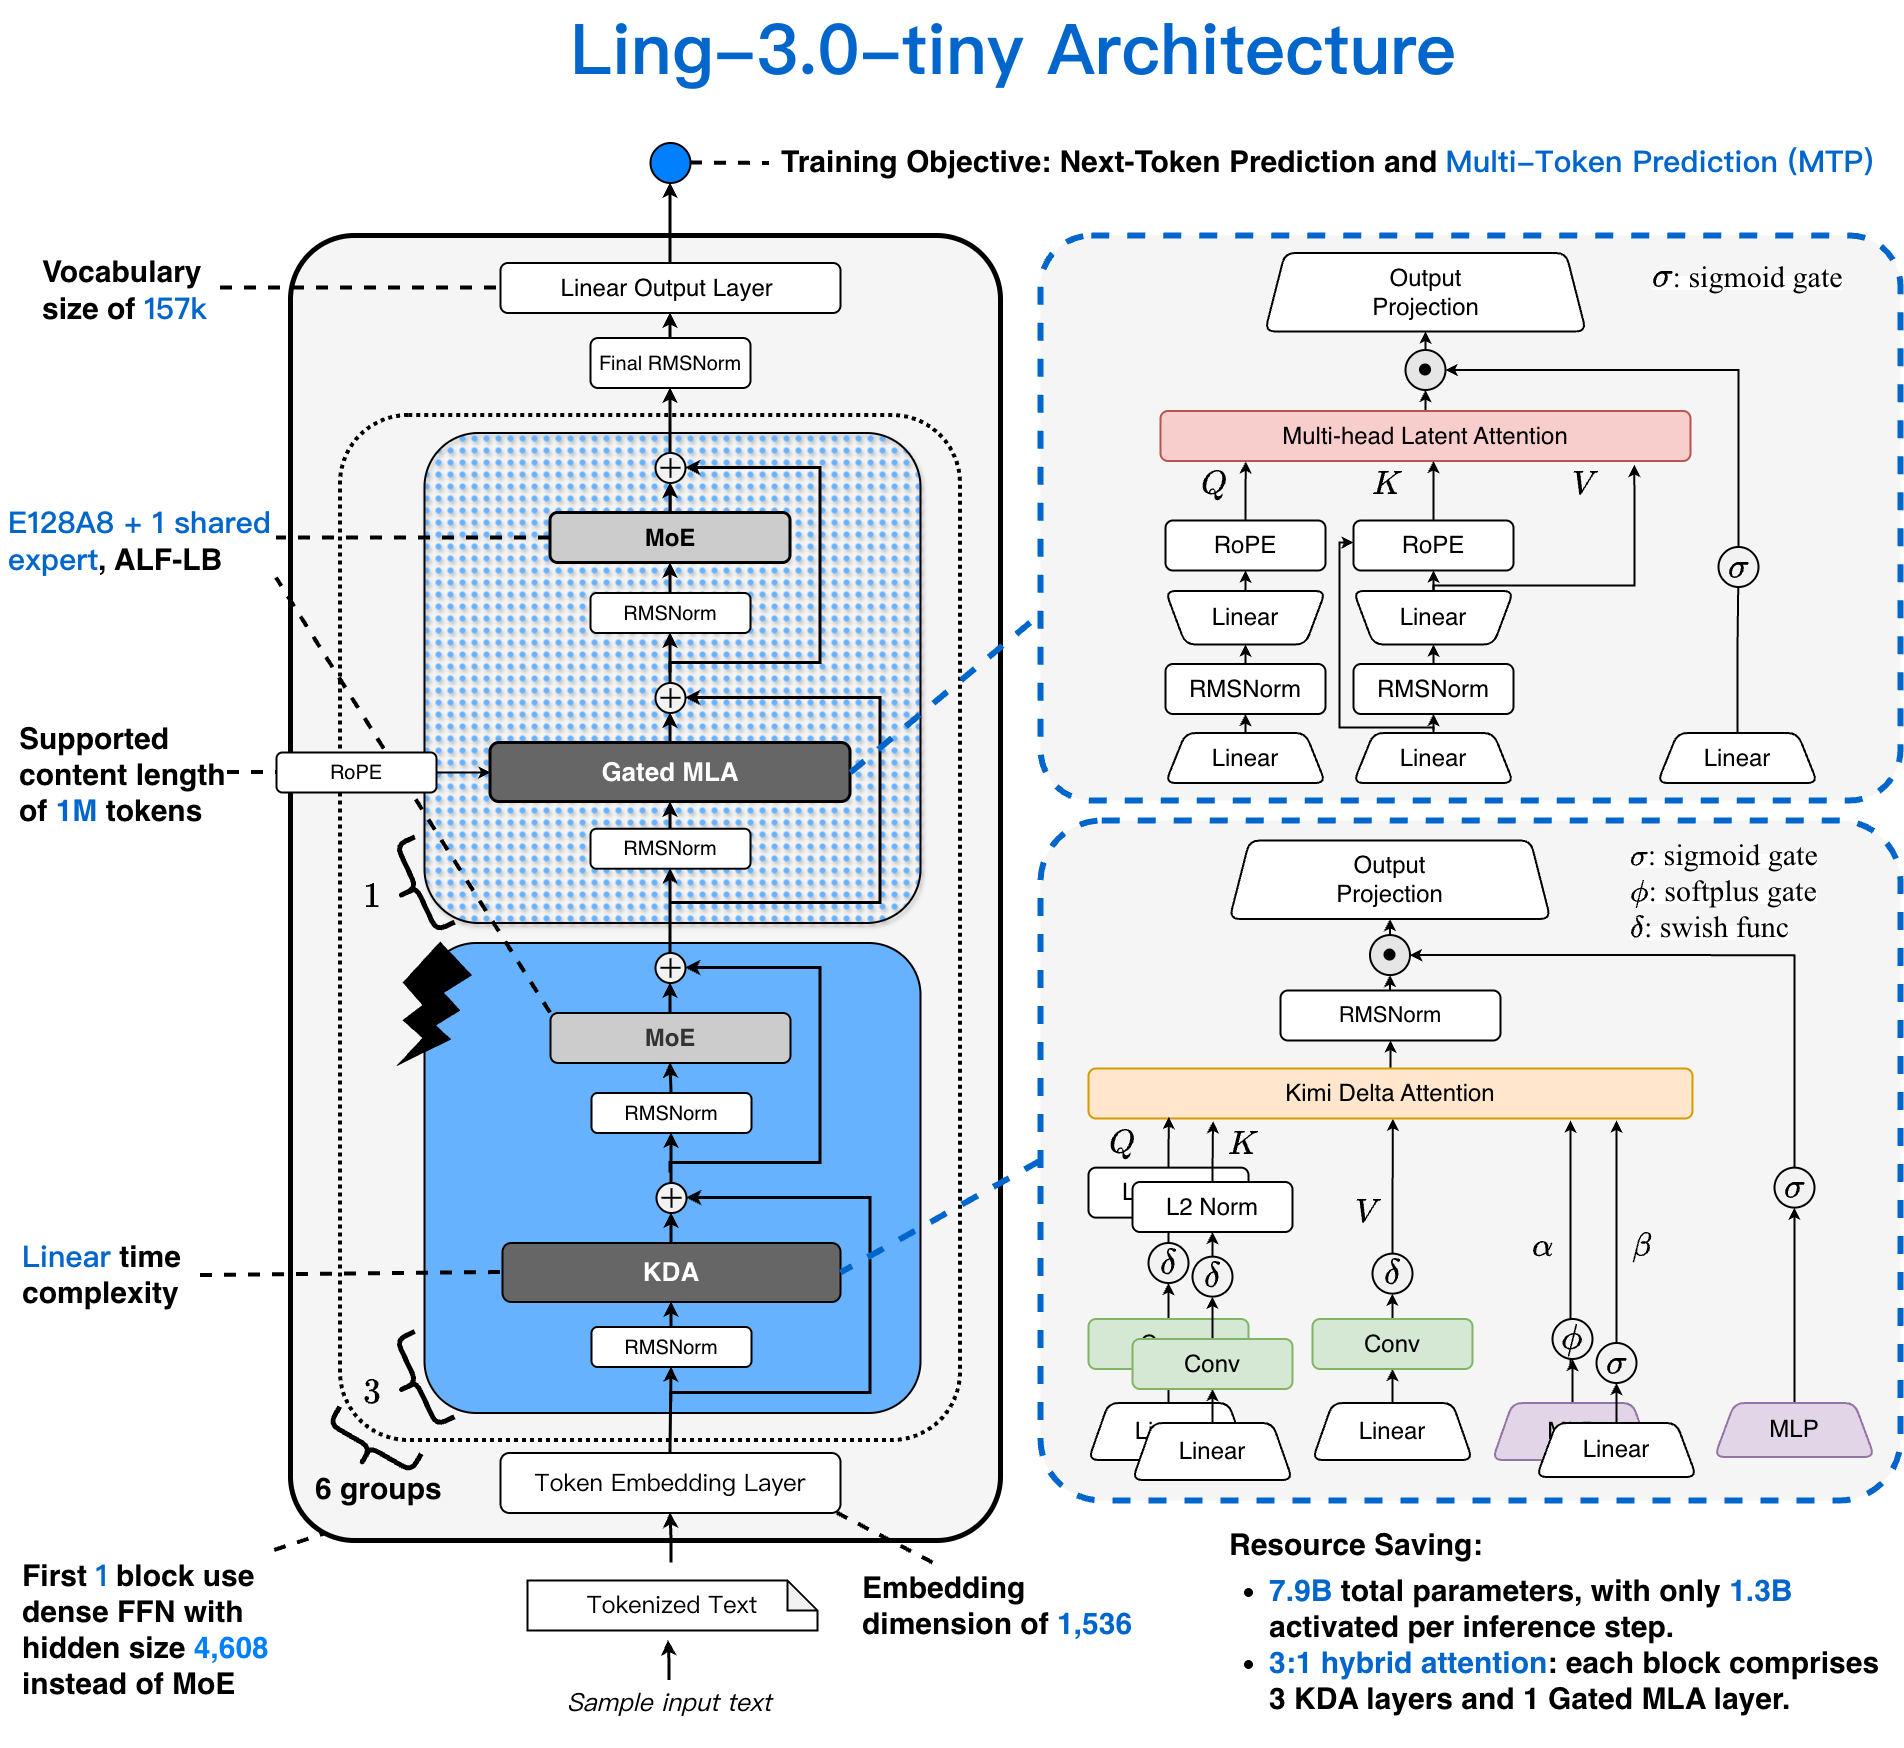
蚂蚁百灵开源 Ling-3.0-tiny:7.9B 参数仅激活 1.3B,M4 Pro MacBook 跑出 90 Token/s在 AI 模型日益庞大的今天,如何让高性能模型在本地设备上流畅运行成为开发者的核心痛点。蚂蚁集团旗下的蚂蚁百灵(Ant Bailin)今日在 Hugging Face 正式开源 Ling-3.0-ti...大语言模型# Ling-3.0-tiny# 蚂蚁百灵3个月前1060
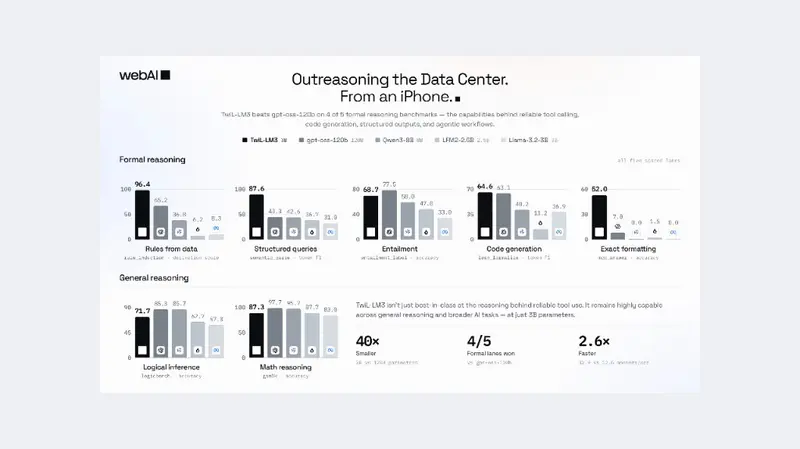
webAI发布TwIL-LM:1.78GB 的本地形式逻辑推理器,让 AI 学会“严谨思考”在大语言模型(LLM)普遍存在“幻觉”和逻辑跳跃的背景下,webAI 发布了 TwIL-LM 系列模型。这是一个专为自动形式化(Auto-Formalization)设计的轻量级模型家族,包含 1.7...大语言模型# TwIL-LM# webAI3个月前1000
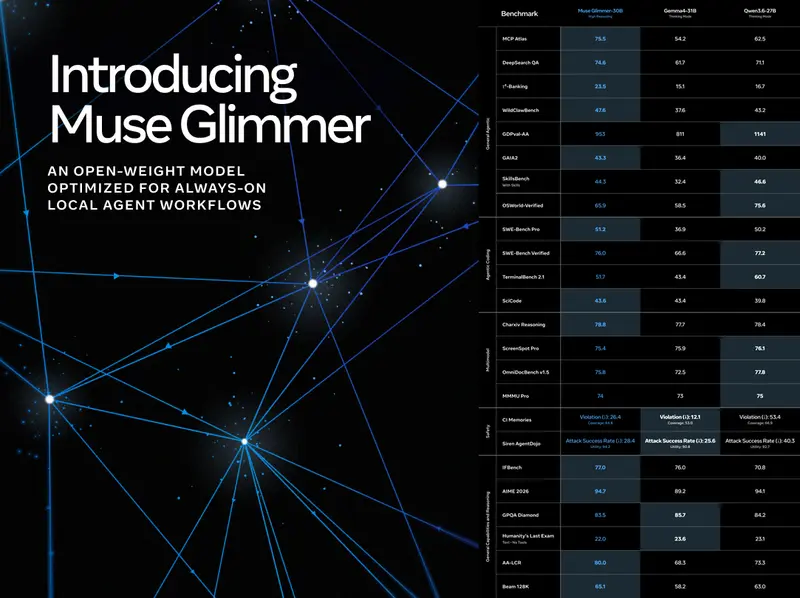
Meta 开源Muse Glimmer:30B本地代理大模型,消费级显卡就能跑Meta超级智能实验室又放出开放权重新模型 Muse Glimmer,采用宽松的 Apache 2.0 协议开源权重。同时官方预告,未来几周,旗下最强模型 Muse Spark 1.2 也会放出开放权...大语言模型# Meta# Muse Glimmer3个月前1160
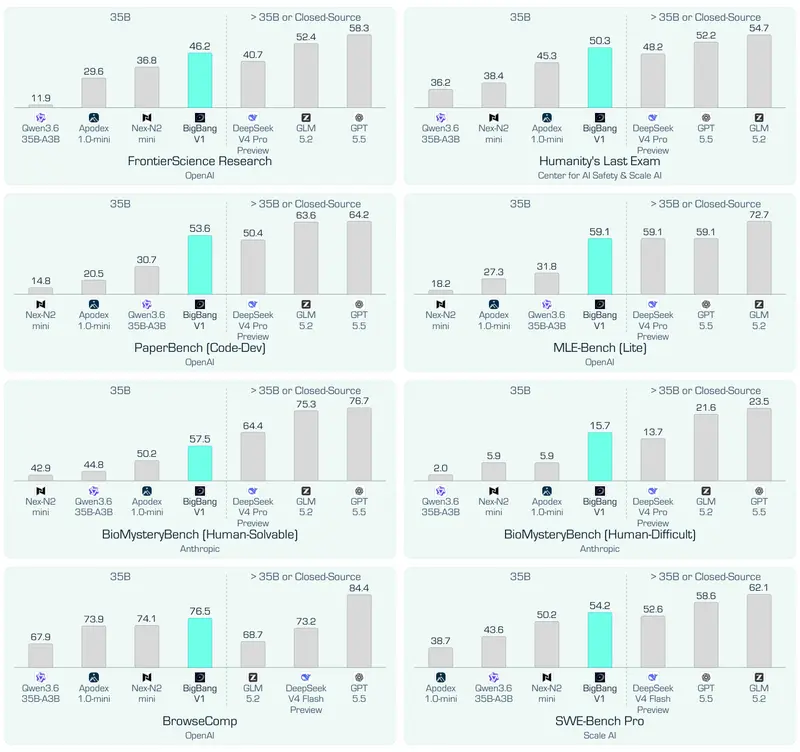
上海Endless Frontier科技发布BigBang-v1:35B-A3B代理模型,自我演进合成数据驱动前沿任务突破上海Endless Frontier科技发布BigBang-v1,一款基于Qwen3.6-35B-A3B构建的35B总参数、3B激活参数的MoE代理模型。通过对抗性自我演进合成数据框架(生成器+评判器...大语言模型# BigBang-v1# Endless Frontier3个月前2730
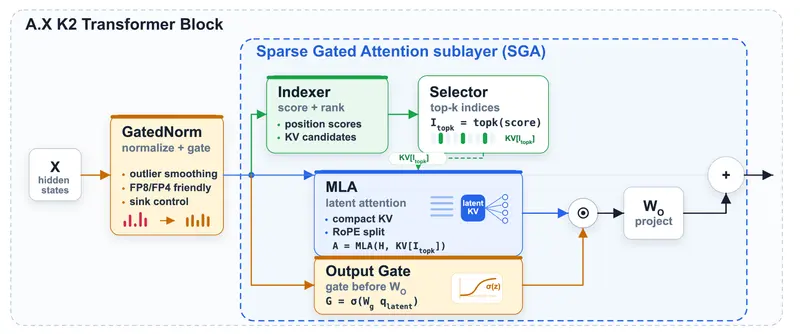
韩国SKT AI推出A.X K2:韩国主权AI基础模型,688B MoE架构支持混合推理与原生FP8训练SKT AI推出的A.X K2是一款从零训练的6880亿参数混合专家(MoE)语言模型,作为韩国政府主权AI基础模型项目的核心成果,旨在构建对韩语及文化有深度理解的前沿模型。该模型每个token仅激活...大语言模型# A.X K2# SKT AI3个月前1080