Perplexity Research 联合 turbopuffer 推出 pplx-embed-v2-context-9b-preview,一款面向RAG链路的上下文嵌入模型。它在完整文档全局视野下对文本块做嵌入,训练目标不再只寻找单一“金段落”,而是同时检索答案与支撑答案所需证据。
- 模型:https://huggingface.co/perplexity-ai/pplx-embed-v2-context-9b-preview
模型权重以MIT许可证发布在Hugging Face,支持本地自托管预览版本,暂未接入Perplexity官方API;模型卡提示权重与接口后续可能调整,不保证向后兼容。
加载依赖:transformers>=5.4.0,开启trust_remote_code=True
传统RAG嵌入痛点:金段落标注的局限
常规RAG会将长文档切分块,用单一“金段落”作为正样本训练嵌入。但文档里很多信息依赖别处的定义、标题、实体,只标记单个最优块存在不少短板:二元标签信号粗糙;人工LLM标注成本随数据集线性上涨;模型能力绑定固定分块策略,难以适配不同切分方式。
训练原理
这套模型以Perplexity查询感知上下文压缩模型作为教师模型,同时读取查询+全文,对每个token打分:
- 块相关性:取块内top n token分数均值;
- 软目标:正文档内块使用温度缩放softmax,其他文档块置零;
- 蒸馏损失:师生分布前向KL散度;
- 文档级损失:InfoNCE,借鉴ColBERT MaxSim思路,用文档最优块打分。
训练批次会随机切换分块策略,使用<|chunk_sep|>分隔块并池化。教师模型仅训练阶段启用,推理阶段不会增加延迟与存储开销。
模型基于内部9B ColBERT检索模型初始化,线性投影输出2048维,Matryoshka嵌套训练支持1024维;量化感知训练支持原生int8嵌入。该版本是多检查点模型融合,训练集包含约430个数据集,覆盖50+语言,训练集不含ConTEB数据。
全新评测基准 context-bench
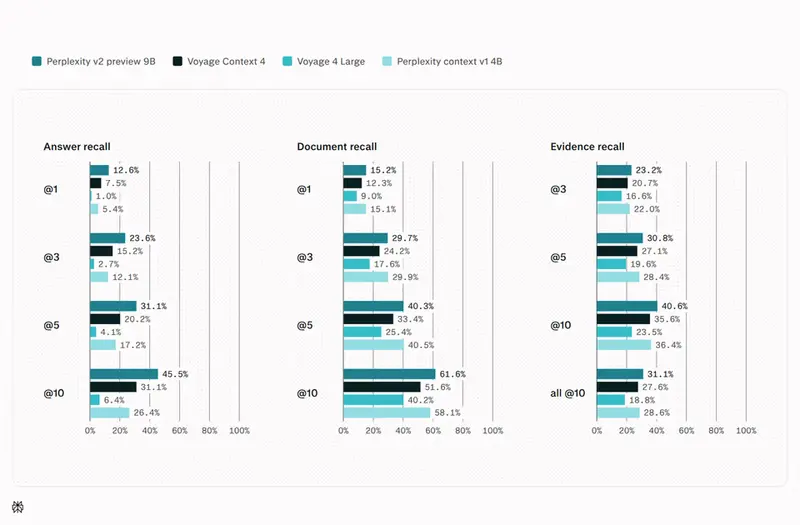
由turbopuffer搭建,数据集私有以防止训练污染。包含21个领域、2099条查询,38894篇文档,句子分块得到245万+文本块;目标文档中位长度约6100token。测试覆盖代词解析、表格理解等12类上下文能力,本次为盲提交测试。
评测指标包含Document@K、Answer@K、Evidence Recall@K、All-Evidence@K,对全部块做穷尽排序,排除索引方案带来的干扰。
核心评测结果
- context-bench K=10:答案召回45.5%,证据召回40.6%,全证据召回31.1%
- 文档召回:K=1 15.2%,K=10 61.6%
- 对比voyage-context-4:K=10答案召回高出14.4个点,证据召回高出5分
- ConTEB基准:参评模型中平均nDCG@10最高
- 通用检索:查询到块任务平均最优;查询到文档任务略弱于voyage-context-4
- 存储优势:1024维int8向量仅1KB,对比voyage-context-4的2048维float32(8KB),占用空间大幅下降
- 块大小鲁棒性:块长64~512token区间,分数仅从81.0%小幅降至79.9%
竞品对比
| 特性 | pplx-embed-v2-context-9b-preview | voyage-context-4 | pplx-embed-context-v1-4B | Nemotron-3-Embed-8B |
|---|---|---|---|---|
| 嵌入方式 | 上下文嵌入 | 上下文嵌入 | 上下文嵌入 | 单块独立嵌入 |
| 获取方式 | 开放权重 MIT | 托管API | 开放权重 MIT / Perplexity API | 开放权重 OpenMDW-1.1 |
| 参数规模 | 博客标注9B,HF卡写8B | 未披露MoE骨干 | 4B | 约8B |
| 向量维度 | 2048 /1024 | 2048/1024/512/256 | 2560(Matryoshka) | 4096,可切片 |
| 量化 | 原生int8 | int8、uint8、binary | int8、binary | Float |
| 上下文上限 | 32768 token | 单请求32K,自动分块最长120K | 32K | 32768 token |
| 自动分块 | 无 | 有 | 无 | 无 |
| 使用成本 | 自托管 | 百万token 0.12美元,前2亿免费 | 自托管或API | 自托管 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。