Allen AI(Ai2)正式开源 AstaBrief 8B,这是一款专为科研工作打造的开放权重报告生成模型,集成在Asta科研智能体平台,作为Fast快速报告模式,和基于Claude的Thinking高精度模式并行使用;模型权重、训练数据集同步对外开源,科研机构可本地私有化部署。
- 模型:https://huggingface.co/allenai/AstaBrief_8B
AstaBrief的核心目标:接收研究问题+检索到的文献片段,一次性直接生成完整带引用的科研综述报告,不再分章节逐段生成,省去多轮摘要、聚类的昂贵步骤,大幅缩短生成耗时。
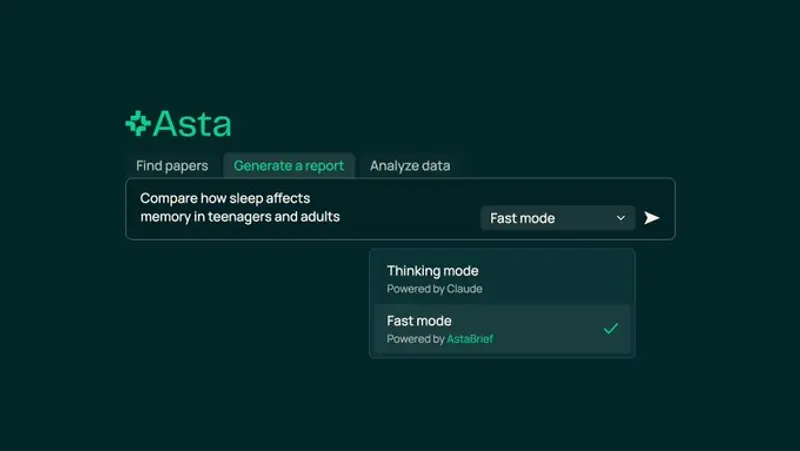
在Asta完整管线实测:Fast模式(AstaBrief)平均每份报告 51.1秒,原Claude驱动Thinking模式178.5秒,速度提升约3.5倍,同时降低推理成本。
模型训练路线
基座选用Qwen3-8B,训练没有采用复杂不稳定的强化学习RL方案,选择SFT监督微调 + DPO直接偏好优化的简易、易调试方案,项目重心放在训练数据筛选与证据归因过滤。
- SFT数据集:从Asta平台真实科研查询日志筛选,清洗隐私、无效请求后保留9万条科研查询,借助ScholarQA管线,调用Claude、GPT系列模型生成完整带引用报告,质量过滤后得到47K训练样本;
- DPO偏好数据集:独立查询子集生成成对报告,由GPT-4.1、DeepSeek-R1双评判模型打分,仅保留两个评判者达成一致的样本,最终得到约6K高质量偏好数据,减少偏好数据噪声;
- 关键数据过滤策略:重点过滤低引用密度样本。报告中大段无引文支撑文字会直接剔除;额外引入四项统计指标辅助筛选:输出输入token比例、引用相关性、引用密度、引用多样性。实验发现,引用密度过滤带来的收益最大,比复杂多过滤器组合效果更好。
评估体系,聚焦科研特有的「证据保真」
科研综述最大痛点:模型引用文献,但容易夸大原文结论、过度泛化(把小样本结论扩大为通用结论,将客观描述变成政策建议)。
评估基准以SQABench-CS2(200条计算机科研问题)为主,配套DeepScholarBench与人工评估,核心四个指标:
- Rubric分数:内容完整覆盖度
- 答案精确率:段落和研究问题是否相关
- 引用精确率:引文是否支撑对应论断
- 引用召回率:报告里所有主张是否有文献支撑
小规模人工评测:DR-Tulu整体偏好排名第一;但两位科研评审人员在引用准确性上,更偏爱AstaBrief,验证这套数据过滤方案在引文接地任务上的优势。
平台使用与部署价值
- 线上使用:Asta平台开启双模式。Fast(AstaBrief)快速生成初稿;Thinking模式适合需要深度、严谨文献综合的重度科研场景。用户数据:374位试用用户,23%用户直接固定使用Fast模式,18%按需切换两种模式,Fast模式正面反馈率84.2%,和Thinking模式(85.2%)差距很小。
- 私有化能力:开放权重,机构可部署在内网环境,处理未发表、敏感科研资料,不必依赖第三方模型API;附带示例工作流,支持从本地PDF批量构建文献报告。
后续研发方向
当前AstaBrief属于Ai2科学AI系列实验,后续计划探索细粒度偏好学习、RAG+RL组合方案,拓展多轮对话、工具调用能力。同时完善评估维度,不止校验引文是否存在,进一步检测模型会不会随意放大原文结论、不当泛化研究成果。
注:模型评估工作主要在2025年完成,评测对照的是当年的前沿模型,并未使用最新模型重新跑全套基准,成果重点验证训练、数据过滤这套工程方法,而非单纯比拼榜单。
要点总结
- AstaBrief 8B,Ai2开源科研报告模型,基座Qwen3-8B,SFT+DPO训练;
- 技术特点:一次性输出完整报告,跳过分段摘要,推理提速约3.5倍;
- 核心亮点:围绕引文接地做数据过滤,抑制AI编造、夸大科研结论;
- 部署选项:Asta平台线上Fast模式,同时支持本地私有化部署,适配涉密科研材料;
- 用户反馈:近四分之一用户固定使用Fast模式,用户好评率接近Claude管线;
- 局限:评测基于2025年模型基线,后续将继续优化证据范围校验、多工具能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。