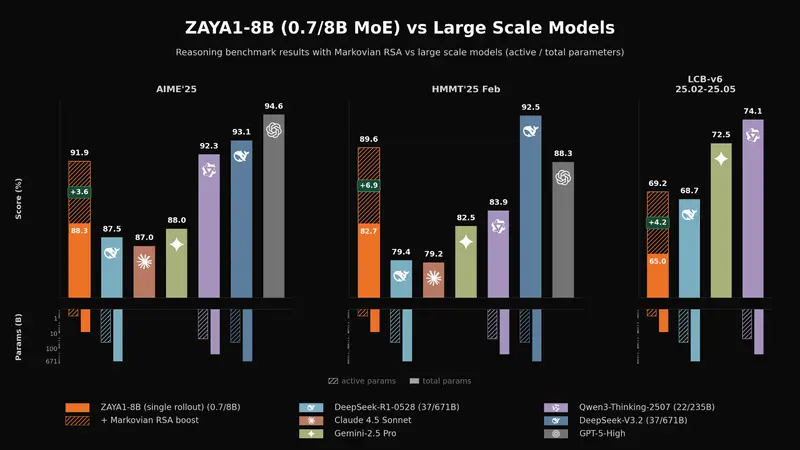
在大型语言模型日益臃肿的今天,如何以更少的计算资源实现更强的推理能力成为行业焦点。Zyphra AI 正式发布 ZAYA1-8B,一款基于混合专家(MoE)架构的小型语言模型。尽管总参数仅为 84 亿,但其每次前向传递仅激活 7.6 亿参数,却在数学和编码基准测试中超越了参数量数倍于它的开源模型,甚至在特定任务上击败了 Claude 4.5 Sonnet 和 GPT-5-High。
- 官方介绍:https://www.zyphra.com/post/zaya1-8b
- 模型:https://huggingface.co/Zyphra/ZAYA1-8B
更引人注目的是,ZAYA1-8B 是首款在 AMD Instinct MI300 硬件集群上完成端到端训练(预训练、中间训练、SFT)的 MoE 模型,现已以 Apache 2.0 许可证开源。
核心突破:为何 ZAYA1-8B 如此强大?
1. MoE++ 架构:三项关键创新
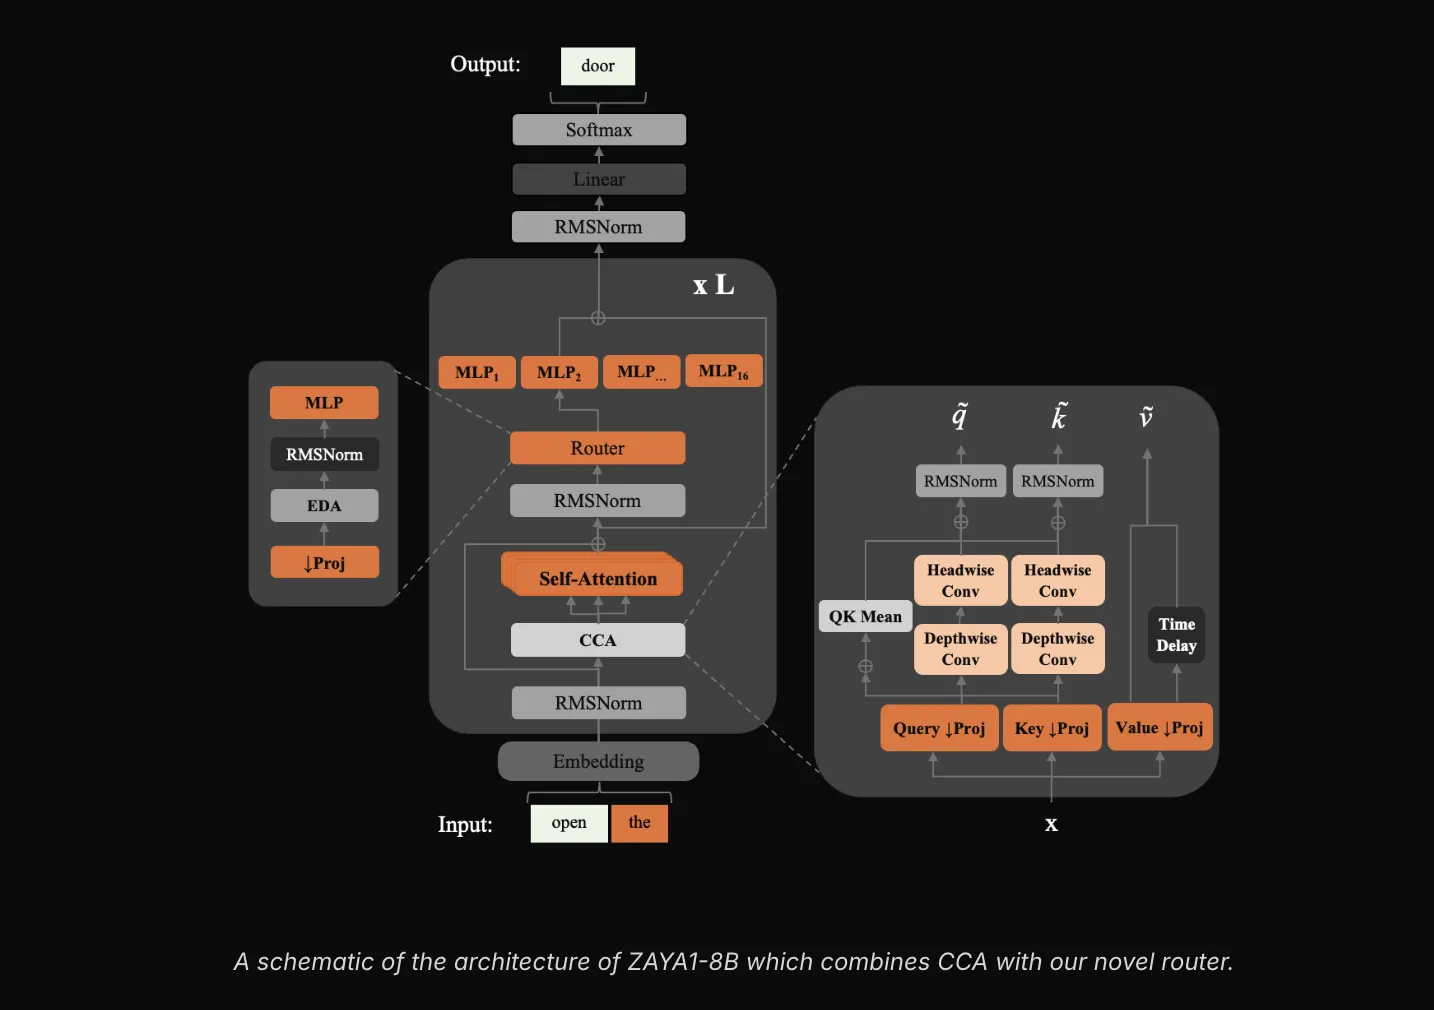
Zyphra 自研的 MoE++ 架构旨在最大化每参数和每 FLOP 的智能提取效率:
- 压缩卷积注意力 (CCA):在压缩潜在空间中运行序列混合,实现 8 倍 KV 缓存压缩,显著降低显存占用并提升长上下文处理能力。
- 基于 MLP 的路由器 + PID 控制:取代传统线性投影路由器,采用 MLP 路由器并结合 PID 控制器风格的偏置平衡,主动防止专家负载不均,提升路由稳定性。
- 学习的残差缩放:以极低开销控制残差流范数随深度增长,解决深层网络训练不稳定的问题。
2. Markovian RSA:革命性的测试时计算 (TTC)
ZAYA1-8B 引入了新颖的 Markovian RSA 推理方法,结合了递归自聚合与马尔可夫分块思想:
- 并行轨迹生成:对每个提示并行生成多个推理轨迹。
- 固定长度尾部聚合:仅提取每个轨迹的固定长度尾部片段,通过子采样构建新的聚合提示,确保上下文窗口有界。
- 协同设计优势:模型在后训练阶段即针对此机制进行优化,使其能高效理解聚合提示。
- 性能飞跃:在每问题 550 万 token 的高计算预算下,ZAYA1-8B 在 APEX-shortlist 数学基准上超越了 DeepSeek-V3.2 和 GPT-OSS-High。
3. AMD 全栈训练:打破 NVIDIA 垄断
- 硬件底座:基于 1,024 个 AMD Instinct MI300x 节点构建的训练集群,通过 AMD Pensando Pollara 互连。
- 合作共建:该集群由 Zyphra 与 IBM 共同构建,证明了 AMD 生态在大规模 MoE 模型训练中的可行性与高效性。
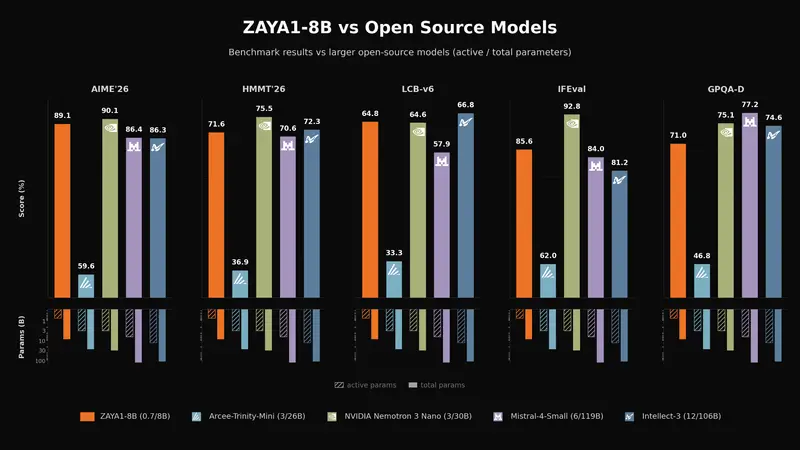
基准测试表现:小身材,大智慧
| 基准测试 | ZAYA1-8B 表现 | 对比模型 |
|---|---|---|
| HMMT’25 | 超越 | Claude 4.5 Sonnet, GPT-5-High |
| APEX-shortlist | 超越 | DeepSeek-V3.2, GPT-OSS-High (配合 Markovian RSA) |
| AIME’26 / LiveCodeBench | 优于 | Qwen3-4B-Thinking, Gemma-4-E4B-it |
| GPQA-Diamond / MMLU-Pro | 略逊于 | Mistral-Small-4-119B (知识广度劣势) |
💡 结论:在需要深度逻辑推理的数学和编码领域,ZAYA1-8B 展现了极高的性价比;而在依赖广泛知识储备的任务上,更大参数的稠密模型仍具优势。
五阶段后训练流程
ZAYA1-8B 的性能得益于精心设计的后训练策略:
- 标准 SFT:涵盖聊天、指令遵循、基础编码与数学。
- 推理预热:结合逻辑谜题与 TTC 提示,训练自我聚合能力。
- RLVE-Gym:动态调整难度,强化核心推理回路。
- 大规模 RL:深耕数学与编码领域。
- 轻量级 RLHF/RLAIF:优化聊天行为与写作风格。
关键要点总结
- 极致效率:仅 7.6 亿激活参数,即可提供媲美百亿级模型的数学/编码推理能力。
- 架构创新:MoE++ 引入 CCA、PID 路由器和残差缩放,显著提升稳定性与效率。
- 推理增强:Markovian RSA 测试时计算方法,通过并行聚合与有界上下文,实现推理性能的质的飞跃。
- AMD 生态里程碑:首个在 AMD MI300 集群上完整训练的 MoE 模型,验证了非 NVIDIA 硬件的训练潜力。
- 开源友好:Apache 2.0 许可证,可在 Hugging Face 下载权重,或通过 Zyphra Cloud 使用无服务器端点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。