周二,一家名为 Subquadratic 的迈阿密初创公司从隐身模式走出,发布了一款名为 SubQ 1M-Preview 的大语言模型。该公司宣称,这是首个完全摆脱自 2017 年以来主导 AI 行业的“二次方计算约束”的模型。
- 官方介绍:https://subq.ai/introducing-subq
如果其主张属实——即在 1200 万 token 上下文下,注意力计算量减少近 1000 倍,且成本仅为竞品的一小部分——这将是 AI 基础设施经济学的转折点。然而,由于缺乏同行评审论文和独立验证,AI 研究界反应两极分化:有人视其为自 Transformer 以来最大的突破,有人则警告这可能是“AI 版的 Theranos”。
核心主张:次二次稀疏注意力 (SSA)
1. 打破二次方瓶颈
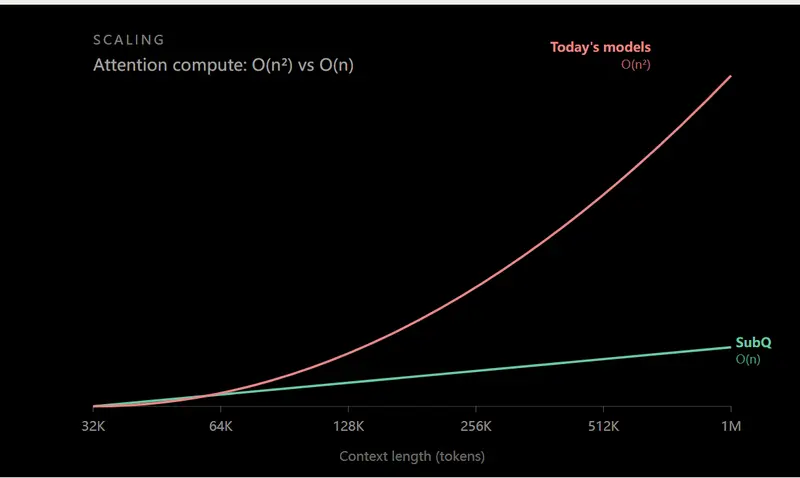
传统 Transformer 模型的注意力机制要求每个 Token 与其他所有 Token 进行比较,导致计算量随序列长度呈 $O(N^2)$ 增长。这使得长上下文处理极其昂贵且缓慢。
Subquadratic 提出的 次二次稀疏注意力 (Subquadratic Sparse Attention, SSA) 旨在将复杂度降低至接近线性 $O(N)$:
- 内容相关选择:模型基于语义意义动态识别重要的 Token 比较,而非固定位置模式。
- 跳过无效计算:仅在高重要性位置计算注意力,大幅减少冗余运算。
- 三阶段训练:教会模型积极利用远处上下文,避免默认依赖邻近信息。
2. 惊人的性能与成本数据
- 加速比:在 128K token 时预填充加速 7.2 倍;在 100 万 token 时加速 52.2 倍。
- 基准测试:
- SWE-Bench Verified:81.8%(优于 Opus 4.6 的 80.8%)。
- RULER 128K:95%(略高于 Opus 4.6 的 94.8%)。
- MRCR v2(长上下文多跳检索):第三方验证得分 65.9%,远超 Claude Opus 4.7 (32.2%) 和 Gemini 3.1 Pro (26.3%)。
- 成本优势:据称在 RULER 128K 上,SubQ 成本仅 $8,而 Claude Opus 约为 $2,600。
争议与质疑:数据背后的阴影
尽管数字诱人,但研究界指出了多个值得警惕的信号:
1. 基准测试的局限性
- 单次运行:由于推理成本高,每个基准仅运行一次,缺乏置信区间,存在偶然性。
- 任务偏向:所选基准(编码、长文本检索)正是 SubQ 优化的领域,缺乏通用能力评估。
- 研究与生产差距:在 MRCR v2 上,研究论文声称得分为 83,但第三方验证的生产模型仅为 65.9,17 分的差距未得到合理解释。
- SWE-Bench 依赖 Harness:公司承认 SWE-Bench 的优势很大程度上取决于测试 harness 而非模型本身。
2. “AI 版 Theranos”的担忧
- 历史重演?:2024 年,Magic.dev 曾宣称拥有 1 亿 token 上下文和 1000 倍效率提升,融资 5 亿美元后却销声匿迹。Subquadratic 的故事与之惊人相似。
- 技术来源疑云:知名 AI 工程师 Will Depue 指出,SubQ 可能是对 Kimi 或 DeepSeek 稀疏注意力的微调,而非从头构建的新架构。
- 团队背景:虽然团队来自 Meta、Google 等大厂,但联合创始人无基础性 AI 研究论文发表,且技术报告“即将推出”,缺乏透明度。
3. 商业模式的矛盾
- 高估值与低披露:种子轮估值高达 5 亿美元,融资 2900 万美元,但未开源权重,未披露 API 定价,未公开收入。
- 投资者偏好:主要投资者来自消费科技领域(如 Tinder 联合创始人),而非深度技术 AI 风投,引发对其技术扎实性的怀疑。
行业意义:如果它是真的?
尽管质疑声不断,Subquadratic 提出的问题至关重要:AI 能否在不牺牲质量的前提下实现真正的线性扩展?
- RAG 的终结?:如果长上下文变得廉价且高效,企业将不再需要复杂的检索增强生成(RAG)管道,直接输入全文即可。
- 代理编排简化:目前花费数十亿美元建设的上下文管理和代理 orchestration 基础设施可能变得多余。
- 经济学重塑:AI 应用的边际成本将大幅下降,催生全新的应用场景。
关键要点总结
| 维度 | Subquadratic 主张 | 研究界质疑/现状 |
|---|---|---|
| 架构创新 | 次二次稀疏注意力 (SSA),线性扩展 | 可能是现有稀疏注意力(如 DeepSeek/Kimi)的微调 |
| 性能提升 | 1000 倍计算量减少,52 倍加速 | 缺乏独立复现,基准测试单一且仅运行一次 |
| 成本优势 | 长文本处理成本降低 99%+ | API 定价未公开,无法验证实际账单 |
| 透明度 | 计划提供训练工具,不开放权重 | 无同行评审论文,技术报告延期,黑盒操作 |
| 历史参照 | 自称突破性创新 | 类似 Magic.dev 案例,曾有“雾件”前科 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。