大型语言模型(LLM)虽然能力强大,但其内部运作往往像一个“黑盒”。当模型出现语言混合、无限重复或拒绝安全请求等异常行为时,开发者通常缺乏有效的工具在内部计算层面进行诊断和修复。
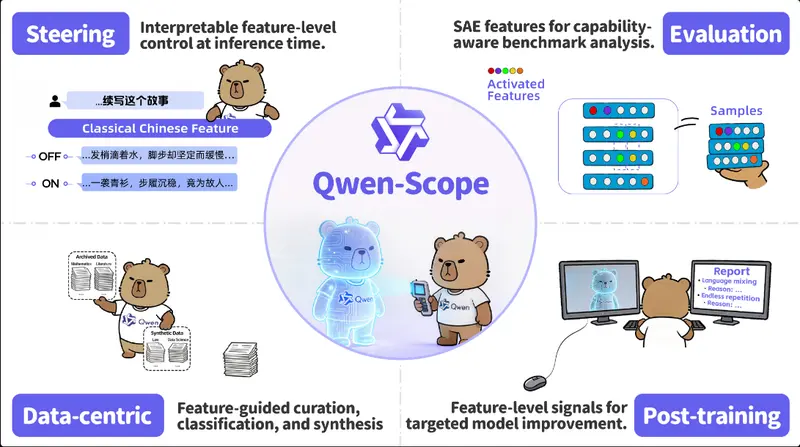
阿里Qwen项目组正式发布了 Qwen-Scope,这是一个基于 稀疏自编码器 (Sparse Autoencoders, SAE) 的开源套件,旨在将 Qwen3 和 Qwen3.5 系列模型的内部高维激活转化为人类可理解的实用特征。这不仅是一次技术发布,更是一场模型可解释性(Mechanistic Interpretability)走向工程化应用的革命。
- 项目主页:https://qwen.ai/blog?id=qwen-scope
- Huggingface:https://huggingface.co/collections/Qwen/qwen-scope
- 魔搭:https://modelscope.cn/collections/Qwen/Qwen-Scope
什么是 Qwen-Scope?为什么它至关重要?
Qwen-Scope 包含跨 7 个模型变体(5 个稠密 + 2 个 MoE)的 14 组 SAE 权重。它充当了原始神经网络激活与人类可理解概念之间的“翻译层”。
- 解构高维状态:LLM 的隐藏状态是数千维的向量,难以直接解读。SAE 将其分解为稀疏的潜在特征字典,每个输入仅激活少量特征。
- 概念映射:每个被激活的特征往往对应一个具体的概念,如“中文语言”、“古典文学风格”或“毒性表达”。
- 全覆盖:针对每个主干网络的每个 Transformer 层训练独立的 SAE,提供逐层的特征视图。其中 Qwen3.5-27B 的 SAE 在 Instruct 版本上训练,其余在 Base 版本上训练。
Qwen-Scope 如何改变四大开发工作流?
1. 推理时导向 (Inference-Time Steering)
无需修改模型权重,即可通过干预内部特征来引导模型行为。
- 原理:在推理过程中,向残差流添加或减去特定特征方向。
- 案例:
- 消除语言混合:识别并抑制高激活的“中文语言”特征,彻底解决英文提示中混入中文的问题。
- 风格控制:激活“古典中文”特征,成功引导故事续写呈现古典文学风格。
2. 零成本评估分析 (Cost-Free Evaluation)
传统基准测试昂贵且耗时,Qwen-Scope 提供了一种基于特征激活的高效替代方案。
- 特征冗余度量:通过分析基准测试样本激活的特征集合,判断测试间的冗余度。
- 优化测试套件:发现 GSM8K 63% 的特征已被 MATH 覆盖,建议在包含 MABH 的套件中省略 GSM8K,从而节省大量算力。
- 能力探测:低特征重叠的基准测试探测不同能力,应保留;高重叠则可合并。
3. 以数据为中心的安全工作流
SAE 特征可作为轻量级分类器和数据合成引擎,大幅提升安全对齐效率。
- 多语言毒性分类器:无需训练额外分类头,仅通过识别在毒性样本中频繁触发的 SAE 特征并应用 OR 规则,即在英、中等 13 种语言上实现 F1 > 0.90 的分类效果。
- 特征驱动数据合成:识别现有数据中缺失的安全特征,生成旨在激活这些特征的合成数据。
- 效果:仅用 4k 合成示例 + 4k 真实示例,即达到 77.75% 的安全准确率,接近使用 120k 纯安全数据的性能,极大降低了数据标注成本。
4. 后训练优化:SFT 与 RL
将 SAE 特征信号引入训练过程,解决传统微调难以处理的顽固问题。
- 监督微调 (SASFT):通过辅助正则化损失抑制非目标语言特征,在多个模型上将意外代码切换率降低 超过 50%,甚至完全消除。
- 强化学习 (RL):针对无限重复问题,利用 SAE 特征导向合成“重复偏向”的负样本 rollout,纳入 DAPO RL管道。
- 结果:在 Qwen3 系列模型上,重复率急剧下降,同时保持通用基准性能不变。
技术架构亮点
- 过完备表示:对于稠密模型,SAE 宽度扩展至隐藏大小的 16 倍;对于 MoE 模型,提供标准和更宽两种版本以捕获细粒度结构。
- Top-k 激活:仅保留最大的 k 个潜在激活用于重建,确保特征的稀疏性和可解释性。
- 逐层字典:为每个 Transformer 层构建独立的特征字典,提供深度的模型内部视角。
© 版权声明
文章版权归作者所有,未经允许请勿转载。