今天,Mistral AI 宣布将其编程智能体从本地笔记本电脑迁移至云端,并发布了全新的旗舰模型 Mistral Medium 3.5。这一更新标志着 AI 辅助编程从“交互式助手”向“自主异步代理”的重大转变。
- 模型:https://huggingface.co/collections/mistralai/mistral-medium-35
- 官方介绍:https://mistral.ai/news/vibe-remote-agents-mistral-medium-3-5
通过 Mistral Vibe 和 Le Chat,开发者现在可以启动在云端独立、并行运行的编程会话。即使你关闭电脑或离开对话,代理仍会继续工作,完成后通过 GitHub PR 或通知告知你结果。
核心发布一:Mistral Medium 3.5 —— 旗舰级稠密模型
Mistral Medium 3.5 是 Mistral 首款将指令遵循、推理和编程能力合并到单一权重集中的旗舰模型。
关键特性
- 架构:128B 参数稠密模型(非 MoE),拥有 256k 上下文窗口。
- 开源可用:以修改后的 MIT 许可证在 Hugging Face 开放权重发布。
- 高效自托管:仅需 4 张 GPU 即可自托管,大幅降低企业部署门槛。
- 可配置推理:支持按需调整推理努力程度,既能快速回答聊天,也能处理复杂代理任务。
- 原生视觉能力:从头训练的视觉编码器,支持可变图像尺寸和宽高比。
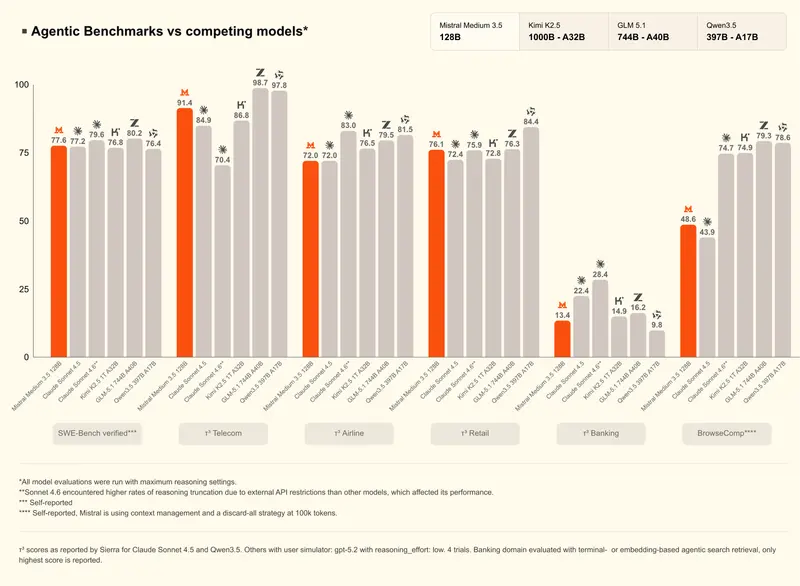
性能表现
- SWE-Bench Verified:得分 77.6%,超越 Devstral 2 和 Qwen3.5 397B A17B 等主流模型。
- τ³-Telecom:得分 91.4%,展现强大的代理工具调用能力。
- 结构化输出:专为长时间、多步骤任务构建,能可靠生成下游代码可用的结构化数据。
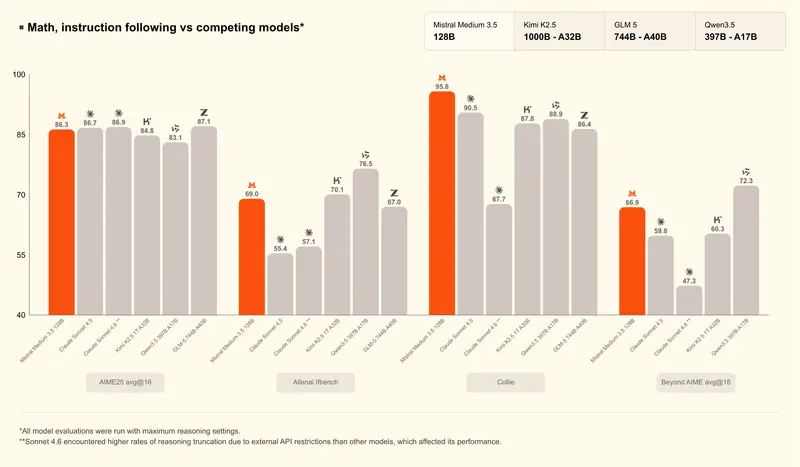
定价:API 价格为输入 $1.5/百万 tokens,输出 $7.5/百万 tokens。也可通过 NVIDIA NIM 和 build.nvidia.com 使用。
核心发布二:Mistral Vibe 远程代理 —— 异步并行编程
传统的编程代理往往受限于本地终端,用户必须等待每一步完成。Mistral Vibe 远程代理彻底改变了这一模式:
核心优势
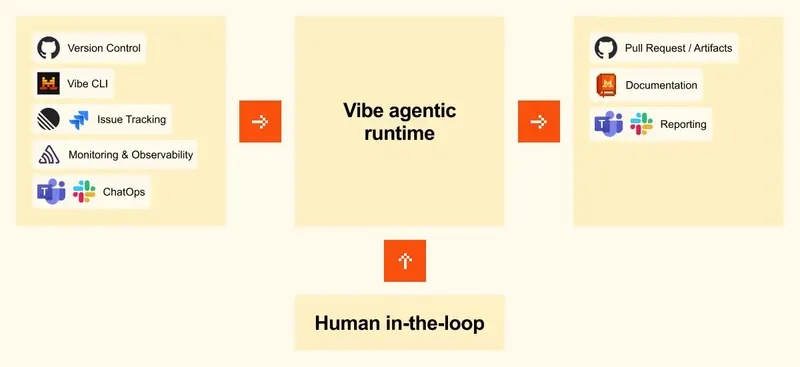
- 云端异步运行:会话在云端沙箱中独立运行,支持多任务并行。你不再是代理执行的瓶颈。
- 无缝迁移:可将正在进行的本地 CLI 会话一键迁移至云端,保留历史、状态和审批记录。
- 全栈集成:直接接入 GitHub(代码/PR)、Linear/Jira(问题追踪)、Sentry(错误监控)及 Slack/Teams(通知)。
- 结果导向:代理在隔离环境中完成重构、测试生成、依赖升级或 Bug 修复后,自动提交 PR。你只需审查最终结果,无需关注中间过程。
使用方式
- CLI:通过
mistral vibe命令启动,支持本地转云端。 - Le Chat:直接在网页聊天中描述任务,后台调用相同的远程运行时,最终以分支或草稿 PR 形式交付。
核心发布三:Le Chat Work 模式 —— 复杂任务自主执行
Le Chat 新增 Work 模式(预览版),由 Mistral Medium 3.5 驱动,旨在处理研究、分析和跨工具操作等复杂多步骤任务。
功能亮点
- 跨工具工作流:一次性处理邮件、日历、文档。例如,自动收集会议参与者背景、最新新闻,生成谈话要点。
- 深度研究与综合:跨越网络、内部文档和连接工具进行调研,生成结构化报告,支持导出前编辑。
- 智能收件箱管理:分类邮件、起草回复、在 Jira 创建问题、向 Slack 发送团队摘要。
- 透明可控:
- 可见性:实时查看每个工具调用和思考理由。
- 人工审批:在执行发送消息、修改数据等敏感操作前,强制请求用户明确批准。
为什么这很重要?
- 解放开发者时间:将高频、定义明确但耗时的任务(如 CI 调查、模块重构)交给云端代理,开发者专注于高价值判断。
- 打破本地限制:不再受限于本地算力、网络稳定性或电池寿命,实现真正的“设置即忘”(Set and Forget)。
- 企业级安全与合规:所有会话在隔离沙箱中运行,敏感操作需人工审批,确保代码和数据安全。
如何开始?
- Le Chat / Vibe CLI:Pro、Team 和 Enterprise 用户现已可用。
- API:通过 Mistral API 调用 Medium 3.5。
- 自托管:从 Hugging Face 下载开源权重,在本地 GPU 集群部署。
- NVIDIA 生态:可通过 build.nvidia.com 或 NVIDIA NIM 微服务快速原型验证。
© 版权声明
文章版权归作者所有,未经允许请勿转载。