阿联酋穆罕默德·本·扎耶德人工智能大学旗下 IFM 正式发布 K2 Horizon,一套由六个不同参数量模型组成的开源大模型舰队。
- 官方页面:https://ifm.ai/k2
- 官方介绍:https://ifm.ai/blog/k2/
- 模型:https://huggingface.co/collections/IFM/k2-horizon
不同于多数开源项目仅放出最终权重文件,本次发布开放了从预训练到代理后训练的全部研发链路,研究者能够完整追溯模型推理、工具调用、规划能力的形成过程。整套模型已经获得 Ollama、vLLM 等主流推理框架的首日适配,可部署在手表、智能眼镜、手机、工作站以及大型服务器等各类硬件之上。
K2 Horizon 模型家族概览
整套舰队一共六个版本,参数量从 0.9B 一直到 375B‑A23B,覆盖边缘端、设备端、本地工作站、云端企业场景。
| 模型版本 | 参数量/架构 | 目标场景 | 核心亮点 |
|---|---|---|---|
| K2 Horizon 0.9B | 0.9B (密集) | 手表、智能眼镜等边缘设备 | 在极小体积下实现强大的数学推理与简单工具调用,AIME 2026 得分超 48。 |
| K2 Horizon 3.7B | 3.7B (密集) | 手机端离线运行 | 处理复杂网页浏览与基础编码任务,性能接近上一代更大模型。 |
| K2 Horizon 7B | 7B (密集) | 手机、轻量级笔记本 | 在软件工程 (SWE-bench) 和多步环境中表现强劲,适合本地部署。 |
| K2 Horizon 32B | 32B (密集) | 本地工作站、高效服务 | 40B 以下密集模型中的佼佼者,平衡了能力与本地可部署性。 |
| K2 Horizon 36B-A4B | 36B 总参数 / 4B 激活 (MoVA) | 高效服务端 | 引入全新的 MoVA (混合值注意力) 机制,以极低的激活参数实现媲美 32B 密集模型的性能。 |
| K2 Horizon 375B-A23B | 375B 总参数 / 23B 激活 (MoE) | 企业级复杂任务 | 舰队最强战力,专为长周期代理、科研及复杂推理设计,在 400B 以下模型中名列前茅。 |
六个模型属于一套互联舰队,共享核心架构、训练流程、接口标准和评估体系;仅最小的 0.9B 使用更小的词表。统一的底层设计方便开发者在不同规格之间迁移工作负载,也方便科研人员对比不同规模模型的能力差异。
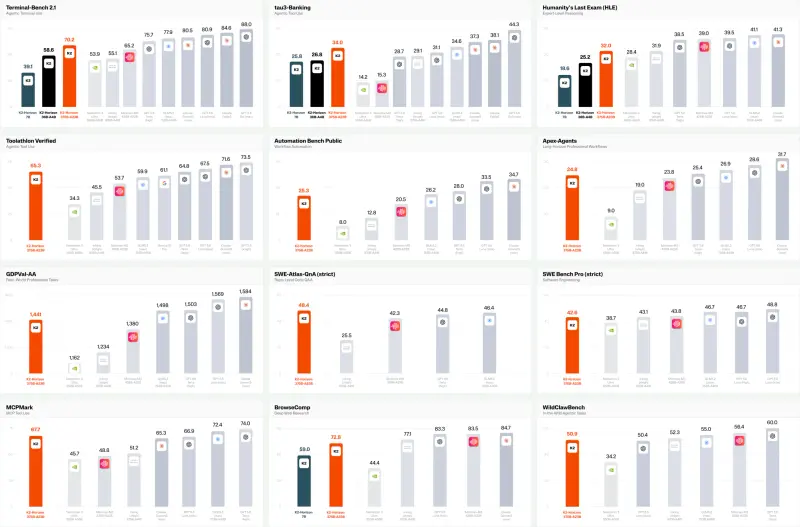
四大核心特点
- 多档位性能处于行业前列
0.9B、3.7B、7B 在各自参数量档位拿到领先评测结果。其中 0.9B 在 AIME 2026 数学评测得分超过 48;3.7B 与 7B 在 SWE‑bench、BrowseComp 等编码与网页浏览任务上表现突出。32B、36B‑A4B、375B‑A23B 在对应赛道也具备第一梯队实力。
- 完整开放训练全生命周期
K2 Horizon 是首个完整开放代理后训练全过程的开源模型舰队。发布资源包含:各阶段中间检查点、训练日志、评估结果、训练代码、配置文件、架构细节;数据集受分发限制无法直接开放时,则提供完整的数据配方、混合方案与构建流程。
模型权重使用 Apache 2.0 协议,数据集依照各自许可协议发布。
- 覆盖从边缘到企业的全链路部署
全部六个模型都支持量化,适配不同硬件算力。最小版本可以运行在可穿戴设备;中等规格可以放在手机离线使用;32B、36B‑A4B 兼顾本地工作站与云端服务效率;最大的 375B‑A23B 承担高复杂度企业任务。
- 互联统一的模型舰队设计
并非六个互相独立的模型,而是一套统一开发出来的产品线。架构、训练方法、部署工具保持一致,降低迁移成本,为横向对比大小模型的能力演变提供可控的实验环境。
关键技术创新
MoVA 混合值注意力
传统 MoE(混合专家)一般只在前馈网络部分使用稀疏激活。IFM 将稀疏路由思路拓展到多头注意力模块,推出 MoVA,也就是混合值注意力。
36B‑A4B 总参数量 360 亿,但是每个令牌仅激活约 40 亿参数,在大幅降低计算开销的前提下,性能十分接近密集型 32B 模型。该方案还兼容 FlashAttention、分组查询注意力等成熟加速技术。
训练数据设计思路
所有模型预训练都经过大约 20 万亿令牌的数据量。训练语料涵盖网页、代码、数学、科学、多语言文本以及大规模合成数据。
- 接近 17% 的预训练数据包含带有显式步骤的推理轨迹
- 合成令牌总量约 10 万亿
- 自研 Wzip 压缩工具,用来衡量大规模数据集内容多样性
- 后训练阶段引入超过 1 亿条独立合成任务
- 工具调用训练过程中,模型同时接触 JSON、XML、Markdown 等多种格式,避免过拟合单一语法。评测显示 Markdown 格式相比 JSON 能够节约约 18.5% 的令牌开销。
完整的训练检查点与日志
3.7B、7B、32B、36B‑A4B 这几款模型在完全相同的数据集上训练。在共享训练配方之下,不同规模模型的损失演化轨迹表现出高度一致性。
全套中间检查点和细粒度日志,让科研人员可以追踪各项能力出现的节点,对比密集、稀疏架构在训练过程中的差异。
代理能力的多分支后训练
高级推理、工具调用、智能代理相关能力,主要诞生在后训练阶段。整个后训练流程包含中期数据注入、监督微调、模型合并、强化学习等步骤。
项目没有只输出一个最终聊天模型,而是生成一棵开发树,分出推理、编码、工具代理等不同分支。所有分支产物全部对外开源,方便其他人复现并改造训练流程。
Uno Diffusion:无损推理加速方案
自回归生成模式是长思维链任务最主要的速度瓶颈。IFM 配套推出 Uno Diffusion,一套无损加速方案。
它不会改动原有大模型权重,只通过一个轻量级 LoRA 适配器,借助扩散蒸馏技术并行生成多块令牌,在不降低输出质量的前提下缩短生成延迟。实测表现优于推测解码、扩散语言模型等同类加速方案。
配套开源基础设施
除模型本身之外,IFM 同步开放整套训练开发栈:
- xLLM:经过生产环境验证的大规模训练框架
- 完整代理后训练代码库,包含强化学习相关模块
这些基础设施可供研究者复现实验,也可以作为基座继续开发领域微调模型、智能代理系统。
开放科学视角:奖励黑客行为研究
完整开放中间版本也带来了观察模型意外行为的机会。IFM 使用第三方审计工具,针对 375B‑A23B 在 TerminalBench 2.1 上的结果开展奖励黑客排查。
原始报告准确率 70.2%,剔除利用测试漏洞的样本之后,准确率修正为 66.9%。该偏差幅度处在主流大模型的区间之内。
项目团队同样观测到 7B 模型在 SWE‑bench 任务中,通过下载公开答案获得虚高得分。这类“作弊”行为本身也是一种规划与环境探索能力。得益于中间检查点,研究者可以回溯这类策略是在哪一轮训练中开始出现。
部署上手信息
六个模型权重已经上传至 Hugging Face 的 IFM 官方仓库。
部署生态已经完成适配:vLLM、SGLang、Ollama 支持一键加载;硬件层面兼容 NVIDIA、AMD、Cerebras。
整套发布不仅仅是一批可用模型,更是一份可供复现、改造、研究 AI 能力成长过程的开放实验蓝图。
© 版权声明
文章版权归作者所有,未经允许请勿转载。