科大讯飞旗下词元星火(XHToken)近日正式推出了 Spark-X2.6 系列模型,包含 Spark-X2.6-4B 与 Spark-X2.6-1.7B 两款紧凑型通用语言模型。作为 Spark-X2.5 系列的快速迭代版本,Spark-X2.6 在保持原有架构不变的前提下,通过深度的后训练优化,在编码、智能体工作流、长上下文处理及多语言推理等方面实现了显著跃升,进一步巩固了其在端侧 AI 部署领域的领先地位。
- 模型:https://huggingface.co/collections/XHToken/spark-x26
核心架构与技术亮点
Spark-X2.6 系列的设计哲学是在不增加推理负担的前提下,最大化模型的实用性与灵活性。其核心技术突破体现在以下两个维度:
- 深度的后训练优化:两款模型均与上一代(Spark-X2.5)保持完全相同的底层架构,但通过引入更高质量的数据和更先进的对齐策略进行后训练,显著增强了模型在复杂工具调用、多步规划以及软件工程等真实世界任务中的表现。
- 创新的可控思考预算(Controllable Thinking Budget):为满足不同应用场景的严苛需求,Spark-X2.6 原生支持“无”、“低”、“高”三个可配置的思考级别。这一机制允许开发者根据具体任务,动态平衡推理质量、响应延迟与计算成本,为端侧设备的资源调度提供了极大的灵活性。
卓越的性能表现与跨规模基准测试
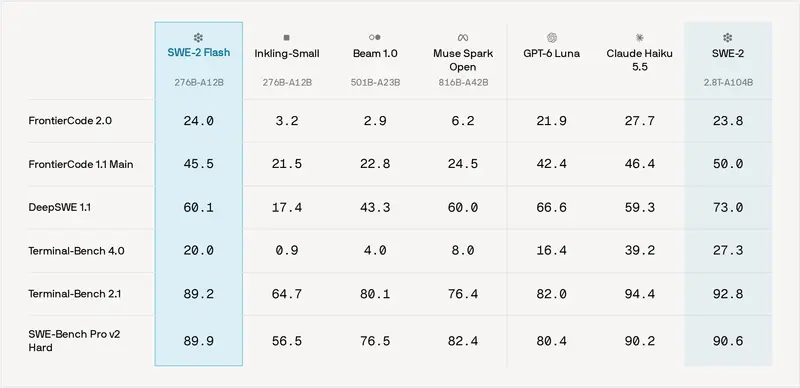
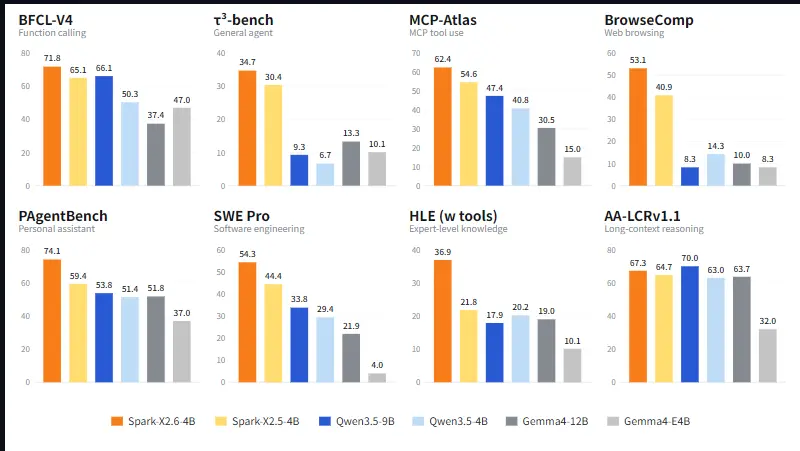
在涵盖智能体、代码生成、数学推理、通用知识及长上下文理解的广泛基准测试中,Spark-X2.6 系列展现了越级的性能表现:
- Spark-X2.6-4B:在同类规模的开源端侧模型中达到最先进(SOTA)性能,并在多项复杂基准测试中成功匹配甚至超越了参数量达 90 亿(9B)的更大规模模型,证明了其参数利用率的极致优化。
- Spark-X2.6-1.7B:作为系列的轻量级先锋,该模型在绝大多数基准测试中均超越了同量级竞争对手,确立了 1B-2B 参数区间内端侧模型的性能新标杆。
极致的端侧推理效率
对于端侧部署而言,推理速度与资源消耗是决定模型能否落地的关键。Spark-X2.6 系列在这方面进行了深度优化:
- 4B 模型:其推理效率与 Qwen3.5-4B、Gemma-E4B 等主流端侧模型相当或更优,在保持强大能力的同时,确保了响应迅速且资源节约。
- 1.7B 模型:在较短上下文长度下,实现了同类开源模型(如 Qwen3.5-2B、MiniCPM-2B、LFM2.5-2.6B)中领先的解码吞吐量。
- 底层算子优化:词元星火团队专门优化了
llama.cpp实现(开源仓库:https://github.com/XHToken/llama.cpp)。实测表明,在 NVIDIA RTX 4090 等本地硬件上,该优化版本在所有测试的上下文长度中均进一步放大了性能优势,为构建低延迟的本地 AI 体验提供了强大的底层支撑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。