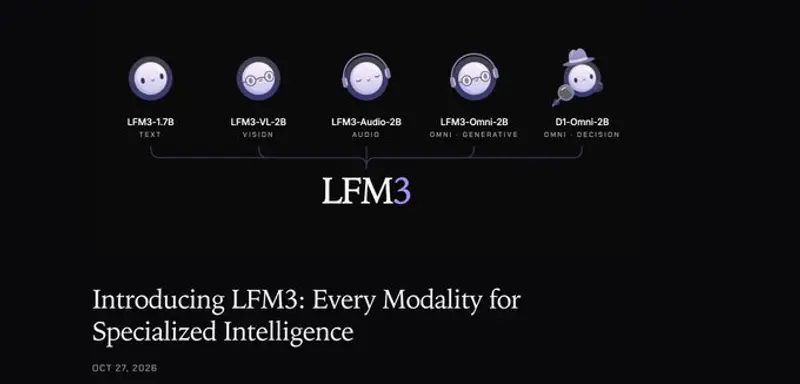
Liquid AI 正式发布新一代基础模型 LFM3,整套家族共用同一个 LFM3-1.7B-Base 骨干,全部为 2B 级别开放权重模型,包含文本、视觉、音频、全模态、两款决策模型,主打本地可微调、边缘设备部署、面向垂直专业化智能体。现已上架 Hugging Face、官方 Playground 与 Liquid AI API。
- 官方介绍:https://www.liquid.ai/blog/lfm3
- 模型:https://huggingface.co/collections/LiquidAI/lfm3
核心架构突破:三混合设计与极致边缘优化
LFM3 在保持高效推理的同时,实现了表达能力的显著飞跃。其核心技术亮点包括:
- 创新的三混合架构:在 24 层网络中,结合了 13 层门控短卷积(卷积核大小提升至 7)、5 层滑动窗口注意力(SWA,窗口 256 token)和 6 层全局注意力。这种设计在长上下文推理中实现了最佳的质量与速度权衡。
- 逐头门控与部分 RoPE:引入 Sigmoid 门控缩放每个注意力头的输出,有效抑制量化异常值并提升训练稳定性;全局注意力层采用部分旋转位置编码(RoPE),进一步优化了远距离内容匹配。
- 海量高质量预训练:LFM3-1.7B-Base 在高达 22 万亿 token 上进行预训练,并包含 3.5 万亿 token 的精选中期训练阶段,大幅增加了科学论文、仓库级代码、数学及智能体轨迹数据,将上下文窗口扩展至 256K token。
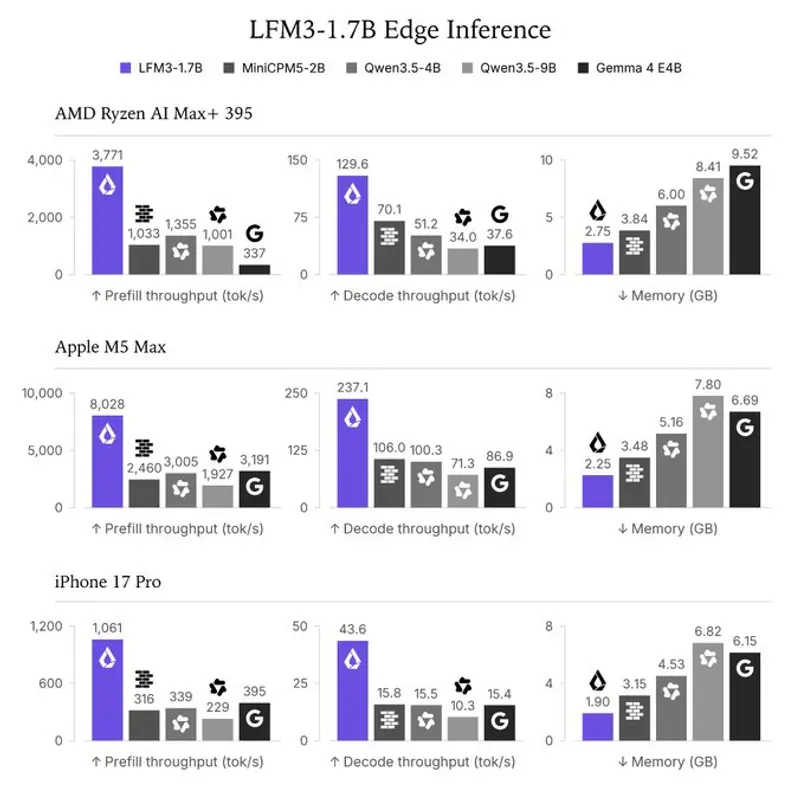
- 极致的端侧效率:文本模型在 4 位精度下仅占用约 1GB 内存。在边缘设备上,其解码速度比同类模型快 1.8 至 2.8 倍,且 128K token 的 KV 缓存仅需 1.6GB,远低于竞品。
全面覆盖的多模态模型家族
LFM3 首个版本包含六个从同一 1.7B Base 骨干分支而来的模型,用户可根据具体用例按需选择,无需部署臃肿的通用大模型:
- 文本模型 (LFM3-1.7B):专为本地智能体设计,支持 256K 上下文。在 BFCL、ToolSandbox 等智能体基准上领先,并在长任务中击败更大规模的模型(如 Qwen3.5-9B)。
- 视觉模型 (LFM3-VL-2B):支持视频理解、逐步推理与空间具身推理。配备全新的自研高效视觉编码器(计算量减少 3 倍),在 62 个视觉基准上显著领先同类模型,性能媲美大 6 倍的 Gemma 4 12B。
- 音频模型 (LFM3-Audio-2B):支持 18 种语言的语音转录、合成与翻译。全新的因果音频编码器使首 token 延迟低至 50 毫秒,支持流畅的实时语音聊天与工具调用。
- 全模态模型 (LFM3-Omni-2B):集看、听、说于一体,支持口头视觉问答、视听视频理解及多模态工具调用,为资源受限环境下的对话助手提供强大支持。
- 决策模型 (d1-2B & d1-Omni-2B):专为毫秒级结构化决策而生。支持“指向(画框)”、“读取(提取字段)”、“估计(给出范围)”和“选择”等类型化输出。d1-Omni-2B 更进一步,支持直接通过音频输入进行决策路由,在保持高准确率的同时实现端到端的本地化处理。
专业化智能:垂直领域微调的强大潜力
LFM3 的设计哲学是“为专业化而生”。其紧凑的体量使其能够在单块 GPU 上进行高效微调,快速适应特定领域需求:
- 工业缺陷检测:通过仅约 3,000 张图像和数小时的单卡 A100 微调,LFM3-VL-2B 在风力涡轮机叶片缺陷检测任务中,将分类准确率从不足 10% 提升至 67%,检测 F1 分数大幅提升,表现远超未微调的更大规模模型。
- 机器人控制:LFM3-VL-2B 可被微调为强大的机器人基础模型。在视觉语言导航任务中,它在未见场景中实现了 53% 的 R2R 成功率,并在 Jetson AGX Orin 上以超过 2.5 Hz 的频率实时更新轨迹;在视觉-语言-动作(VLA)操作中,其在 LIBERO 套件上的平均成功率高达 96.2%,且单次动作块生成延迟仅为 50 毫秒。
开放生态与无缝部署
LFM3 坚持开放权重策略,所有基础模型和后训练模型均可在 Hugging Face 免费下载。模型原生支持 llama.cpp、MLX 和 vLLM,并已通过广泛的硬件在环测试,完美适配 Apple Silicon、AMD、NVIDIA、高通 Hexagon NPU 以及 Arm/x86 云 CPU。此外,Liquid AI 还推出了实时推理管道(RIPL),确保模型在高并发负载下仍能保持稳定的低延迟(P95)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。