大语言模型(LLM)通常被视为 GPU 的专属领地,但在分类、意图识别、安全过滤等日常任务中,我们更需要的是轻量、快速且能处理长文本的“编码器”。
Liquid AI 最新发布的 LFM2.5-Encoder-230M 和 LFM2.5-Encoder-350M 正是为此而来。这两款基于 LFM2 混合架构的双向编码器,不仅支持高达 8,192 个 token 的上下文长度,更关键的是,它们在纯 CPU 环境下依然能保持极高的推理速度。
- LFM2.5-Encoder-230M:https://huggingface.co/LiquidAI/LFM2.5-Encoder-230M
- LFM2.5-Encoder-350M:https://huggingface.co/LiquidAI/LFM2.5-Encoder-350M
为什么我们需要通用编码器?
在 BERT 时代,编码器确立了处理分类、命名实体识别等任务的标准。随后的 ModernBERT 进一步提升了速度和上下文长度。然而,随着应用场景的复杂化,输入文本越来越长(如法律合同、医疗记录),传统编码器在处理长序列时,计算成本会急剧上升。
Liquid AI 认为,LFM2 架构的优势在于其计算成本随输入长度增长的速度更慢。这意味着,即使在没有 GPU 的边缘设备或本地服务器上,也能高效地处理文档级的工作负载。
与上个月发布的专为检索设计的 LFM2.5-Retrievers 不同,这次的 Encoders 是基于掩码语言建模(MLM)目标预训练的通用模型。它们不仅能做检索,更能适应分类、Token 级任务等多种下游场景,提供了更广泛的灵活性。
架构创新:从因果到双向
LFM2.5-Encoders 并非从零开始,而是基于 LFM2.5-230M 和 350M 因果解码器进行适配:
- 双向注意力掩码:将原有的因果掩码替换为双向掩码,让每个 Token 都能同时关注左右两侧的上下文。
- 非因果短卷积:通过对称中心填充,使 LFM2 的短卷积能够混合每个 Token 周围的局部信息,而非仅依赖之前的 Token。
- 高密度掩码训练:采用 30% 的 Token 掩码率(高于 BERT 的 15%),这在当前规模下被证明能带来更好的学习效果。
训练过程分为两个阶段:先在 1,024 Token 的短上下文上建立通用语言能力,再扩展到 8,192 Token 的长上下文,以增强其在事实性、法律和多语言任务上的表现。
性能表现:CPU 上的速度优势
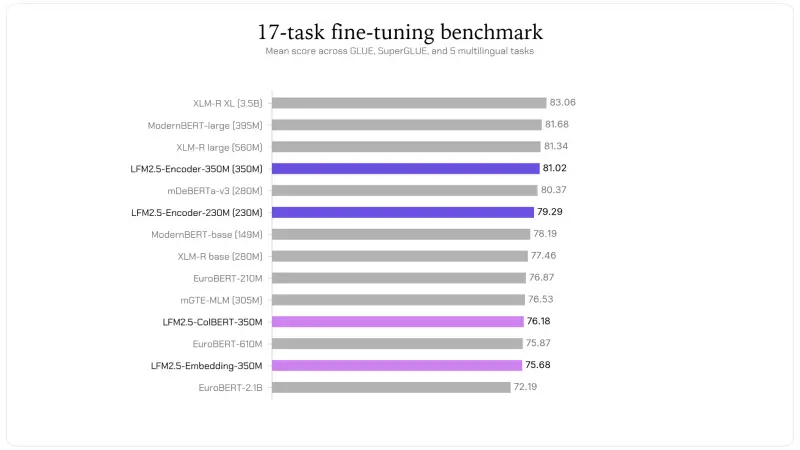
基准测试显示,LFM2.5-Encoder-350M 在 14 个模型的对比中排名第四,仅次于三个更大的模型;而 230M 版本则击败了 ModernBERT-base 和各类 EuroBERT 模型。
但在推理速度上,LFM2.5 的优势尤为明显,尤其是在 CPU 环境中:
- 长文本处理能力:在 8,192 Token 的长度下,ModernBERT-base 完成一次前向传播需要超过 90 秒,而 LFM2.5-Encoder-230M 仅需约 28 秒,速度快了 3.7 倍。
- 稳定性:随着输入长度增加,ModernBERT 的吞吐量急剧下降,而 LFM2.5 的性能衰减更为平缓,在中长文本区间始终保持领先。
即使在 GPU 上,LFM2.5 在处理 2K Token 以上的长文本时也表现出更强的竞争力。
实际应用场景
这种“长上下文 + CPU 友好”的特性,使得 LFM2.5-Encoders 在以下场景中极具价值:
- 边缘与嵌入式设备:在汽车车载计算、工业控制器等资源受限的设备上,无需云端往返即可在本地 CPU 上完成意图路由和内容过滤。
- 受监管的本地部署:在金融、医疗和法律领域,敏感文档(如 13-15 页的合同)不能离开内部基础设施。LFM2.5 可以在本地 CPU 上一次性完成整个文档的分类或字段提取,确保数据隐私。
- 高吞吐量预处理管道:作为大型模型前的“守门员”,廉价地在 CPU 上对海量请求进行初步过滤和分类,从而大幅降低整体算力成本。
如何开始?
两款模型均已开放权重,可在 Hugging Face 上免费下载、微调和部署。
- LFM2.5-Encoder-350M:适合对准确性要求更高的场景。
- LFM2.5-Encoder-230M:适合硬件资源紧张或对吞吐量有极致要求的场景。
Liquid AI 还开源了完整的评估工具和微调教程,并提供了零样本提示路由、策略检查、PII 检测等多个演示,所有演示均在纯 CPU 的 Hugging Face Space 上运行,你可以直接体验其在长文本处理上的流畅度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。