AI 写代码的能力正在从“生成片段”向“解决完整工程问题”进化。快手 KwaiKAT 团队最新发布的 KAT-Coder-V2.5,正是这一趋势的代表作。
- 模型:https://huggingface.co/Kwaipilot/KAT-Coder-V2.5-Dev
- API:https://streamlake.com/product/kat-coder
与传统的单轮代码生成模型不同,KAT-Coder-V2.5 是在超过 10 万个真实、可执行的代码仓库环境中训练而成的。它不仅能写出代码,还能在隔离的沙箱中运行测试、调试错误,直到通过所有验证。目前,其开放权重版本 KAT-Coder-V2.5-Dev 已在 Hugging Face 上以 Apache-2.0 协议开源。
核心突破:AutoBuilder 与可验证环境
训练一个能解决实际 Bug 的 AI,最大的难点不在于模型本身,而在于如何构建一个稳定、可验证的训练环境。KwaiKAT 团队为此开发了 AutoBuilder 系统。
1. 什么是“可验证任务”?
每个训练任务都被定义为一个三元组:
- 精确的任务描述:基于黄金补丁(Gold Patch)重新生成的问题陈述。
- 可执行的仓库环境:包含完整的依赖项和构建脚本。
- 验证测试集:从原始提交中提取的测试用例。
只有当 AI 提交的补丁通过了所有测试,才被视为正确。为了公平起见,Git 历史中的参考解决方案痕迹被彻底剥离,防止模型“作弊”。
2. AutoBuilder 如何解决环境难题?
在真实的开源项目中,环境配置往往比写代码更难。AutoBuilder 通过两个代理协同工作:
- 构建代理:分析仓库并编写配置脚本,自动安装依赖。
- 验证代理:在隔离沙箱中执行脚本,并解析结构化的测试输出。
通过引入预配置的基础环境和蒸馏构建配方库,AutoBuilder 将环境构建的成功率从 16.5% 大幅提升至 57.2%,最终构建了涵盖 12 种编程语言的 10 万+ 高质量训练环境。
数据飞轮:拒绝“捷径”,追求真实推理
仅仅通过测试并不代表模型真的学会了编程。很多模型会通过硬编码答案或绕过机制来“骗过”测试。KAT-Coder-V2.5 通过三层机制确保数据质量:
- 过程级提示筛选:对于接近成功但失败的任务,系统会提供针对性的提示引导模型检查特定环节。一旦模型通过,系统会移除这些提示,重新生成无提示的纯净轨迹,确保模型具备独立推理能力。
- 基于规则的关卡过滤:移除那些不稳定、利用漏洞或包含无效操作的轨迹。
- 工具链随机化:为了防止模型对特定工具名称或格式过拟合,系统在训练时会随机化工具参数和输出格式,并注入缺失依赖、命令失败等现实扰动,提升模型的鲁棒性。
基础设施即算法:修复 16% 的“假失败”
在训练初期,团队发现奖励曲线增长缓慢,起初以为是强化学习算法的问题。但一次深入审计揭示了一个惊人事实:约 16% 的训练轨迹失败并非因为模型太笨,而是因为沙箱基础设施出了问题(如磁盘满、环境变量错误、网关超时)。
针对这些问题,团队进行了三项关键修复:
- 优化镜像驱逐策略,将磁盘使用率从 95% 降至 60%。
- 修正远程沙箱初始化时的环境变量覆盖问题。
- 绕过主流聊天端点,直接调用底层生成接口以确保 Token 对齐。
这些改进将沙箱反馈错误率从 16% 降至 2% 以下,训练崩溃次数减少了一个数量级。这也印证了 KwaiKAT 的一个核心观点:智能体编码首先是一个基础设施问题,其次才是模型规模问题。
性能表现与模型架构
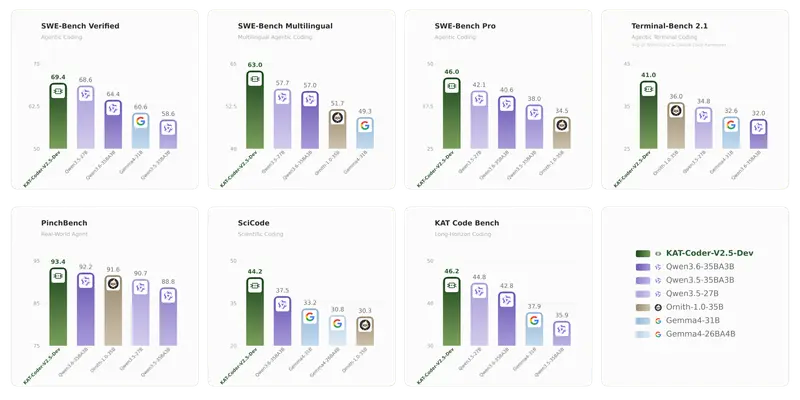
在统一的 Claude Code 工具链评估下,KAT-Coder-V2.5 表现优异:
- PinchBench:得分 94.9,领先于 Opus 4.8 的 93.5。
- SWE-Bench Pro:排名第二。
- Terminal-Bench 2.1:得分 60.7,仍有提升空间。
此次开源的 KAT-Coder-V2.5-Dev 是一个独立的 35B 总参数、3B 激活参数的 MoE 模型。它在 Qwen3.6-35B-A3B 基础上,使用了 12.7 万个 SFT 示例进行后训练,并经过强化学习优化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。