现在大模型效果持续提升,但从零预训练的硬件门槛依旧居高不下。即便是小参数基础模型,往往需要大量专业机房加速卡,单次训练硬件成本几十万甚至上百万元。
对于高校小课题组、独立研究者而言,算力成本是一道高墙。多数团队只能基于公开底座做微调,很难完整从零训练自有基础大模型。不少开源项目只放出权重,不开放完整训练链路;少数公开流程的项目,复现依旧要巨额算力,普通实验室依旧难以落地。
- GitHub:https://github.com/thu-pacman/Puro-Megatron
- 模型:https://huggingface.co/collections/thu-pacman/puro-2b
清华大学推出 PuRo‑2B(普罗‑2B),目标就是打破算力壁垒:基于消费级RTX5090显卡集群完成20亿参数基础大模型从零预训练,完整公开硬件选型、训练算法、数据筛选、全流程训练配方。在远低于传统方案的开销下,模型能力对标主流成熟开源小模型。论文还总结成本‑性能经验缩放规律,给预算有限的科研团队提供可落地实操样板。
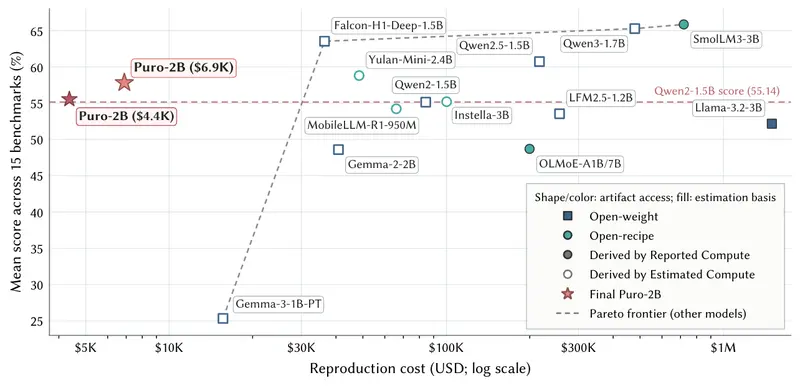
注:论文给出成本仅统计显卡训练等价租赁开销,不含数据处理、人力、硬件采购折旧等其他成本。
主要功能
PuRo‑2B不只是单一模型,是包含多版本权重、代码、数据集清单、完整训练配方的开源项目,核心能力分为五点:
- 消费级显卡从零预训练底座:依靠RTX5090消费卡集群,不需要机房专业加速卡,从零训练20B基础大模型,不依赖第三方预训练底座。
- 多档位模型检查点:低投入版本综合能力超过Qwen2‑1.5B;更高投入版本进一步逼近Qwen2.5‑1.5B。
- 通用文本生成底座:支持通用问答、常识推理、数学解题、代码生成、多语言处理,适合后续开展指令微调与二次开发。
- 完整可复现训练配方:开放训练源码、数据来源、预处理脚本、硬件配置、训练中间快照,外部研究者可以完整复刻从零预训练全流程,不止拿到成品权重。
- 支持预训练机理对照实验:提供两套不同训练策略产出的底座,方便控制变量,研究数据排序、预训练策略对后续微调效果的影响。
主要特点
对比现有开源大模型项目,PuRo‑2B有五个突出亮点:
- 消费级显卡完成完整预训练,大幅降低算力门槛
绝大多数从零预训练的开源模型依赖数据中心专业加速卡;PuRo‑2B采用RTX5090集群。达到对标Qwen2‑1.5B效果等价训练成本不足5090美元;完整版CMA路线等价成本约6900美元,远低于同级别项目百万级别的训练开销。 - 开放完整训练配方,而非仅发布模型权重
很多开源项目只提供最终权重,原始数据、超参、中间过程不对外公开。该项目完整放出数据源、预处理、优化器配置、硬件调优,支持完整复现训练全链路。 - 多技术叠加实现低成本,不存在单点黑科技
低成本来自组合优化:硬件适配、FP8低精度训练、改良优化器、课程式数据排序、数据集筛选、多快照模型平均,多项技术共同提升算力利用率。 - 给出面向预算受限团队的成本‑性能经验规律
通过多档训练预算对照实验,总结经验缩放规律。小团队可以根据自身预算预判模型大致效果,避免算力盲目投入。该规律仅适配本项目2B训练配方,不可直接迁移到更大参数模型。 - 揭示预训练对后续微调的长期影响
项目提供两套不同预训练底座用于对照;实验证实预训练阶段的数据排序带来的能力优势,经过多轮指令微调之后依旧保留,为大模型训练机理研究提供实验素材。
客观局限
- 整套配方针对20亿参数定制,不能直接迁移到大参数模型。
- 中文能力不是本次重点优化方向。
- 部分上游数据集具备独立开源许可,使用需要遵守原始协议。
- 属于2B小底座,复杂推理、超长文本能力存在小模型固有短板。
工作原理
整套方案分为硬件适配、块式FP8训练、MuonH优化器、两阶段预训练、课程式数据处理、代理实验数据集筛选、对照后训练七个部分。
硬件适配改造
消费游戏显卡没有专业卡的高速互联。团队调整底层驱动与服务器配置,改造模型并行拆分策略,规避带宽短板,让多块RTX5090协同训练,最大化硬件利用率。
块式FP8低精度训练
矩阵计算主体使用FP8低精度运算加速;对模型稳定性关键的部分保留高精度。在轻微损失效果的前提下,显著压缩训练耗时,平衡速度与模型质量。
MuonH改良优化器
针对训练中参数矩阵规模失控问题做约束,控制参数更新幅度,提升同等算力下的训练效率,用更少算力取得相近效果。
两阶段预训练流程
- 第一阶段:24张RTX5090,完成基础语言、常识学习。
- 第二阶段:扩至96张显卡继续训练,分为两条路线
- UD路线:全部文本全局随机打乱输入。
- CMA路线(主推版本):同一数据源内部按由低到高质量排序;训练末期不降低学习率;保存多份快照并做参数平均融合得到最终模型。
课程式排序类比人类学习:先普通样本打底,后期高质量样本拔高。
课程式数据处理
不做跨数据源全局质量打分,仅在同一个数据集内部做样本质量排序;不同数据源维持原有内容配比,保证英文、数学、代码、中文占比不偏移。
代理小实验筛选数据集
候选数据集切分小片段,使用小模型做小规模预训练评测,依据实测收益决定数据集取舍与占比,避免无效数据浪费算力。
完整后训练对照实验
UD、CMA两套底座,使用完全一致的微调数据与参数做多组指令微调,观测预训练阶段差异会不会被后续微调抹平,研究预训练的长期影响。
测试结果
基于15套主流评测集开展横向对比与消融实验:
- 综合能力对标成熟开源底座
UD版本(约4400美元)综合得分超过Qwen2‑1.5B;CMA完整版(约6900美元)进一步提升,接近Qwen2.5‑1.5B,同等能力训练成本远低于同类项目。 - 各项优化均带来明确收益
硬件选型带来最大成本收益;FP8显著提速;MuonH节约算力;课程式排序+快照平均带来可观效果提升;整体是多项技术叠加的结果,不存在单一魔法技术。 - 预训练的收益可以穿透指令微调
UD、CMA底座分别做数学、数学+代码、通用多领域三轮指令微调。即便经过大量新数据微调,CMA底座的综合、数学、指令遵循能力依旧稳定占优,预训练的烙印不会被微调完全覆盖。 - 验证成本‑性能缩放规律
同一阶段一底座,设置多档token预算,拟合出经验缩放规律,方便小团队做预算效果预估,仅限本项目2B配方。 - 现存短板
2B底座天然限制复杂难题推理;中文非优化重点;配方不能直接放大到大模型;上游数据集需要遵守版权;RTX5090显存限制更大规模训练。
实际价值
- AI科研普惠:证明基础大模型预训练不再是大厂专属,高校小组、独立研究者也可以开展底座级创新,催生更多开源细分模型。
- 降低垂直小模型开发门槛:行业、企业垂直模型可以基于低成本底座二次迭代,间接降低面向用户的AI产品成本。
- 适配本地隐私部署:20B规模适合本地硬件运行,文档对话无需上传云端,助力隐私化本地AI落地。
© 版权声明
文章版权归作者所有,未经允许请勿转载。