Fastino 正式推出 GLiNER2.5,这是一款旨在缩小传统编码器模型与大型语言模型(LLM)之间差距的信息提取(IE)架构。通过用边界预测(Boundary Prediction)取代传统的跨度枚举(Span Enumeration),GLiNER2.5 移除了实体宽度的计算瓶颈,支持长达 4,096 词的上下文,并实现了联合实体-关系解码及跨任务标签约束。该系列包含三个参数规模(74M、194M、287M)的检查点,均以 Apache 2.0 许可证在 Hugging Face 上开源。
- GitHub:https://github.com/fastino-ai/GLiNER2
- 模型:https://huggingface.co/collections/fastino/gliner25-models
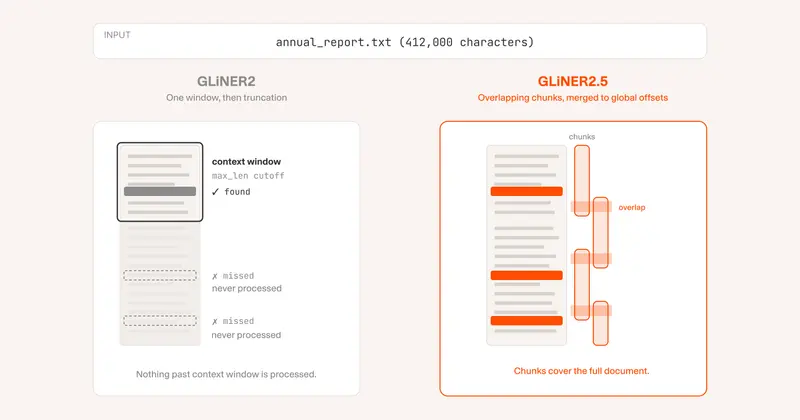
核心架构变革:从枚举到预测
传统的 GLiNER 模型通过对“起始位置 × 允许宽度”的网格进行评分来定位实体,这导致计算量随最大实体宽度增加而膨胀,且对长实体存在硬性上限。
GLiNER2.5 的创新在于:
- 移除枚举:模型不再对每个候选跨度评分,而是直接预测 Token 边界的开始和结束分数,以及 Token 内部的内部分数。
- 稀疏提议与重排序:通过稀疏提议阶段选出最有希望的起止点进行配对,再由重排序头结合边界证据和跨度内容进行最终评分。
- 线性计算复杂度:在固定模式和候选预算下,计算量保持与序列长度呈线性关系,而非受限于宽度轴。
五大关键能力提升
| 能力 | 描述 |
|---|---|
| 长上下文提取 | 支持长达 4,096 词的序列处理。内置原生分块辅助函数(如 extract_entities_long),自动将跨度重新映射回原始文档的字符偏移量。 |
| 无限跨度长度 | 实体长度不再受限。无论是两词的名称还是四十词的法律条款,其定位成本相同,彻底解决了长实体漏检问题。 |
| 联合实体-关系解码 | 支持声明实体类型、关系及结构规则(如 unique_head=True)。通过束搜索组装全局一致的图,确保输出在构造上即符合逻辑约束,无需后处理验证。 |
| 约束分类 | 引入 C.implies 和 C.excludes 规则,在解码期间绑定跨任务标签。例如,防止一个提示词同时被标记为“安全”和“注入”,若无法找到有效分配则抛出错误。 |
| 跨度属性 | 支持为特定实体类型附加属性组(如情感、剂量等),并在同一次前向传播中逐跨度解码,返回带有修饰信息的结构化实体而非扁平文本。 |
模型家族与性能表现
GLiNER2.5 提供了三个不同规模的检查点,均基于 DeBERTa-v3 架构,可在 CPU 上高效运行。
| 模型 | 参数量 | 编码器 | 语言支持 | 适用场景 |
|---|---|---|---|---|
| gliner2.5-small-v1 | 74M | DeBERTa-v3-xsmall | 英语 | 轻量级部署,低资源环境 |
| gliner2.5-base-v1 | 194M | DeBERTa-v3-base | 英语 | 平衡性能与速度,通用提取 |
| gliner2.5-multi-v1 | 287M | mDeBERTa-v3-base | 多语言 | 跨国业务,多语言文档处理 |
基准测试亮点(零样本评估):
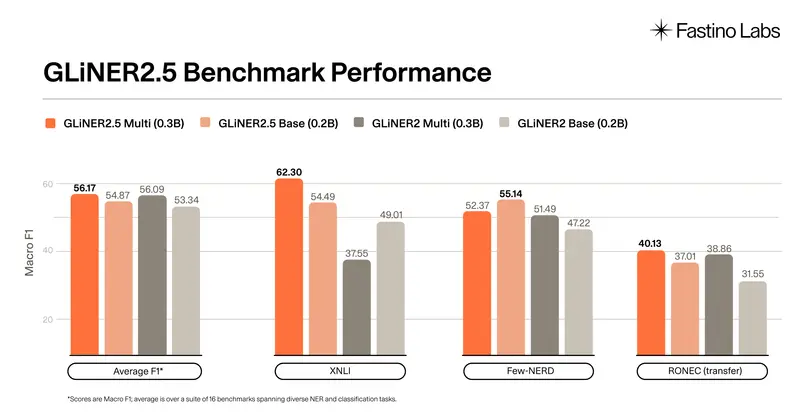
- 整体宏 F1:Multi 版本达到 56.17(GLiNER2 为 56.09),Base 版本达到 54.87(GLiNER2 为 53.34)。
- 显著跃升:在 XNLI 数据集上,Multi 版本得分从 37.55 飙升至 62.30(+24.75 分);在 Few-NERD 上,Base 版本从 47.22 提升至 55.14。
- 泛化能力:即使在未经训练的罗马尼亚语(RONEC)数据集中,性能亦有提升。
部署与应用
- 安装:
pip install "gliner2[local]"(需 Python 3.10+)。 - 推理:支持 CPU、CUDA 和 MPS。由于暂无托管服务,自托管是主要部署路径。
- API 变更:使用
AutoExtractor加载模型,替代旧版的GLiNER2跨度加载器。
典型应用场景:
- 法律与合规:合同条款提取、PII 检测与编辑。
- 医疗健康:临床文档中的实体提取(含否定与剂量属性)。
- 金融与保险:理赔单据结构化、风险条款识别。
- AI 安全:作为护栏模型,检测提示注入或敏感内容。
© 版权声明
文章版权归作者所有,未经允许请勿转载。