阶跃(StepFun)正式放出 Step5 Preview 模型权重,同步开放BF16、FP8两种精度权重、技术博客以及配套开源开发工具,权重托管在Hugging Face与ModelScope魔搭社区。
- Hugging Face:https://huggingface.co/collections/stepfun-ai/step-5-preview
- ModelScope:https://modelscope.ai/models/stepfun-ai/Step-5-Preview
该模型面向长程Agent任务打造,采用稀疏MoE架构,总参数量600B,每token仅激活27B参数,支持最高100万token上下文窗口,原生支持文本+视觉输入,在代码工程、专业资料分析、金融场景表现突出,此前在OpenRouter调用榜单达到全球第二。
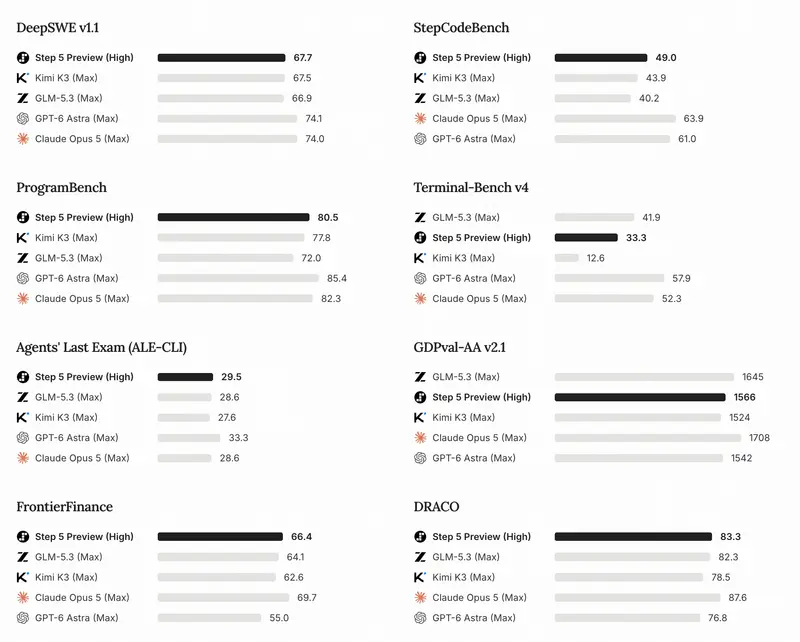
模型架构与核心技术设计
- 92层窄深架构:构建更深的计算路径,支撑隐式多跳推理,同时控制整体参数量与推理成本
- Sparse GQA:块级索引稀疏计算,8 token块索引将索引与top-k选择开销压缩至原先1/8,大幅降低百万上下文成本
- 稳定训练方案:关键参数保留FP32精度,搭配细粒度梯度裁剪,抑制深层网络梯度尖峰、激活值异常膨胀
- 百万级验证评测集:覆盖软件工程、科学推理、机器学习研发、专业知识场景,持续校准难度与评估可靠性
- 面向长轨迹Agent强化学习:把上下文压缩纳入端到端策略训练,让智能体自主整理任务状态、持续推进任务;精细化奖励归因提升长任务学习效果
核心能力
- 软件工程:仓库级代码理解、跨文件修改、前端/设备编程,可浏览大型代码库、执行验证并迭代代码
- 长视野Agent执行:支持多轮工具调用、循环验证修订,在超长上下文内维持任务状态,持续执行复杂工作流
- 专业知识工作:多模态长文档、图表、截图、视频综合分析,输出结构化报告
- 金融场景:擅长定量推理、金融长文档与数据综合分析
模型规格
| 项目 | Step 5 Preview |
|---|---|
| 架构 | 稀疏MoE混合专家 |
| 总参数量 | 600B |
| 单Token激活参数 | 27B |
| 上下文窗口 | 最高100万token |
| 最大输出 | 最高100万token |
| 输入 | 文本、图像 |
| 输出 | 文本 |
部署方案
支持vLLM、SGLang部署OpenAI兼容API服务,也可使用Transformers离线推理,适配B300、H200等多GPU集群,支持张量并行、专家并行、数据并行等多种并行策略。FP8精度可降低显存门槛,BF16保留更高精度。
| 框架 | 精度 | 硬件 | 并行方案 | 接口 |
|---|---|---|---|---|
| vLLM | FP8 | B300单节点4卡 | TP4/TEP4/DEP4 | OpenAI兼容API |
| vLLM | FP8 | H200单节点8卡 | TP8/TEP8/DEP8 | OpenAI兼容API |
| vLLM | BF16 | B300单节点8卡 | TP8/TEP8/DEP8 | OpenAI兼容API |
| vLLM | BF16 | H200双节点16卡 | TP16/TEP16/DEP16 | OpenAI兼容API |
| Transformers | FP8 | H200单节点8卡 | TP8/EP8 | 离线生成 |
| Transformers | BF16 | H200双节点16卡 | TP16/EP16 | 离线生成 |
| SGLang | FP8 | B300单节点4卡 | TP4/EP4 | OpenAI兼容API |
| SGLang | FP8 | H200单节点8卡 | TP8/EP8 | OpenAI兼容API |
推荐推理参数:temperature=1.0、top_p=0.95、top_k=0。
要点小结
- 阶跃Step5 Preview权重正式发布,BF16/FP8权重开源,魔搭与HF可获取,配套技术文档与开发工具。
- 600B稀疏MoE,激活仅27B,百万token上下文,文本图像多模态输入,主打长程Agent、代码、金融、专业文档分析。
- vLLM/SGLang可快速部署兼容OpenAI协议API,Transformers支持离线本地推理,需要多卡高端GPU集群。
© 版权声明
文章版权归作者所有,未经允许请勿转载。