上海Endless Frontier科技发布BigBang-v1,一款基于Qwen3.6-35B-A3B构建的35B总参数、3B激活参数的MoE代理模型。通过对抗性自我演进合成数据框架(生成器+评判器代理迭代产出约1万条高难度样本)进行后训练,在长时程搜索、编码、科学研究及AI研究八大基准上取得35B级模型最高分,并在FrontierScience Research、Humanity’s Last Exam、PaperBench(Code-Dev)、BioMysteryBench-HD四项任务中超越DeepSeek V4 Pro Preview(1.6T)。团队同步开源轻量级通用代理harness(含search/visit/code_exec工具)及SWE-Bench Pro、SciCode-Verified数据集下载支持。
- GitHub:https://github.com/endless-frontier/BigBang-v1
- 模型:https://huggingface.co/endless-frontier/BigBang-v1
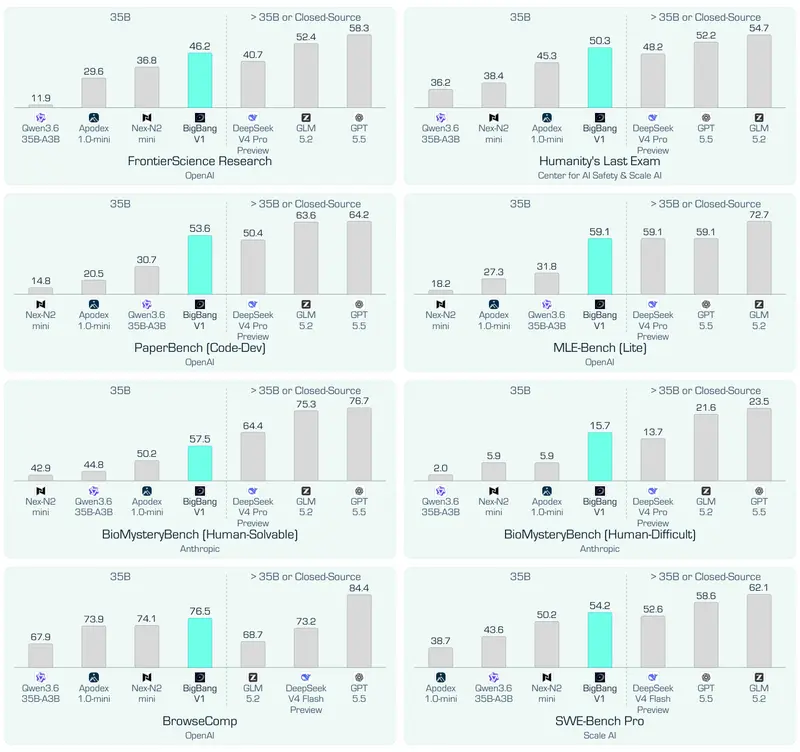
核心创新:可验证前沿任务的自我演进合成
BigBang-v1的训练范式突破了传统人类标注数据的天花板:
双代理对抗演进框架
- 生成器代理:持续提出并解决日益复杂的科学/技术问题,确保任务处于知识边界
- 评判器代理:从正确性、难度、可扩展性、多样性四维度评估生成样本,并用真实研究任务校准合成分布
- 迭代闭环:两代理交互产生约10,000条跨领域高难度后训练示例,规模小但信息密度极高
设计哲学
- 可验证性优先:所有合成任务均可通过形式化方法、计算模拟或领域工具客观评估,避免主观判断噪声
- 前沿导向:聚焦“当前知识边界”问题,而非重复已掌握能力
- 效率至上:3B激活参数实现接近284B–1.6T模型的性能,证明数据质量比参数规模更重要
基准表现:35B级全面领先,部分超越1.6T
| 基准类别 | 关键成果 | 对比亮点 |
|---|---|---|
| 长时程搜索 | BrowseComp 76.5 / XBench 58.4 | 35B模型最高;BrowseComp超DeepSeek V4 Pro (83.4) 差距缩小至6.9分 |
| 编码任务 | SWE-Bench Pro 54.2 / SciCode-V-Sub 68.6 | 35B最优;SWE-Bench Pro持平Gemini 3.1 Pro,SciCode-V-Sub超GLM 5.2 (84.3) 差距15.7分 |
| 科学研究 | FS-R 46.2 / HLE 50.3 / BioMystery-HD 15.7 | FS-R/HLE/BioMystery-HD三项超DeepSeek V4 Pro Preview;BioMystery-HD达15.7 vs V4 Pro 13.7 |
| AI研究 | MLE-Bench(Lite) 59.1 | 35B最高;持平DeepSeek V4 Pro/GPT 5.5,远超基础模型Qwen3.6 (31.8) |
关键观察
- 全面压制同量级:在所有8个基准上均获35B模型最高分,显著优于Qwen3.6基座、Nex-N2 mini、Agents A1等
- 越级挑战成功:在4项高难度科研/AI研究任务上超越1.6T参数的DeepSeek V4 Pro Preview,验证合成数据对前沿能力的放大效应
- 短板仍存:PaperBench(Code-Dev)未公布分数;SciCode-V-Main (50.0) 与Agents A1持平,落后GPT 5.5 (90.6) 40.6分,显示复杂代码开发仍有差距
© 版权声明
文章版权归作者所有,未经允许请勿转载。