Meta超级智能实验室又放出开放权重新模型 Muse Glimmer,采用宽松的 Apache 2.0 协议开源权重。同时官方预告,未来几周,旗下最强模型 Muse Spark 1.2 也会放出开放权重版本。
- 官方介绍:https://research.meta.ai/blog/introducing-muse-glimmer-open-agentic-model
- 模型:https://huggingface.co/meta-models/Muse-Glimmer-30B
Muse Glimmer 定位是可以跑在个人设备上的开放代理模型,参数规模300亿,经过专门优化面向常驻本地代理工作流。硬件门槛控制得很友好,普通消费级GPU的Mac、PC就可以完成部署。
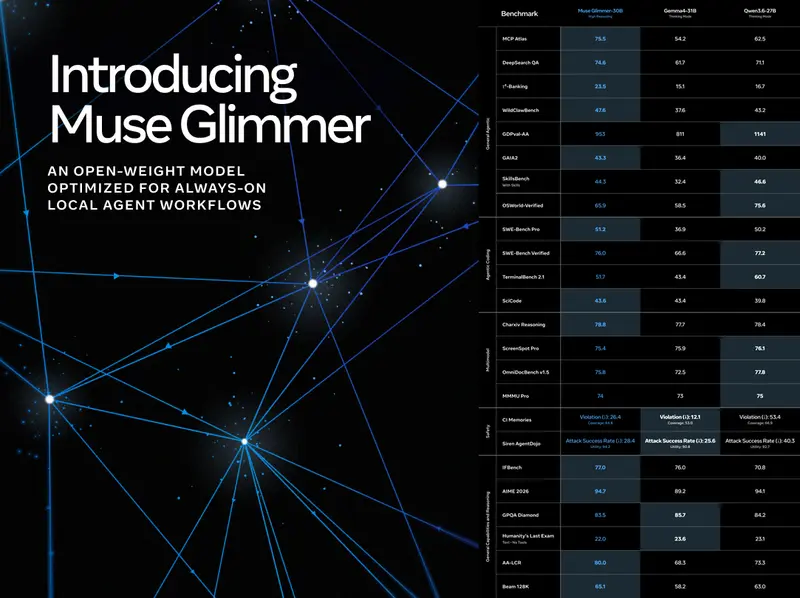
本地代理、函数调用、代码编写、LLM‑as‑a‑judge评估,这些场景它都可以胜任,在代理相关基准测试对比同级别竞品模型有着不错表现。
现在很多AI代理方案高度依赖云端、网络环境。而本地运行模型最大的价值,就是断网状态也可以正常使用AI能力。开源社区已经证明,经过高质量训练的中等规模模型,在专项任务上可以逼近前沿大模型效果,Muse Glimmer正是顺着这一思路做端侧场景优化。
目前模型权重已经上架 Hugging Face,配套开发者文档同步放出。后续几天内,llama.cpp、MLX、ExecuTorch 都会完成适配优化,开发者可以快速完成下载、部署,搭建属于自己的本地AI代理。
Muse Glimmer 的训练思路
想要做真正可用的本地代理,模型要处理日程管理、文件整理、消息撰写这类任务,需要访问大量个人上下文,同时兼顾长时序执行、精准工具调用、多模态理解、长记忆、指令遵循等多项能力。
Meta在模型能力和消费设备内存、算力之间做取舍,依靠紧凑架构、创新蒸馏方案、量化推理优化,来满足本地设备的延迟要求。整个训练分为三个阶段:
- 预训练:基于Muse Spark教师模型输出做logit蒸馏,复用相似的数据混合;
- 中期训练:扩充长上下文样本、代理推理轨迹数据以及真实有机数据继续训练;
- 后训练:监督微调结合策略内蒸馏与强化学习,覆盖通用、推理、编码、代理各类场景。
模型完成全套评估,满足开放权重对外发布标准。
面向代理场景,核心能力一览
一个合格自主代理,需要多项能力协同完成用户目标,Muse Glimmer针对这些方向做训练与评测:
- 端到端代理任务完成:在 DeepSearch QA、MCP‑Atlas、τ‑Bench、SWE‑Bench 等基准拿到高成功率,可完成框架调用、代码编写调试、多轮复杂请求。
- 可靠工具调用:支持大量函数调用场景,在长链路流程中输出规范的调用格式。
- 多步长链条推理:可以在复杂长流程中维持完整计划,链式完成多轮推理。
- 故障自愈:工具调用出错、返回异常结果时,会主动诊断问题重新尝试,而不是直接终止流程。
- 多模态输入:内置感知编码器,支持文本+图像交错输入,能够解读截图、图表、文档内容。
- 代理框架友好,原生适配 OpenClaw 等主流代理编排方案。
- 推理强度可控,可以按需调节,平衡输出质量和生成速度。
- 多语言能力,训练数据覆盖超过100种语言。
在基准测试中,和 Gemma4‑31B、Qwen3.6‑27B 等同级别模型横向对比,Muse Glimmer在同尺寸梯队表现亮眼。
专为本地硬件做的两大核心优化
本地代理想要好用,响应速度是关键,如果生成回复等待时间过长,会直接打断工作流。Meta做了两套关键优化,在不明显损失效果的前提下,适配消费级硬件。
第一是量化压缩。30B全精度版本内存占用超过55GB,远超普通消费显卡。通过4位量化,模型体积压缩至20GB以内,给KV缓存、图像编码器、推测解码辅助模型留出内存空间,可以在24GB‑32GB显存设备完整跑通。官方验证,该压缩方式对代理任务性能几乎没有损耗。
第二是推测解码加速。传统大模型逐Token生成,长推理、多轮工具调用场景速度慢。Muse Glimmer搭配基于DFlash的轻量draft辅助模型,一次性生成一大段候选Token,主模型并行校验,接受正确内容、修正错误部分,大幅提升生成速度,输出质量保持不变。发布包也附带量化后的draft版本,进一步压低内存开销。
官方在 MacBook M4‑Max、M5‑Max、RTX‑5090 完成实测,K‑Quant‑17GB量化版本搭配draft模型,能够实现流畅对话与实时代理交互。
上手渠道与生态合作
现在就可以前往 Hugging Face 获取 Muse Glimmer 模型权重。
未来几天,Ollama、LM Studio、Unsloth 会支持一键运行;llama.cpp、ExecuTorch、MLX 负责边缘设备部署;vLLM、SGLang 支持大规模服务化部署;Together AI、Fireworks AI、OpenRouter 也提供托管调用渠道。开发者还能基于TorchTitan继续微调,做业务定制。
同时Meta正在联合 AMD、Arm、Dell、Intel、NVIDIA 开展硬件层面性能调优。完整开发文档已经放出,帮助开发者搭建自定义代理框架,相关资源可以前往Meta AI开发者中心查阅。
作为Meta开放AI研究的延续,Muse Glimmer把开放权重拓展到AI代理赛道,给开发者提供了搭建本地自主代理的新选择。而大家也可以继续等待,Muse Spark 1.2开放权重版本会在几周之后到来。
© 版权声明
文章版权归作者所有,未经允许请勿转载。