小米 MiMo × TileRT:在商用 GPU 上实现万亿参数模型每秒 1000+ Token 解码,通过 FP4 量化、DFlash 推测与微内核协同设计突破推理速度瓶颈
在大语言模型推理速度成为关键竞争指标的当下,小米 MiMo 团队联合 TileRT 系统团队发布了 MiMo-V2.5-Pro-UltraSpeed。该方案在单个标准的 8-GPU 商用节点上,实现了万亿参数规模模型解码速度超过 1000 tokens/秒(峰值近 1200),据称这是业界首次在商用硬件上达成此里程碑。这一突破并非依赖定制芯片,而是通过“极限模型-系统协同设计”,将 FP4 量化、DFlash 推测解码与 TileRT 运行时深度融合的结果。
- 官方介绍:https://mimo.xiaomi.com/blog/mimo-tilert-1000tps
- 模型:https://huggingface.co/XiaomiMiMo/MiMo-V2.5-Pro-FP4-DFlash
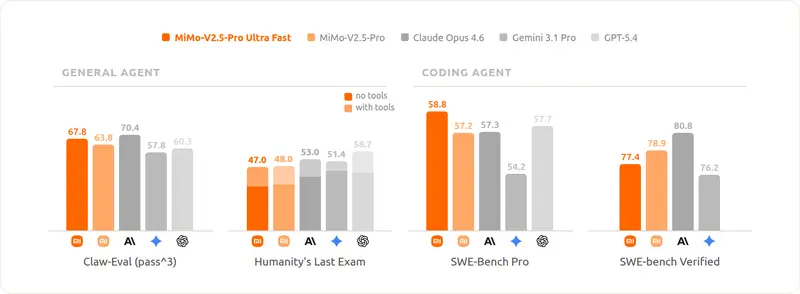
核心亮点:三层协同,极致加速
1. 选择性 FP4 量化 (MXFP4)
- 精准降维:针对占用大部分参数的 MoE 专家模块,采用 MXFP4 格式进行量化,显著降低内存带宽压力。
- 质量保全:其他模块保持高精度,并通过量化感知训练 (QAT),确保基准能力与原版模型基本持平。
2. DFlash 并行推测解码
- 打破串行瓶颈:传统推测解码中起草模型仍为串行生成。DFlash 引入块级掩码,使起草模型在一次前向传递中并行预测整个块(块大小限制为 8)。
- 高效验证:结合 Muon 二阶优化器与模型自蒸馏,在编码场景中平均接受长度达 6.30(即每轮 8 个猜测中有 6-7 个被主模型验证通过),实现无损加速。
- 恒定计算量:采用滑动窗口注意力,确保每次预测的计算复杂度不随上下文长度增加而膨胀。
3. TileRT 微秒级运行时
- 持久引擎内核:取代传统逐个启动算子的模式,使用常驻 GPU 的持久内核,消除算子启动间隙带来的微秒级延迟。
- Warp 特化分工:将数据移动、计算和通信划分为协同角色,专门优化 RMSNorm、RoPE 及 KV 缓存写入等在小操作下的瓶颈。
- 协同设计:TileRT 并非事后补丁,而是与 FP4 和 DFlash 共同设计的系统底座。
性能对比与权衡
| 维度 | MiMo-V2.5-Pro (标准) | MiMo-V2.5-Pro-UltraSpeed |
|---|---|---|
| 解码速度 | 基线 | ~10 倍提升 (>1000 TPS) |
| 硬件需求 | 商用 GPU | 商用 GPU (单 8-GPU 节点) |
| 推理成本 | 1x | 3x (每 Token 价格) |
| 权重精度 | 标准 (FP16/BF16) | FP4 (MoE 专家) + 高精度其余部分 |
| 解码方式 | 标准自回归 | DFlash 并行推测解码 |
| 访问方式 | 标准计划 | 仅限 API,基于申请试用 |
注:虽然单次 Token 成本上升,但由于速度提升 10 倍,单位时间内的吞吐量大幅增加,适合对延迟极度敏感而非单纯追求低成本批处理的场景。
局限与挑战
- 访问受限:目前仅通过基于申请的短期 API 试用开放,未完全公开。
- 成本考量:每 Token 价格为标准模型的 3 倍,需根据业务对延迟的敏感度评估 ROI。
- 场景差异:在开放式对话中,由于语境多变,DFlash 的接受长度可能下降,影响加速效果。
- 独立验证缺失:目前尚无独立的第三方速度验证报告公开。
对于需要极致响应速度的前沿 AI 应用而言,这是一次重要的技术探索。尽管成本有所上升,但它为实时交互、复杂 Agent 编排等高价值场景提供了新的可能性。随着技术的进一步成熟与开源社区的验证,这种协同优化思路或将推动整个行业推理效率的提升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。